
8.0
热点
AI SCORE
技术实践2026-09-29 06:22
用 Gemini Live API 构建实时语音 AI 代理
Google AI · DEV#Gemini#语音AI#API
Editor brief · 编辑速览
Google 详解 Gemini Live API 的双向实时语音交互原理,对比 TTS 单向方案,展示端到端实现路径。
我们每天都在和 AI 助手对话。想听某首歌时,动嘴比在手机上手动打字或戳音箱按钮要自然得多。
但这种体验和真正的实时语音 Agent 之间存在巨大差距——差距就在于「自然的对话动态」。
举例来说:
Me: "Hey, Mira, can you play something dream pop?" Live voice: "That sounds perfect." Me: [Interrupts] "Skip this one." Live voice: "Skipping it for you."
这才是实时语音 Agent。它在听、实时回应、你还可以在它说到一半时打断它——就像在打电话。大多数 AI 语音系统做不到这一点。下面来讲如何用 Gemini Live API 构建一个能做到这些的 Agent。
在动手之前,先铺垫一些背景知识。当下大多数 AI 助手用的是 Text-to-Speech(TTS)。TTS 的原理很简单:你给它文字,它返回一段音频作为回应。在这种模式下,它能「说话」,但不能像人一样「听到」你说话。
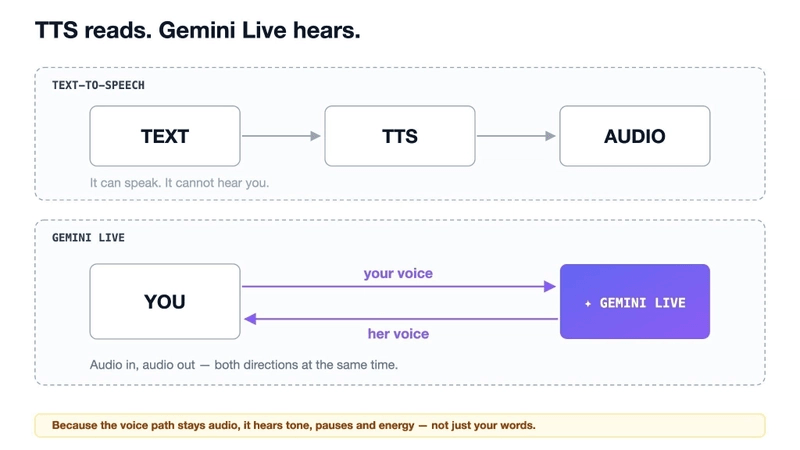
Gemini Live 采用音频到音频(audio-to-audio)模式,两个方向同时通信。它把你的声音作为原始音频来听,再用原始音频来回应。由于是原生音频输入,模型能感知语调、停顿、语速和抑扬顿挫。它甚至在还在组织答案的过程中就开始说话,而不是等到整段文字回应全部生成完毕。
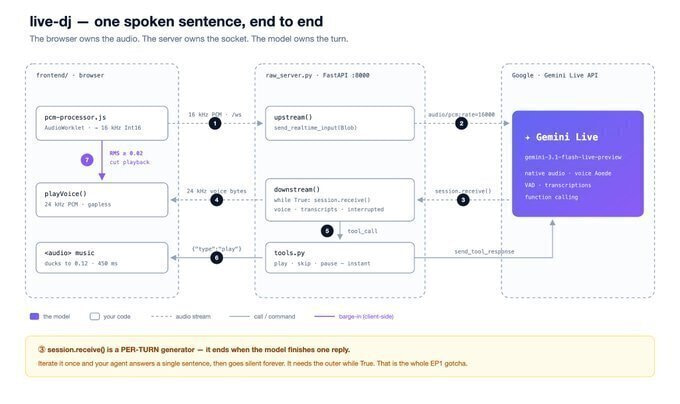
要用 Gemini Live API 来构建应用,你需要连接三个部分:
Browser client:捕获麦克风音频并播放回应。
Gemini Live API:处理实时音频、检测语音、生成语音的原生音频模型。
Python backend:一个轻量中继,维持与 Gemini 的持久连接,通过 google-genai SDK 传递音频。
浏览器和后端之间通过 WebSocket 通信。普通 Web 请求是发起一次请求然后关闭连接。WebSocket 则保持连接。借助这种持久连接,音频可以在两个方向上同时持续流动。
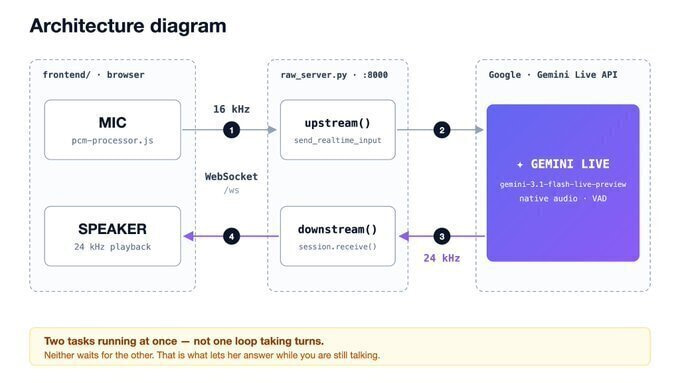
标准 HTTP 请求是发一次就关闭。实时语音通话需要一个开放的通道,让音频同时在两个方向上传输:把你的麦克风音频流式上传给 Gemini,同时接收 Gemini 的语音返回。
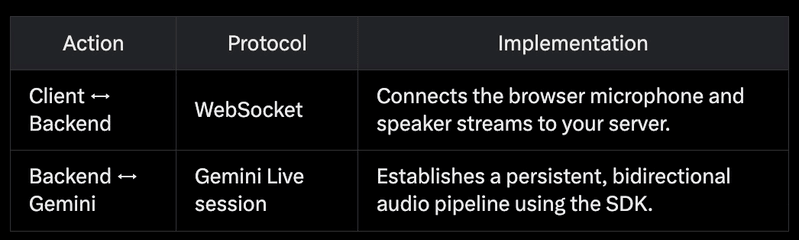
连接建立之后,你的后端同时运行两个循环,而非顺序执行。一个循环把麦克风音频推送给 Gemini,另一个循环把语音片段拉取过来并播放。两者互不等待对方的完成。正是这种并发机制让对话有了「实时感」,也是实现打断功能的根本前提。
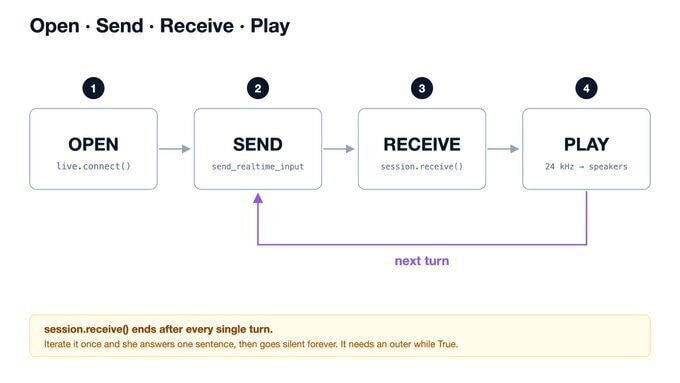
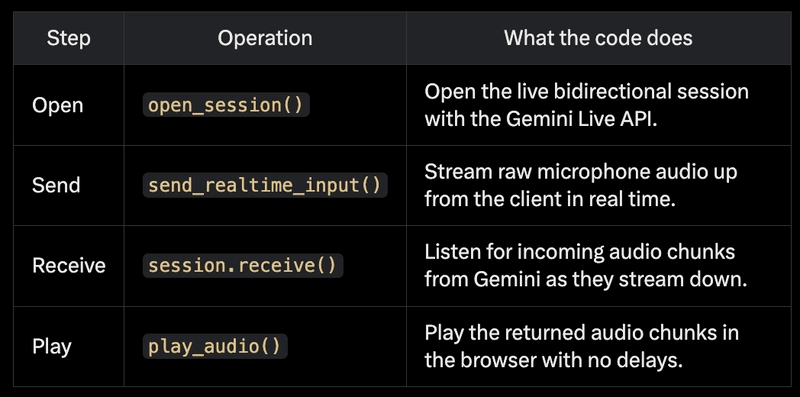
持续运行的四个操作:
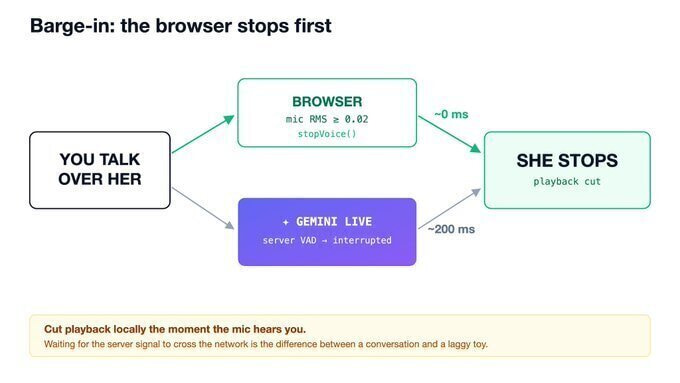
打断是整个构建过程中最难的部分,也直接决定了 Agent 给你「活的」感觉还是「语音菜单」的感觉。问题在于:模型只能在你开始说话的声音跨越网络、被处理完毕、信号返回之后,才能告诉你「被打断了」。等到那时,Agent 已经对着你讲了几百毫秒,那层自然感就消失了。
要让 Agent 的回应感觉像自然互动,模型需要知道你什么时候开始说话、什么时候停下来。这叫做语音活动检测(VAD),Gemini Live 已经内置了这一能力。
当内置 VAD 检测到你在模型正在输出音频时开口说话,模型会停止生成并发送一个中断信号。由于 VAD 在服务端自动处理,你的客户端需要持续流式传输音频——即使你安静时也要传——这样模型才能有一个稳定的基线来捕捉你开口的那一毫秒。
同样的 VAD 也是 barge-in(打断)功能的底层支撑,它帮助 Agent 在有人开始插话时立刻停下来。
不过,等待那个信号跨网络返回仍然会造成延迟。要让打断真正感觉像即时反应,你需要在麦克风检测到你说话的同一毫秒,就在浏览器里把本地播放缓冲区静音并清空。不要等待服务端的中断信号跨网络传回来。先切断本地音频,让模型自己慢慢赶上。
仅靠语音模型,它只能生成文字。它没法播歌单、跳过一曲或暂停音乐。要赋予 Agent 这些能力,你需要挂载工具(Tool)。
工具是代码中的一个函数,有名称、描述和参数。例如:
当模型判断需要执行某个动作时,它会输出一个包含从你的语音中提取出的参数的 tool call。你的后端代码执行该函数,并把结果回报给模型。
但语音交互有一个严格的约束:工具慢 = 静音的 Agent。
当工具运行时,模型会暂停语音生成来等待结果。如果一个工具发起外部 API 请求花了三秒,你的 Agent 就会停止说话,造成尴尬的冷场。
为了保持对话流畅,实现异步 fire-and-acknowledge(触发即确认)模式:
当 play_playlist 这样的工具被触发时,异步分派缓慢的回放动作。
立刻返回一个即时的确认码或收据(例如 {"status": "success"})给模型。
模型收到这个即时的成功收据后,继续无缝地说话(即「Skipping it for you」),而实际的音乐播放在后台悄然开始。
用原始 Gemini Live API 构建实时语音 Agent,解锁了标准链式 TTS 流水线无法复制的低延迟、原生音频能力,帮助你打造以自然、会话式方式交互的语音 Agent。
查看完整代码并自己运行演示。在 GitHub 仓库中找到我们深夜电台 DJ 语音 Agent「Mira」的完整实现。