
8.0
热点
AI SCORE
技术实践2026-10-18 12:42
十万向量实测:RAG 数据库如何选
dev.to · AI#RAG#向量数据库#性能测试
Editor brief · 编辑速览
作者在同一机器上用十万条 1536 维向量测试 pgvector 与 Qdrant,比较召回率、延迟、建索引时间和过滤搜索。Pinecone 仅依据官方文档讨论,文章同时分析已有 PostgreSQL 是否足以承载 RAG。
我把同样的 100,000 条 OpenAI embedding 分别导入 pgvector 和 Qdrant,测量了召回率、延迟、索引构建时间和带过滤条件的搜索性能。Pinecone 部分仅依据文档介绍,因为我没有实际运行测试。原文及后续更新发布在 fabwaseem.com。
pgvector 是一个 PostgreSQL 扩展,可以把 embedding 存进向量列,通过 HNSW 或 IVFFlat 索引进行搜索,与普通数据表放在一起。Qdrant 是一个开源向量数据库,既可以自行部署,也可以使用托管云服务。Pinecone 则是完全托管的 serverless 向量数据库,只能通过 API 访问。
对于 RAG 应用,真正的问题是:你究竟需不需要一个独立的向量数据库?我在同一台机器上,把同样的 100,000 条 OpenAI embedding(1,536 维)分别导入运行在 PostgreSQL 18.6 上的 pgvector 0.8.7,以及 Qdrant 1.19.2,然后测量召回率、延迟、构建时间和带过滤条件的搜索性能。Pinecone 部分只依据官方文档及其限制说明,因为我没有运行过它,也不会为它编造测试数据。
如果已经在用 Postgres,向量规模不超过几百万条,就从 pgvector 开始。只需一个数据库,就能使用 SQL join、事务,以及现成的备份机制。如果向量搜索是核心工作负载,需要在每毫秒内获得尽可能高的召回率,或者需要大量过滤操作,就选择 Qdrant。如果希望完全不用管理基础设施,并且接受按用量计费的托管服务,就选择 Pinecone。
通常一开始不需要。如果应用已经使用 PostgreSQL,pgvector 就能直接添加向量搜索能力,无须再部署、保护、备份和同步第二套系统。在我的测试中,它对 100,000 条 OpenAI embedding 执行 top-10 查询,只需 1.5–4 ms,召回率为 95–99%。当规模非常大、过滤负载很重,或者搜索负载需要独立扩容时,专用向量数据库才开始体现价值。
独立向量存储的隐性成本是同步。每次插入、更新和删除文档,都必须同步到两个系统;一旦写入失败,两边的数据就会不一致。使用 pgvector,embedding 与它描述的文档位于同一行,也处于同一个事务中。
pgvector 是一个开源 PostgreSQL 扩展,增加了 vector、halfvec、bit 和 sparsevec 类型,提供 <=>(cosine)和 <->(L2)等距离运算符,以及 HNSW、IVFFlat 近似索引。根据 pgvector README,默认情况下,它“执行精确最近邻搜索,提供完美召回率”。使用索引,则是牺牲一点召回率来换取速度。
CREATE EXTENSION vector;

CREATE TABLE documents (
  id        bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  tenant_id int NOT NULL,
  content   text NOT NULL,
  embedding vector(1536) NOT NULL
);

CREATE INDEX ON documents USING hnsw (embedding vector_cosine_ops);

-- top 5 chunks for a question, inside one tenant
SELECT id, content
FROM documents
WHERE tenant_id = $1
ORDER BY embedding <=> $2
LIMIT 5;
选择模型时,要注意索引的维度限制。HNSW 可以索引“最多 2,000 维”的 vector,以及“最多 4,000 维”的 halfvec。像 text-embedding-3-large 这样的 3,072 维模型,需要使用 halfvec 索引,或者缩短输出维度。
Qdrant 是一个用 Rust 编写的开源向量搜索引擎。它存储 point,也就是向量加上一份 JSON payload;为每个 segment 构建 HNSW 索引,并通过 payload 索引,让过滤在图搜索内部执行。你可以运行独立二进制文件、使用 Docker,或者使用 Qdrant Cloud。
Pinecone 是一个托管的 serverless 向量数据库。根据其架构文档,“所有向量数据都存储在高效的分布式对象存储中”。Pinecone“将写入和读取操作分离到不同路径,各自根据需求独立扩容”。它没有可自行部署的版本。
数据。 使用公开 DBpedia OpenAI embeddings 数据集的前 100,000 行:由 text-embedding-ada-002 生成的 1,536 维 Wikipedia 实体向量,是典型的 RAG 数据形态。从同一数据集中另外留出 1,000 行作为查询。
标准答案。 使用 NumPy,为每条查询计算精确的 cosine top-10。Recall@10 表示各引擎返回了这 10 个标准结果中的多少比例。
机器。 一台 8 vCPU、15 GB 内存的 Linux 机器,所有服务都在 localhost 上运行,没有使用 Docker。
pgvector。 PostgreSQL 18.6 搭配 pgvector 0.8.7,配置为 shared_buffers = 2GB、maintenance_work_mem = 2GB。HNSW 使用默认参数(m = 16、ef_construction = 64),通过 psycopg 3 的二进制 COPY 导入数据。
Qdrant。 使用 Qdrant 1.19.2 发布的二进制文件,采用 cosine 距离,设置 m = 16、ef_construct = 64,与 pgvector 保持一致。使用默认 optimizer 设置,最终生成了 4 个 segment。通过单个进程,使用官方 Python client 经 gRPC 导入数据。
查询。 单个 client 顺序执行,先运行 50 条预热查询,再对 1,000 条查询计时。两边的延迟都包含 Python client 的往返时间。
过滤条件。 为每个向量随机分配一个 0 到 9 的 category,每类约占总行数的 10%。带过滤条件的查询要求返回某个 category 内的 top 10。
够快,在这个规模下,两个引擎都很快。默认设置下,pgvector 的 recall@10 为 0.948,延迟中位数为 1.45 ms;设置 hnsw.ef_search = 200 后,召回率达到 0.988,延迟为 4.0 ms。Qdrant 在延迟中位数为 2.6 ms 时,召回率达到 0.985;在 5.4 ms 时达到 0.999。在召回率大致相同的情况下(约 98.5–98.8%),Qdrant 约快 1.5 倍:2.6 ms 对 4.0 ms。
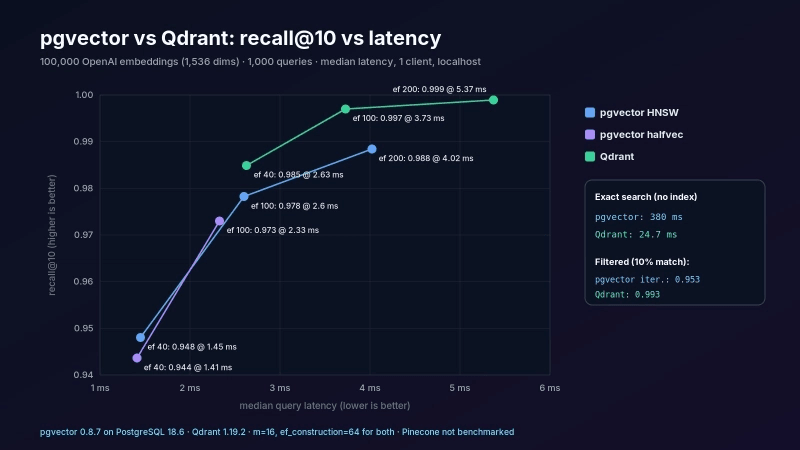
为什么在相同 ef 下,Qdrant 的召回率更高?因为它会把 collection 拆分成多个 segment,本次测试中是 4 个,并在每个 segment 上都使用该 ef 进行搜索,因此总共探索的候选项更多。比较引擎时,应该对齐召回率,而不是对齐参数。
Qdrant 的索引构建更快:从首次上传到整个 collection 完成索引构建,共耗时 30.8 秒,其中单个 Python 进程上传数据耗时 20.2 秒。pgvector 通过 COPY 导入数据耗时 3.9 秒,随后使用默认的 2 个并行 worker 构建 HNSW 索引,耗时 69.1 秒。
可以在 pgvector 中使用 halfvec 这个技巧:为 embedding::halfvec(1536) 建立索引,可以把索引体积从 781 MB 减半至 391 MB,代价是召回率下降约半个百分点(在 ef_search = 100 时,从 0.978 降至 0.973)。查询时也要使用相同的类型转换:
CREATE INDEX ON documents
  USING hnsw ((embedding::halfvec(1536)) halfvec_cosine_ops);

SELECT id FROM documents
ORDER BY embedding::halfvec(1536) <=> $1::halfvec(1536)
LIMIT 10;
Qdrant 对过滤的处理最好。在 category 上建立 payload 索引后,带过滤条件的 top-10 查询召回率达到 0.993,延迟中位数为 2.1 ms。pgvector 则会随着 Postgres 选择的执行计划不同,出现三种差异很大的结果,因此你需要了解它的过滤机制。
因为 HNSW 是在索引扫描之后才执行过滤。README 中解释道:“如果某个条件匹配 10% 的行,使用 HNSW 和默认的 hnsw.ef_search 值 40 时,平均只有 4 行能匹配。”我实测的结果是 3.92 行。从 pgvector 0.8.0 开始,迭代索引扫描会持续遍历图,直到找到足够多的匹配行。
-- once per session or per transaction (SET LOCAL)
SET hnsw.iterative_scan = relaxed_order;

SELECT id, content FROM documents
WHERE tenant_id = $1
ORDER BY embedding <=> $2
LIMIT 10;
对于筛选范围较小的过滤条件,Postgres 往往会自行选择精确搜索的执行计划。在我的测试中,它使用了 category 的 B-tree 索引,并对大约 10,000 行进行精确排序:召回率达到 100%,但耗时为 44 ms,而不是约 3 ms。对于只有几千个 chunk 的单个租户,这完全可以接受。对于大租户,应检查 EXPLAIN 并开启迭代扫描。如果某个过滤条件占据主要查询量,可以考虑部分索引,或者按租户分区。
完全托管的 serverless 扩缩容,无须自行运行任何服务。读写可以独立扩容,数据保存在对象存储中,也永远不用调节 ef 或 m。相应的取舍在文档中有明确说明:
最终一致性。 已知限制页面写道:“Pinecone 采用最终一致性,因此 upsert 后的记录可能需要稍等片刻才能被查询到。”
操作限制。 根据操作限制文档,稠密向量最多支持 20,000 维,每条记录可包含 40 KB 用于过滤的 metadata,每批 upsert 最多 1,000 条记录或 2 MB,top_k 最大为 10,000。
套餐。 对象限制文档说明,免费的 Starter 套餐提供 2 GB serverless 存储,每个项目最多 5 个索引,全部位于 AWS us-east-1。Pinecone 定价页面列出的 Standard 套餐最低消费为每月 50 美元。
网络跳转。 每次查询都要离开你的 VPC。除了搜索本身的耗时,还应计入所在云区域的网络往返时间。我在 localhost 上测得的延迟不能与 Pinecone 相比,而且我也没有测试它。
根据你已经在运行的系统,以及主要工作负载来决定。对于产品团队,pgvector 是一个很有竞争力的默认选择。等测量结果表明确实需要迁移时再迁移。
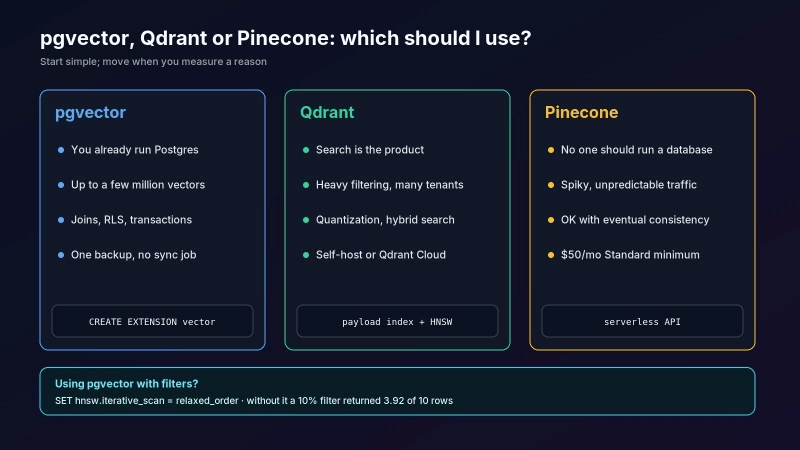
当数据已经存放在 Postgres 中,需要对 embedding 使用 join、行级安全或事务,并且每个索引的向量规模不超过几百万条时,选择 pgvector。如果索引体积超出了 RAM,可以添加 pgvectorscale(StreamingDiskANN)。
当搜索就是产品本身时,选择 Qdrant:向量规模达到几千万条、过滤条件很多、需要多向量或混合搜索,或者需要通过量化减少内存占用。它的量化指南指出,标量量化可以“以极小的精度损失实现 4 倍压缩”。
当团队不想安排任何人运维数据库、流量波动大,而且能接受按用量付费和最终一致性时,选择 Pinecone。
从第一天起,就让 embedding 和 ID 保持可迁移性。在两个系统中使用相同的主键,为每行数据保存 embedding 模型名称和维度,并编写一个按 ID 流式读取数据的重新同步任务。Qdrant 的 point ID 支持整数或 UUID,因此 UUIDv7 主键可以直接映射过去。
随后让两个系统并行运行,使用一组固定的真实查询比较召回率。先切换读取,再停止向 Postgres 写入。
把 3,072 维向量按 vector 类型建立索引。 HNSW 对 vector 的支持上限是 2,000 维。应使用 halfvec,或者缩小输出维度。
忘记开启迭代扫描。 pgvector 中带过滤条件的 HNSW 查询,可能悄悄返回少于 LIMIT 指定数量的行。
使用相同参数比较不同引擎。 ef 在不同引擎中代表的实际工作量不同。应该在相同召回率下进行比较。
用随机向量测量召回率。 应使用模型生成的真实 embedding。随机数据会掩盖图的质量差异。
导入数据后才创建 Qdrant payload 索引。 索引文档指出,应在导入数据之前创建 payload 索引,这样才能构建能够感知过滤条件的 HNSW 边。
忽略重新生成 embedding 的成本。 无论使用哪种存储,切换 embedding 模型都意味着要为全部数据重新生成 embedding。
如果你想找一个能直接运行的起点,我的开源 Next.js AI starter kit——Forgekit,已经内置了基于 pgvector 的 RAG。如果想把 Postgres 或 Qdrant 与应用一起自行部署,可以参阅使用 Coolify 自行部署 Next.js 的文章。
在 100,000 条 OpenAI embedding 上,pgvector 0.8.7 使用默认配置时,recall@10 为 0.948,延迟为 1.45 ms;将 ef_search 设为 200 后,召回率达到 0.988,延迟为 4.0 ms。
Qdrant 1.19.2 在 2.6 ms 时达到 0.985 的召回率,在召回率大致相同的情况下,比 pgvector 快约 1.5 倍。
pgvector 的 HNSW 在扫描之后执行过滤:当过滤条件匹配 10% 的数据时,在开启迭代扫描之前,要求返回 10 行,实际平均只返回 3.92 行。
在我的测试中,Qdrant 的 payload 索引带来了最好的过滤搜索表现:召回率为 0.993,延迟为 2.1 ms。
halfvec HNSW 索引把 pgvector 的索引体积减半,从 781 MB 缩小到 391 MB,代价是召回率下降约半个百分点。
Pinecone 采用 serverless 架构和最终一致性,支持 20,000 维向量,Standard 套餐最低消费为每月 50 美元。
如果已经在使用 Postgres,就从 pgvector 开始;等测量结果表明确实有需要,再迁移到 Qdrant 或 Pinecone。
对于向量规模不超过几百万条的大多数 RAG 应用,可以。在我对 100,000 条 OpenAI embedding 的测试中,pgvector 在延迟中位数为 4.0 ms 时达到 0.988 的 recall@10;Qdrant 则在 2.6 ms 时达到 0.985。在相同召回率下,Qdrant 快约 1.5 倍,而且带过滤条件的搜索表现更好;但 pgvector 可以让 embedding 与业务数据保存在同一个支持事务的数据库里。
通常一开始不需要。如果应用已经使用 PostgreSQL,pgvector 扩展就能增加向量列和 HNSW 索引,无须再部署、备份和同步第二套系统。当向量规模达到几千万条、需要在低延迟下执行大量过滤,或者需要对搜索独立扩容时,再考虑专用向量数据库。
因为 pgvector 的 HNSW 索引是在扫描索引之后才应用 WHERE 过滤条件。当过滤条件匹配 10% 的行,且使用默认的 ef_search 值 40 时,平均只有约 4 行能匹配;我实测为 3.92 行。可以把 hnsw.iterative_scan 设置为 relaxed_order 或 strict_order,让扫描持续进行,直到找到足够多的匹配行。这项功能从 pgvector 0.8.0 开始提供。
pgvector 的 HNSW 和 IVFFlat 索引,对 vector 类型最多支持 2,000 维,对 halfvec 最多支持 4,000 维,对 bit 最多支持 64,000 维。对于 text-embedding-3-large 这样的 3,072 维模型,应将该列以 halfvec 形式建立索引,或者请求更小的输出维度。Pinecone 支持最高 20,000 维的稠密向量。
在我的单机测试中,相同召回率下确实如此。Qdrant 1.19.2 在延迟中位数为 2.6 ms 时达到 0.985 的 recall@10,而 pgvector 在 4.0 ms 时达到 0.988。Qdrant 为 100,000 条向量建立索引耗时约 31 秒,pgvector 的 HNSW 构建则耗时 69 秒。使用默认设置时,pgvector 单次查询更快,但召回率更低:1.45 ms,召回率为 0.948。
Pinecone 提供免费的 Starter 套餐,包含 2 GB serverless 存储,每个项目最多 5 个索引,全部位于 AWS us-east-1。根据 Pinecone 定价页面,面向生产环境的 Standard 套餐最低消费为每月 50 美元,之后按实际用量计费。Qdrant 的开源版本和 pgvector 都可以免费自行部署。
halfvec 是 pgvector 的半精度向量类型,每个维度占用 2 字节,而不是 4 字节。为 embedding::halfvec(1536) 这样的表达式建立索引,可以把 HNSW 索引体积减半;在我的测试中,索引从 781 MB 缩小到 391 MB,召回率从 0.978 降至 0.973。它还把可索引的维度上限提高到了 4,000 维。
是的。Pinecone 文档明确指出,它采用最终一致性,因此 upsert 后的记录可能需要稍等片刻才能被查询到,并建议检查索引统计信息来确认记录数量。pgvector 的写入具有事务性,提交后即可见;Qdrant 使用 wait=true 发送的 upsert,则会在调用返回前完成应用。
最初发布于 fabwaseem.com。
如需进一步处理,你可以考虑屏蔽此人和/或举报滥用行为。