
8.0
热点
AI SCORE
开源项目2026-10-18 16:15
谷歌开源可在测试时改写执行框架的 Harness2
MarkTechPost#谷歌#Agent#开源
Editor brief · 编辑速览
Google Research 发布 Apache-2.0 授权的 Harness2,允许 Agent 在测试时改写自身执行框架。报道显示,无需更新模型权重,一次改进便使 GLM-5 在 WorkBuddy-Bench 上提升 11.5 个点。
人工智能
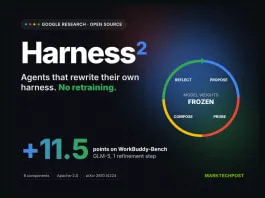
Google Cloud AI Research 已开源 Harness²。这是一个递归式 Agent harness 优化框架,通过改进冻结模型外围的代码和文件来提升表现。对开发者来说,它的卖点很简单:不换更强的模型,你的 Agent 也可能变得更好。
规模:这是框架,不是模型。训练参数量为 0;提供 8 个可编辑的 harness 组件。版本为 0.1.0。
运行环境:Linux,配合 Python 3.12 或 3.13 以及 uv。需要模型的运行通过 Vertex AI 调用模型。GPU 要求:未披露。
性能:只进行 1 步优化,就让全部 4 种模型与 harness 组合在全部 3 个 benchmark 上都获得了提升。
最佳表现:OpenCode 下的 GLM-5 在 WorkBuddy-Bench 上从 64.2 提升至 75.7,增加了 11.5 分。
最小提升:Codex 下的 GLM-5 在 JobBench 上仅提升 1.2 分,从 23.6 升至 24.8。
Harness² 是 Google Research 推出的即插即用框架,可在部署期间优化 Agent 的 harness。harness 指模型外围的整套系统,包括 prompt、工具、记忆、skills 和编排逻辑。Harnessing 就是优化这套系统的过程。模型权重始终不变。
它面向的是开放世界场景:不断有未见过的任务到来,也没有验证器告诉你答案是否正确。研究团队认为,大多数自我改进方法都假设存在标签或测试用例,而 Harness² 的设计目标是在没有这些条件的情况下也能工作。
Harness² 开放了 8 个可编辑组件,每个组件都以文件形式挂载:
这些组件涵盖上下文构建、工具接口、任务委派,以及工具循环内的行为。这一布局在此前 Agentic Harness Engineering 工作提出的 7 文件划分基础上,增加了 1 个组件。
框架运行两个相互关联的递归层级:
任务级递归采用具有对比性的 Propose、Probe、Compose 步骤。首先,Agent 使用基础 harness 执行一次任务。随后,editor 提出 2 个候选方案。通用候选方案针对规划或工具使用等常见 Agent 问题;领域候选方案则针对当前领域的知识和操作流程。两个候选方案都会在同一个任务上运行。composer 将它们的执行轨迹与参考轨迹进行比较,只保留有实际观测行为支持的修改。
Harness 优化级递归发生在每个任务结束后。reflector 会保存已采纳的 harness,以及记录经验教训的 EXPERIENCE.md 文件。这个经验库会指导后续的候选方案生成。不过,每个新任务仍然从基础 harness 开始。
预算 k 决定搜索规模。并行模式会探测 k 个通用候选方案和 k 个领域候选方案,然后进行 k 次组合。串行模式则依次执行 k 步优化。
研究团队测试了 3 个专业 benchmark:WorkBuddy-Bench、JobBench 和 Harvey’s LAB。执行模型为 Gemini 3.5 Flash 和 GLM-5,分别运行在 OpenCode 和 Codex 下。默认 editor 为 Claude Opus 4.8。结果取 3 次运行的平均值。
| 配置(单步,k=1) | WorkBuddy 平均分 | JobBench | LAB 部分得分 |
|---|---|---|---|
| Gemini 3.5 Flash,OpenCode | 72.4 → 77.5 | 31.5 → 36.0 | 79.9 → 81.9 |
| Gemini 3.5 Flash,Codex | 74.5 → 77.5 | 33.9 → 35.3 | 71.6 → 75.6 |
| GLM-5,OpenCode | 64.2 → 75.7 | 20.6 → 24.2 | 59.6 → 71.4 |
| GLM-5,Codex | 64.4 → 75.3 | 23.6 → 24.8 | 58.1 → 65.9 |
来源:Harness² 论文,表 1 和表 2。
较弱的执行模型获益更多。仅优化 1 步后,GLM-5 在 WorkBuddy-Bench 上就超过了基础配置的 Gemini 3.5 Flash。当 k=5 时,并行递归将 OpenCode 下 Gemini 的 WorkBuddy 得分提升至 80.8。在 WorkBuddy-Bench 上,4 种配置中还有 3 种减少了每个任务所需的步骤数。OpenCode 下 Gemini 的步骤数从 25.4 降至 21.9。
| 特性 | Harness² | Meta-Harness | ReasoningBank | Harness Scaling |
|---|---|---|---|---|
| 开发团队 | Google Cloud AI Research、Northwestern | Stanford IRIS Lab 及合作者 | Google Research 及合作者 | Wang 等人 |
| 修改对象 | 按任务修改完整的 8 组件 harness | 通过离线搜索修改 harness 代码 | 检索出的记忆;harness 固定 | 按实例修改 harness |
| 是否需要训练集划分 | 否 | 是 | 否 | 否 |
| 是否跨任务学习 | 是,使用经验库和经验教训 | 部署 1 个最佳 harness | 是,使用记忆 | 否 |
| 代码许可证 | Apache-2.0 | MIT | 未披露 | 未披露 |
| WorkBuddy 平均分,Gemini/OpenCode* | 77.5(k=5 时为 80.8) | 76.4 | 73.4 | 75.3 |
| JobBench,Gemini/OpenCode* | 36.0 | 35.8 | 30.8 | 32.9 |
| LAB 部分得分,Gemini/Codex* | 75.6 | 76.5 | 74.8 | 67.9 |
*这些分数由 Harness² 论文测得;其他方法本身并未报告在这些 benchmark 上的结果。
README 面向 Linux、Python 3.12 和 uv。下面的本地 demo 无需模型凭据,就能运行两种递归模式:
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install -e '.[render]'
harness2-demo --output runs/demo --k 2
接入模型运行时,需要 Node.js 20+、Google Cloud CLI 和一个 Vertex AI 项目。LAB 需要 Pandoc 和 Poppler。WorkBuddy-Bench 需要 Docker。默认执行环境为 OpenCode,也可以通过 --substrate cx 使用 Codex。
Harness² 在测试时重写 Agent 的 harness,模型权重保持冻结。
仅优化 1 步,就让 GLM-5 在 WorkBuddy-Bench 上提升了 11.5 分。
Propose、Probe、Compose 用行为对比取代真实标签。
经验教训库将改进经验传递给后续任务。
每个任务都需要额外运行,请自行配置沙箱。
欢迎查看论文、GitHub 仓库、论文和项目页面。所有成果归功于本项目的研究人员。也欢迎在 Twitter 上关注我们,别忘了加入我们拥有 150k+ 成员的 ML SubReddit,并订阅我们的 Newsletter。等等!你用 Telegram 吗?现在也可以在 Telegram 上加入我们。
Asif Razzaq 是 Marktechpost AI Media Inc. 的 CEO。作为一名富有远见的创业者和工程师,Asif 致力于发挥人工智能的潜力,推动社会公益。他最近的一项事业是推出人工智能媒体平台 Marktechpost。该平台深入报道机器学习和深度学习新闻,既保证技术准确性,又让广大读者易于理解,因此脱颖而出。平台每月浏览量超过 200 万,体现了它在读者中的受欢迎程度。