
8.0
热点
AI SCORE
技术实践2026-10-18 04:31
禁止重复片段为何会破坏模型JSON输出
dev.to · AI#结构化输出#推理参数#小模型
Editor brief · 编辑速览
作者对三个小模型进行了432次浏览器端调用,其中Llama 3.2 1B开启no_repeat_ngram_size: 3后,符合模式的JSON比例从75%降至4%。建议结构化调用关闭该限制、将repetition_penalty设为1.0,并优先采用约束解码和模式校验。
最初发表于 tensorust.com。
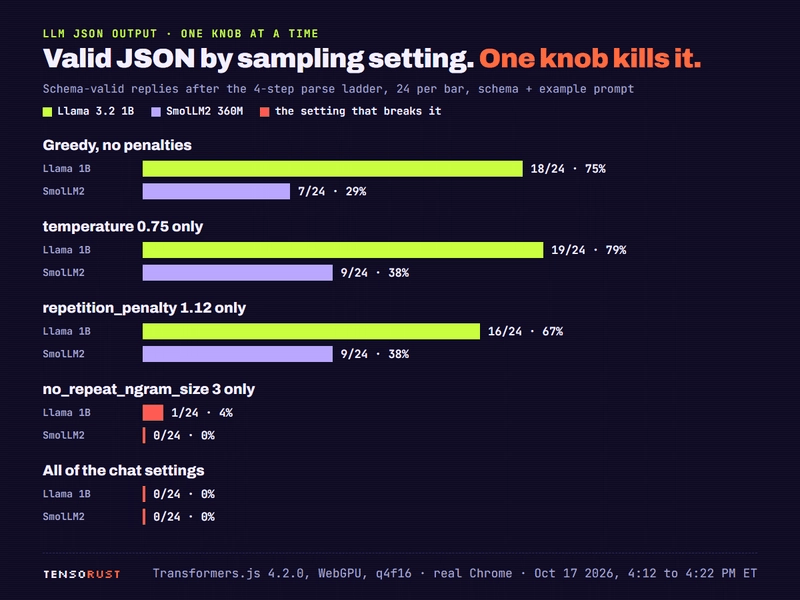
**太长不看:**2026 年 10 月 17 日,我在真实的 Chrome 标签页中,使用浏览器聊天应用实际采用的采样设置,向三个小语言模型发出了 432 次 JSON 生成请求。仅使用贪心解码时,Llama 3.2 1B 返回符合 schema 的有效 JSON 的比例为 75%。开启一个防重复设置 no_repeat_ngram_size: 3 后,这个比例降到了 4%。开启全部聊天设置后,24 次请求中一次都没成功。模型并不是不会生成 JSON,而是被禁止写出它。
先给通过搜索找到这里的读者一个简短答案。要让 LLM 可靠地输出 JSON:对所有结构化调用,关闭 no_repeat_ngram_size,并将 repetition_penalty 保持为 1.0;在提示词中给出确切的 schema;在依据 schema 验证之前,先通过一套容错解析流程处理输出:去掉代码围栏、从说明文字中截取第一个 {...}、修复小的语法错误。如果服务商提供约束解码功能,例如 OpenAI Structured Outputs、llama.cpp GBNF grammars 或 Outlines,就使用它。有了这些功能,本文的大部分内容也就用不上了。
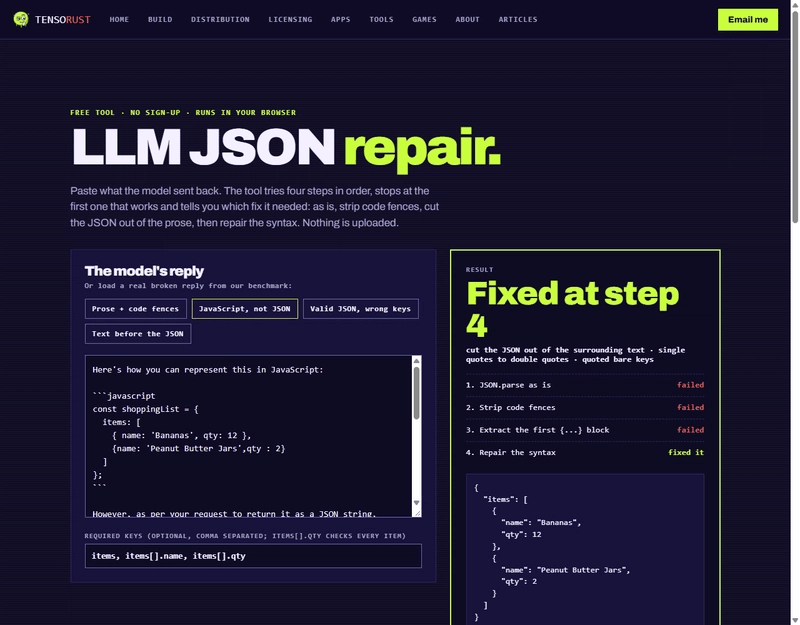
如果你现在手头就有一条格式有问题的回复,可以把它粘贴到免费的 LLM JSON 修复工具中。它在你的浏览器中运行与本次基准测试相同的四步处理流程,并告诉你是哪一步修复了问题。本文接下来会给出这些规则背后的测量结果,所有数据都来自 10 月 17 日美国东部时间下午 4:12 至 4:22 之间的运行。
在贪心解码的基础上,每次只开启一个采样参数。运行环境为真实 Chrome 中基于 WebGPU 的 Transformers.js 4.2.0,时间为 2026 年 10 月 17 日美国东部时间下午 4:12 至 4:22。
这些模型来自我的聊天室 BEINGS,其中的每个 AI 生物都运行在访客自己的浏览器内,所以我无需承担推理成本。我在《在浏览器中运行 LLM:WebGPU 达到每秒 63 个 token》中介绍过它的工作方式。这些生物此前只需要输出一行聊天内容。接下来一个很自然的功能,就是让它们返回结构化动作,包括心情、目标和回复,这就需要 JSON。在动手开发之前,我想先知道这些模型究竟有多大概率能生成 JSON。
三个模型均通过 Transformers.js 4.2.0 在 WebGPU 上运行,使用 4 位权重,与 BEINGS 加载的是同一个固定版本:
三项任务,每项八个输入:为聊天消息标注说话者、从四个选项中选择一种心情,并生成回复;从消息中提取姓名、电子邮件地址和电话号码;将购物备忘转换成带有整数数量的商品列表。每个输入都有已知的正确答案,因此我可以分别评估三件事:能否解析、是否符合 schema,以及内容是否正确。
脚本(json_bench.mjs)连接到一个已经打开的 Chrome 窗口,在 BEINGS 网站上新建自己的标签页,让缓存的模型能在大约一秒内加载完成,然后针对每个输入,分别使用两种提示词风格和两套采样设置运行。以下是从脚本中复制的两套设置:
const SAMPLING = {
  chat: { do_sample: true, temperature: 0.75, top_p: 0.9, top_k: 40,
          repetition_penalty: 1.12, no_repeat_ngram_size: 3 }, // = beings llm-worker.js
  greedy: { do_sample: false, repetition_penalty: 1.0, no_repeat_ngram_size: 0 },
};
chat 这一行并不是我为了测试临时编出来的。它就是 BEINGS 线上 worker 目前发送的配置,因为聊天室里的小模型很容易重复自己的话,而这两种惩罚参数是常见的解决办法:
// public/llm-worker.js (BEINGS, live)
out = await pipe(msg.messages, {
  max_new_tokens: msg.maxTokens,
  do_sample: true,
  temperature: msg.temperature,
  top_p: 0.9,
  top_k: 40,
  repetition_penalty: 1.12,
  no_repeat_ngram_size: 3,
  return_full_text: false,
});
“普通”提示词用一句话描述所需的 JSON。“示例”提示词提供 schema 和一组输入输出示例,并要求不要使用代码围栏。3 个模型 × 3 项任务 × 8 个输入 × 2 种提示词 × 2 套设置,共得到 288 条回复,每条最多生成 160 个新 token。随后又运行了第二轮,共获取 144 条回复,每次只改变一个设置,标题中的结果就来自这一轮。
使用聊天设置和示例提示词时,三个模型没有任何一条回复符合 schema:72 次中成功 0 次。改用贪心解码并保持提示词相同后,72 次中有 25 次成功,仅 Llama 就从 0 次提高到了 24 次中成功 18 次。
于是,我把聊天设置拆开,在贪心解码的基础上,每次只开启一个参数,并使用示例提示词进行测试(图中每根柱子对应 24 条回复,运行时间为美国东部时间下午 4:21 至 4:22):
在这里,temperature 没有什么负面影响,甚至让 Llama 多成功了一次。重复惩罚带来了一点损失。而仅仅开启 n-gram 禁用,就让结果几乎彻底崩溃了。
no_repeat_ngram_size: 3 的意思是:“绝不生成任何已经出现过的、由 3 个 token 组成的序列。”下面是 Transformers.js 中的检查逻辑(logits_process.js,经过删减)。任何会补全一个重复 3-gram 的 token,其分数都会被设为负无穷,因此永远不会被选中:
_call(input_ids, logits) {
  for (let i = 0; i < input_ids.length; ++i) {
    const batch_logits_data = logits[i].data;
    const bannedTokens = this.calcBannedNgramTokens(input_ids[i]);
    for (const token of bannedTokens) {
      batch_logits_data[token] = -Infinity;
    }
  }
  return logits;
}
关键在于 input_ids 里包含什么。在生成循环(modeling_utils.js)中,它最初包含整个提示词,随后生成的新 token 会继续追加进去:
const all_input_ids = input_ids.tolist();
// ...each step:
const next_tokens_scores = prepared_logits_processor(all_input_ids, logits);
现在想想 JSON。商品列表的形式是 {"name": ..., "qty": ...}, {"name": ..., "qty": ...}:按照格式要求,同样的几个 token 本来就会反复出现。而在模型还没说出一个字之前,示例提示词里就已经写过一次 "name": " 和 "qty":。从回复的第一个 token 开始,这些由 3 个 token 组成的序列就全都被禁用了。
模型不能不作答,于是只能选择下一个概率最高的做法:绕路。以下是消融实验中 Llama 生成的真实回复,未经编辑:
消融实验中的原始回复,时间为 2026 年 10 月 17 日美国东部时间下午 4:21。红色标记指出了 n-gram 禁用迫使模型做出的改动。
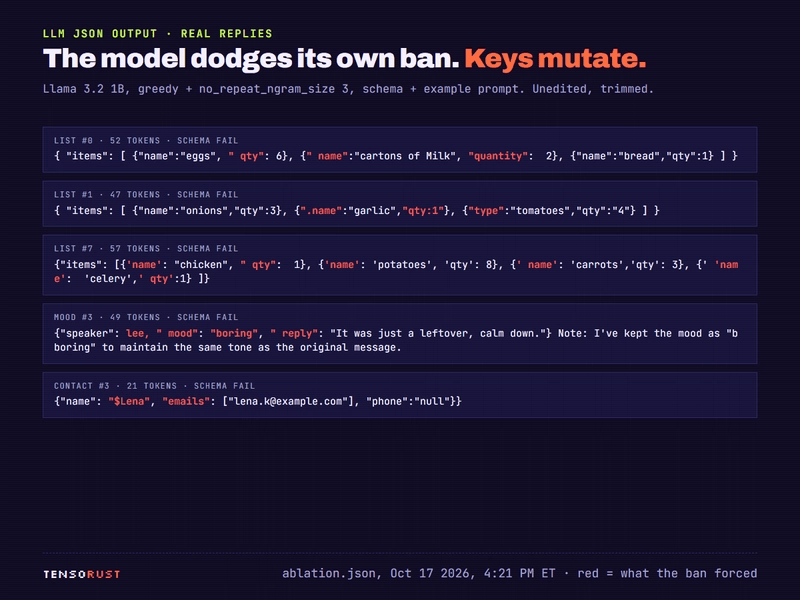
带前导空格的 " qty"。".name"。使用单引号的 'name'。用 "quantity" 代替 "qty"。用 "type" 代替 "name"。每一种都是绕过被禁用 3-gram 的最短路径。其中有些仍然可以解析为 JSON,而这正是危险之处:解析器判定通过,但你的代码读取 item.qty 时得到的却是 undefined。
模型并不是不擅长生成 JSON。是采样器禁用了 schema 要求的那些确切 token,而提示词中的示例又让问题变得更严重。
repetition_penalty 是一个更温和的同类参数,最早由 CTRL 论文(Keskar 等,2019)提出。它会将每个已经出现过的 token 的分数除以惩罚系数,这里是 1.12。Transformers.js 源码在 RepetitionPenaltyLogitsProcessor 上方的注释中明确写道:“对于大多数 LLM 这样的仅解码器模型,纳入考虑的 token 包括提示词。”
因此,schema 中的每个引号、冒号和键名再次出现的概率都会略微降低。在 1.12 这个值下,它只是轻微抑制,并非禁用,这与数据吻合:Llama 从 24 次中成功 18 次降到了 16 次。对于结构化调用,我仍然会将它设为 1.0。惩罚你明确要求模型输出的那些标点符号,没有任何好处。
Hugging Face 的生成文档将这两个设置都描述为通用的质量调节参数,对于聊天来说确实如此。我的猜测是,很多应用都像 BEINGS 一样,在共享配置中统一设置一次,随后每次结构化调用都会悄悄继承这些设置。今天就值得在你的代码库里用 grep 搜一下。
即使设置合理,小模型也会在 JSON 外面加上说明文字和代码围栏。JSON.parse 遇到这些内容都会抛出异常。因此,分析程序会让每条回复依次经过四步解析流程,并记录第一个成功的步骤:
Llama 3.2 1B,聊天设置,普通提示词,时间为 2026 年 10 月 17 日美国东部时间下午 4:19。错误消息是每一步中 JSON.parse 的真实输出。
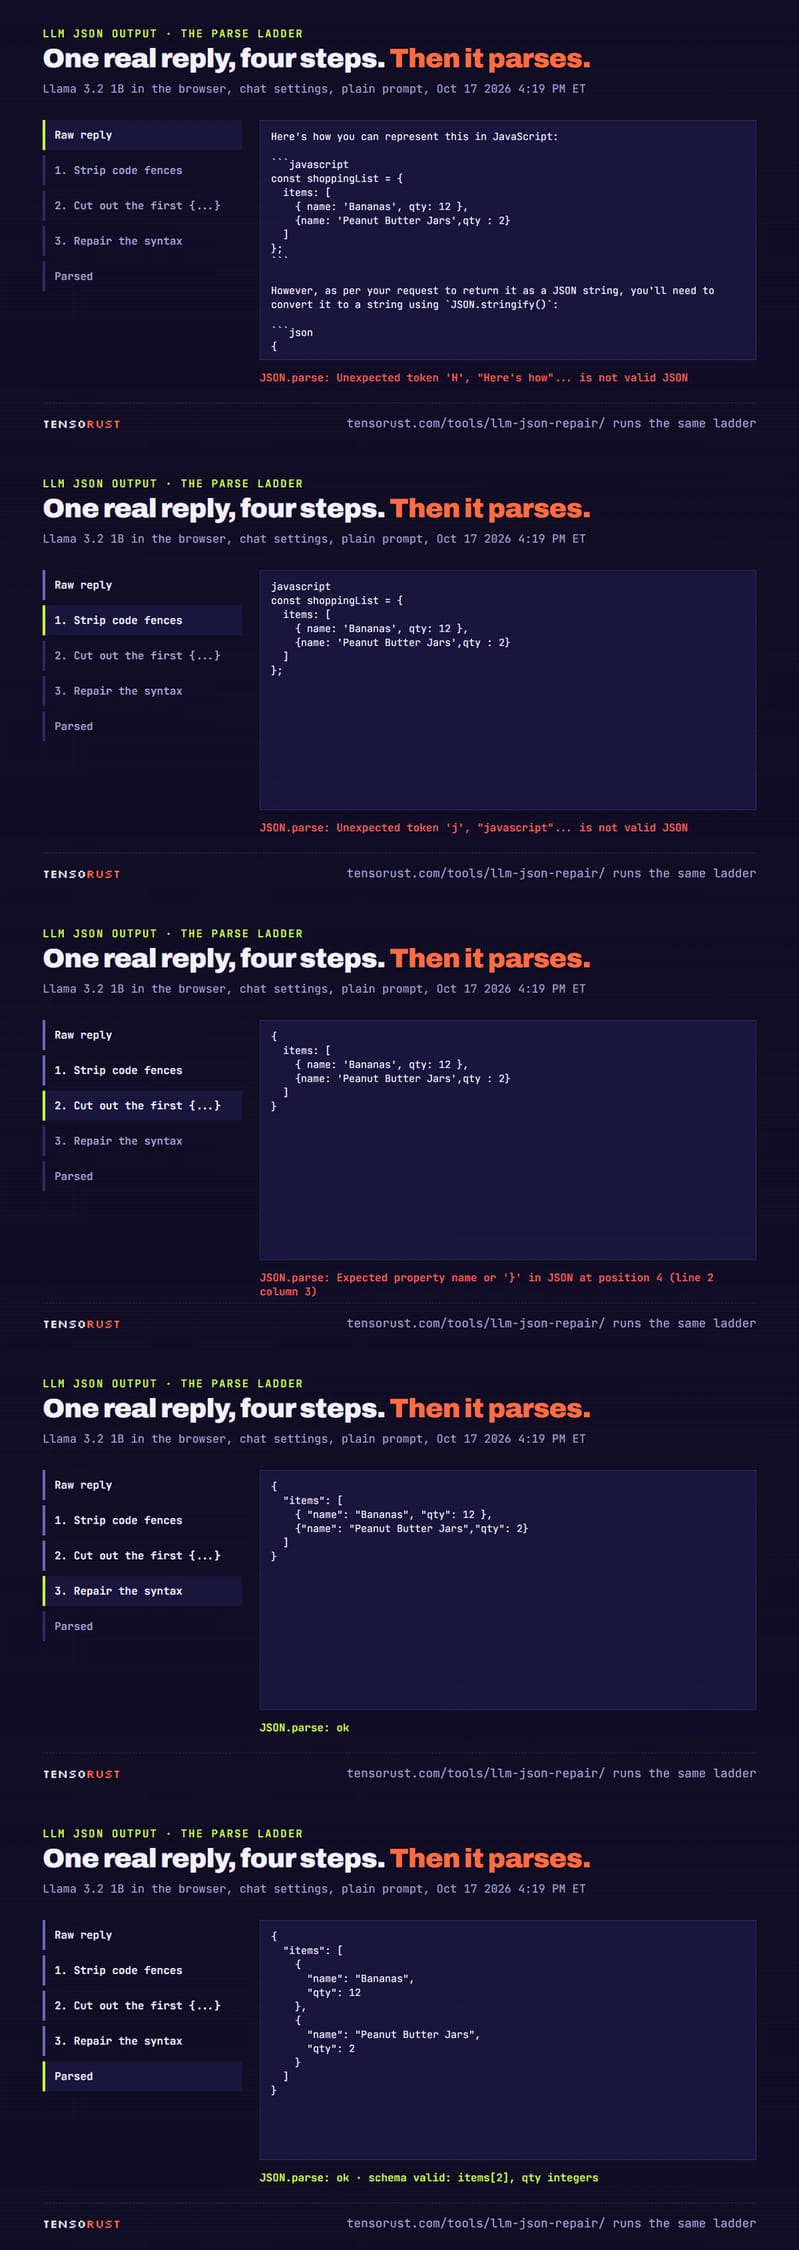
下面是 json_analyze.mjs 中的分步解析代码(经过删减)。修复工具运行的正是这份代码的副本:
export function extractJson(t) {   // first balanced {...} or [...], string-aware
  const start = t.search(/[{[]/);
  if (start < 0) return null;
  const stack = []; let inStr = false, esc = false;
  for (let i = start; i < t.length; i++) {
    const c = t[i];
    if (inStr) { if (esc) esc = false; else if (c === "\\") esc = true; else if (c === '"') inStr = false; continue; }
    if (c === '"') inStr = true;
    else if (c === "{" || c === "[") stack.push(c === "{" ? "}" : "]");
    else if (c === "}" || c === "]") { stack.pop(); if (!stack.length) return { text: t.slice(start, i + 1), closed: true }; }
  }
  return { text: t.slice(start), closed: false, open: stack, inStr };
}

export function ladder(raw) {
  let v = tryParse(raw);                         // 1. as is
  if (!v) v = tryParse(stripFences(raw));        // 2. strip ```
{% endraw %}
json fences
  if (!v) { const e = extractJson(stripFences(raw)); if (e && e.closed) v = tryParse(e.text); } // 3. cut out {...}
  if (!v) { const e = extractJson(stripFences(raw)); if (e) v = tryParse(repair(e.text)); }       // 4. repair
  return v;
}

{% raw %}
repair() 做了五件小事:删除 // 注释,为未加引号的键补上引号,将单引号替换为双引号(仅在文本中没有双引号时执行,因此 "can't" 不会被破坏),转换 Python 的 True/False/None,以及删除尾随逗号。如果回复被截断,它还会补齐所有未闭合的括号。扫描时识别字符串很重要:只要某个值里包含花括号,简单粗暴地“查找最后一个 }”就会出错。
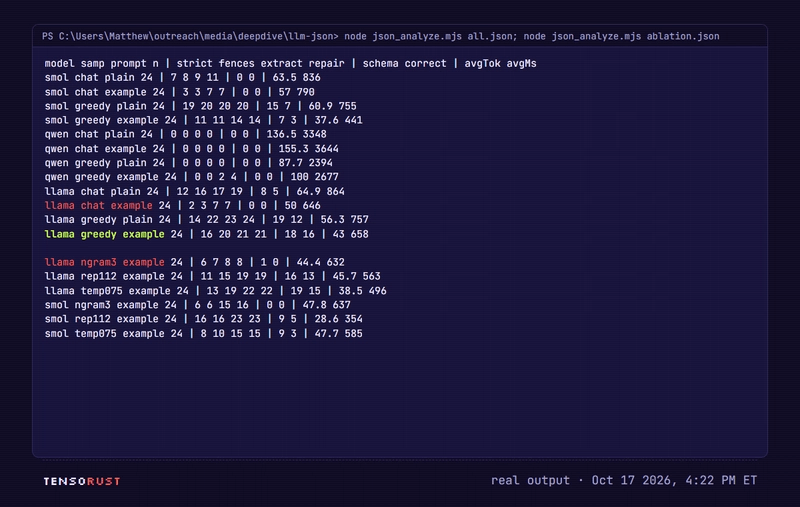
在主实验的全部 288 条回复中,严格的 JSON.parse 成功解析了 84 条(29%)。这套逐级解析流程将这一数字提高到了 127 条(44%)。对于使用贪心解码和普通提示词的 Llama,它将成功数从 24 条中的 14 条提高到了 24 条全部成功:
2026 年 10 月 17 日,使用 json_analyze.mjs 分析主实验结果。这里只统计解析结果,尚未进行 schema 校验。
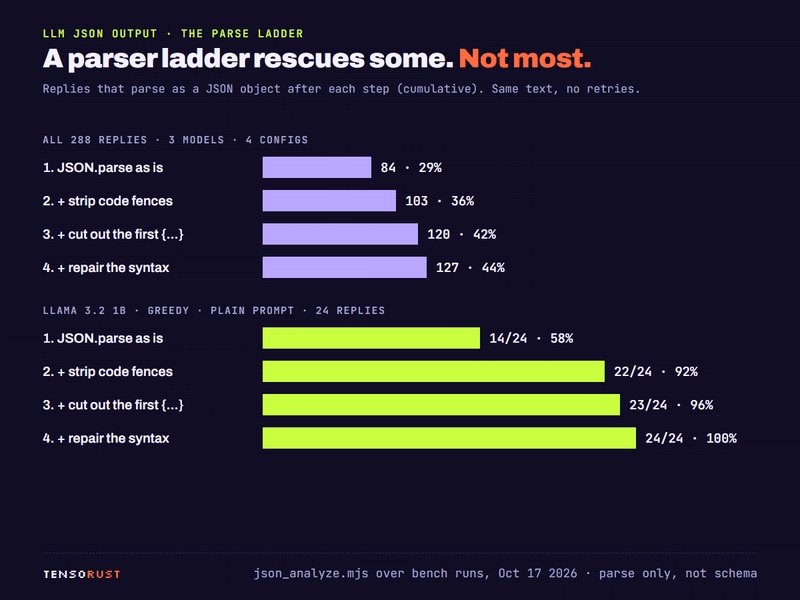
最后这个数字说明,始终准备一套逐级解析流程是有必要的。但更重要的是 44% 与 100% 之间的差距。这套流程能修复 JSON 外层的包装,却无法修复那些根本没有包含 JSON 的回复。
对于每条未通过严格解析的回复,分析脚本都会记录第一个失败原因。在 204 次失败中,代码围栏和“Here is your JSON:”这类说明文字(也就是大家都会写正则来处理的那两种情况)只占 43 次。占比最高的两个原因,任何解析器都无能为力:
2026 年 10 月 17 日,来自 3 个浏览器内运行模型的 288 条回复。
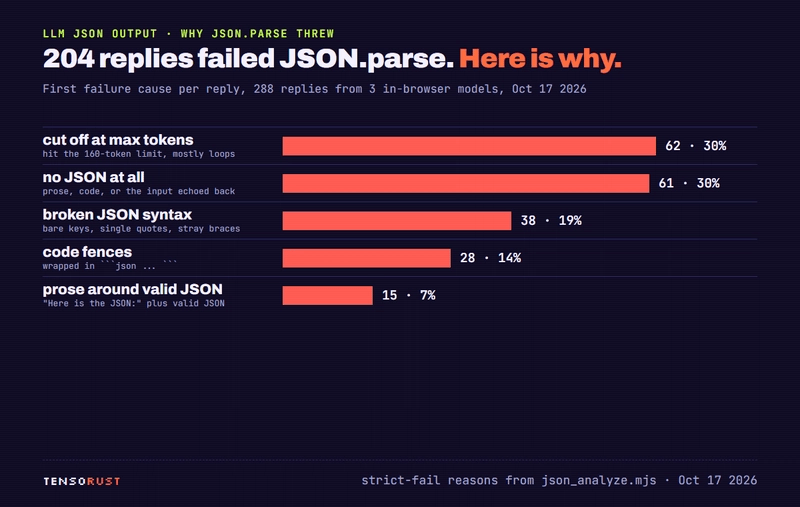
达到 token 上限而被截断(62 条)。大部分并不是回答太长,而是陷入了循环:Qwen 不断重复“jars”“jars”“jars”,直到耗尽 token。
根本没有 JSON(61 条)。输出可能是说明文字、一个用于“提取联系信息”的 Python 函数、一段道歉,或者把输入原样复述了一遍。
Qwen2.5 0.5B 值得单独说一下:在所有配置下,96 条回复中没有一条能直接解析,经过逐级处理后只有 4 条能解析,符合 schema 的仍然是 0 条。贪心解码生成的回复大多先复述用户消息,然后陷入循环(“another meeting another meeting another meeting...”)。在我此前的浏览器基准测试中,同一个 4 位量化 WebGPU 构建版本生成的垃圾聊天内容也是最多的。我不会据此对 Qwen2.5 整体下结论;问题可能出在这个量化构建版本上。但它提醒我们:要测试你实际交付的那个文件。
符合 schema 和内容正确,是两个不同的指标。Llama 的最佳配置(贪心解码 + 示例)生成了 18 条符合 schema 的回复,但只有 16 条内容正确。它主要以两种方式出错:
示例内容混入结果。要求它从“Call me back on (555) 018-2299. Thanks, Tom Okafor”中提取联系方式时,Llama 返回了 {"name": "Dana Reyes", "email": "dana.r@example.com", ...}:姓名和邮箱来自提示词里的示例,电话号码却是 Tom 的。在使用示例提示词生成的 288 条回复中,有 21 条包含从示例中照搬的值(Dana、“chaos lord”、柠檬等)。使用普通提示词时,这个数字是 144 条中的 1 条。
类型发生偏移。比如将 "qty": "1" 输出为字符串,或者省略 "email" 键,而不是将它设为 null。任何 JSON Schema 库之类的 schema 校验器都能发现这些问题;JSON.parse 永远发现不了。
对于 Llama,带示例的提示词仍然更好(16 条正确,普通提示词为 12 条)。对于 SmolLM2,效果反而更差(3 条对 7 条)。小模型会照抄示例,而不是从中学习,这与我在原始文本中观察到的情况一致。如果要使用示例,就把值设成明显的占位内容(如 "NAME"、0),这样很容易发现示例内容是否混入了结果。
JSON 规范很小,而陷阱恰恰就在这里:满足语法要求很容易。真正的工作在解析之后的检查中。
这次测试的是参数量从 3.6 亿到 10 亿的模型,它们运行在浏览器标签页中,使用一块消费级 GPU,因此失败率会高于前沿模型 API。不过,我仍然认为,关于采样器的发现也适用于通过 Hugging Face 风格的生成代码、llama.cpp 或 vLLM 自行运行开放模型的人:n-gram 禁用是一条机械规则,不管模型有多聪明,它都会生效。更大的模型只会找到更巧妙的绕行方式,而这可能更糟,因为结果看起来是对的。
条件允许时,就彻底绕开这些猜测。约束解码将每个后续 token 的选择限制为那些能让输出继续符合语法或 schema 的 token,因此从机制上就能避免生成格式错误的回复。OpenAI 的 Structured Outputs、llama.cpp 的语法约束和 Outlines 都采用了这种方式。如果做不到,那么逐级解析、schema 校验,再加一次重试,就是实际应用中至少该有的配置。Python 还有一个可靠的开源修复库 json_repair,覆盖的情况比我的五条规则更多。
“用真实流量来衡量效果”这条原则以前也救过我一次,当时一个 LLM 缓存差点返回错误答案:别再为同一个 LLM 回答付两次钱。
搜索 no_repeat_ngram_size 和 repetition_penalty。如果结构化输出调用从共享配置中继承了其中任何一个设置,就覆盖它们:no_repeat_ngram_size: 0、repetition_penalty: 1.0。
生成 JSON 时使用贪心解码(或低温度)。温度在这次实验中没有造成负面影响,但贪心解码能让失败复现,方便你修复问题。
采用逐级解析流程。先原样解析,再去掉代码围栏,然后提取第一个括号配平的对象,最后尝试修复。记录成功发生在哪一步;如果需要第 4 步处理的比例持续上升,那就是一个预警信号。
解析后按 schema 校验,并检查类型,不能只检查键。
失败时重试一次,并把错误信息放进提示词。最常见的两种失败(循环和根本没有 JSON)恰恰都是解析器无法修复的。
把示例值设成明显的占位内容,并测试是否有示例内容混入结果。
为列表提高 token 上限。回复被截断时,修复逻辑确实应该补齐括号,但你仍会在毫无察觉的情况下丢失列表项。
想用同一套逐级解析流程测试你自己的回复,可以使用 LLM JSON 修复工具。它预载了本次实验中四条真实的错误回复。
2026 年 10 月 17 日,运行同一套逐级解析流程的免费 LLM JSON 修复工具。
分析脚本的真实输出,2026 年 10 月 17 日,美国东部时间下午 4:22。
关于这次运行,有一点需要如实说明:Chrome 的 WebGPU 设备丢失了两次(一次是在 Llama 首轮运行生成了 18 条回复之后,另一次是在 SmolLM2 消融实验刚开始时)。我从头重跑了 Llama 的整批测试,而且脚本会在设备丢失时重新加载模型并重试该条回复,因此上面的每个数字都来自完整的样本集。
BEINGS 接下来要做的是:用 JSON 表示生物的动作,为结构化输出调用单独配置贪心解码并关闭惩罚,同时让聊天继续保留防重复设置。我会报告 75% 这个结果在真实房间流量中能否保持。
想问问你:你是否遇到过某个采样或解码设置,在你的技术栈里悄悄破坏了结构化输出?我想知道,在浏览器之外,还有哪些设置容易踩坑。
手头正好有一条格式错误的回复?把它粘贴到免费的 LLM JSON 修复工具里。需要为现有应用集成 AI?这里提供固定报价。
如需采取进一步措施,你可以考虑屏蔽此人和/或举报滥用行为