
9.0
重磅
AI SCORE
编程提效2026-10-17 23:01
让偶发测试稳定失败,再交给编程智能体
dev.to · AI#AI编程#测试#故障复现
Editor brief · 编辑速览
修复偶发失败测试前,先记录可复现故障的命令和随机种子,再要求智能体通过连续数百次运行验收。文章指出,低概率失败场景中的少量绿灯运行,无法证明修复有效。
书籍:Ship It —— 务实的创业公司技术栈
我的其他作品:Thinking in Go(两册系列)—— Go 编程完整指南 + Go 中的六边形架构
我的项目:Hermes IDE | GitHub —— 面向使用 Claude Code 和其他 AI 编程工具交付软件的开发者的 IDE
关于我:xgabriel.com | GitHub
假设结账测试每跑 50 次 CI,就会失败一次。你把链接贴给 coding Agent,输入:“修复这个不稳定的结账测试。”它运行测试,结果通过。接着,它给一条断言套上重试,再跑一遍,又通过了,于是报告任务完成。
可问题是,那个有 bug 的版本,大多数时候也能连续通过两次。Agent 什么都没证明;换成你,只跑这两次,也一样证明不了什么。
Claude Code 的最佳实践页面点明了这个问题:“Claude 会在工作看起来完成时停下来。如果没有一项可以运行的检查,‘看起来完成了’就是它唯一能依据的信号。”对于“看起来完成了”这种判断,不稳定测试恰恰是最糟糕的情况。
所以,在 Agent 动手之前,先让测试能够按需失败,再记下触发失败的命令和 seed。然后,把一项必须连续通过数百次的检查交给它,无论你的测试套件用的是 Go、pytest、Vitest 还是 Jest。
可复现的失败,指的是一条命令加上一个 seed,能在几分钟内触发失败,而不是一个偶尔失败的 CI 链接。要做到这一点,你得先弄清楚自己遇到的是哪一类不稳定测试。
第一类无论按什么顺序运行都可能失败:数据竞争、设得太紧的超时、时钟问题,或单个测试内部的共享状态。要找到它,就靠次数,把同一个测试跑上几百遍。第二类取决于前面运行过什么:没清理干净的全局变量、其他测试留下的数据库记录,或缓存。要找到它,就得尝试许多不同的执行顺序,而且每种顺序都要有一个可以重放的 seed。
几百次运行里才失败一次:你得主动把它找出来。
go test 两种方式都支持。-count n 会“将每个测试、benchmark 和 fuzz seed 运行 n 次”。-shuffle on 会打乱测试顺序,并且“会报告 seed,以便复现”。-race 则开启数据竞争检测器。先从单个测试的大量重复运行开始:
go test ./internal/cart -run '^TestCheckoutTotals$' \
  -count=500 -race -failfast -timeout=30m
-failfast 会在第一次失败时停止,让输出保持简短。-timeout 也很重要。默认超时是 10 分钟,而数据竞争检测器的文档提到,对典型程序来说,“内存占用可能增加到 5–10 倍,执行时间可能增加到 2–20 倍”。如果开启数据竞争检测后,500 次运行超过了 10 分钟,测试二进制程序就会 panic,看上去像是一次失败,但它与你要修的 bug 毫无关系。
如果单独运行这个测试始终不失败,那它很可能依赖另一个测试,这时就需要尝试不同的顺序。这里,Go 源码中的一个细节会影响命令的写法。在 testing.go 中,M.Run 会先将顶层测试打乱一次,通过 fmt.Println("-test.shuffle", n) 打印 seed,然后才进入 -count 循环。因此,-count=500 -shuffle=on 的含义是:随机选一种顺序,运行 500 次。它并不是尝试 500 种顺序。
要尝试多种顺序,就运行多个测试二进制进程,每次都使用你自己选定的 seed:
log=$(mktemp)
for i in $(seq 1 50); do
  seed=$RANDOM
  if ! go test ./internal/cart -count=10 \
      -shuffle="$seed" -race >"$log" 2>&1; then
    echo "FAILED: -shuffle=$seed"
    tail -n 40 "$log"
    break
  fi
done
出现失败后,go test ./internal/cart -count=10 -shuffle=<seed> -race 就能重放相同的顺序。另外,在指定 package 运行时,Go 会缓存通过的结果。因此,如果 Agent 连续执行两次 go test ./internal/cart,中间没有任何改动,第二次拿到的可能是缓存中的通过结果,而非真正执行了一遍。文档将 -count=1 称为“显式禁用测试缓存的惯用方式”。交给 Agent 的每条命令,都要加上 -count。
Python 需要两个插件。pytest-repeat 添加了 --count,它的 README 提到,可以搭配 -x,“强制测试运行器在第一次失败时停止”。pytest-randomly 会打乱测试顺序,在开始时打印 seed(文档中的示例是 Using --randomly-seed=1553614239),并且“在每个测试的 setup、run 和 teardown 之前”重置 Python 的全局随机 seed。因此,一个 seed 既能重放执行顺序,也能重现通过 random 生成的数据。
python -m pip install pytest-repeat pytest-randomly
pytest "tests/test_cart.py::test_checkout_totals" \
  --count=500 -x -q
这里有一个和 Go 相同的限制:一次 pytest 运行只使用一个 seed,所以这 500 份测试会按同一种打乱后的顺序执行。要尝试多种顺序,把下面这条命令放进 Go 那一节的循环中,并自行传入 seed:
pytest tests/ -x -q --randomly-seed="$seed"
只要 pytest 的 cache provider 插件处于启用状态,--randomly-seed=last 就能重新使用上一次的 seed。
然后关闭插件,按文件顺序将每个测试同样运行 50 次:pytest tests/ -x -q -p no:randomly --count=50。不要在循环本身使用的命令里加上 -p no:randomly,因为插件关闭后,pytest 就不再识别 --randomly-seed,每一轮都会因用法错误而退出。如果打乱顺序时会失败,按文件顺序运行却从不失败,说明这个测试依赖了其他测试留下的状态。如果两种方式都会失败,就检查时间、线程、网络或数据库。
Vitest 5 可以直接通过命令行完成这两件事。--repeats <number> 会“无论结果如何,都将每个测试重复指定次数”,而 --sequence.shuffle 搭配 --sequence.seed 可以生成由 seed 决定的执行顺序。sequence 配置文档说,seed 默认是 Date.now(),但没有说 Vitest 会把它打印出来。所以,自己传入 seed,就总能知道是哪一个触发了失败:
npx vitest run src/cart --repeats=50 --bail=1
npx vitest run --sequence.shuffle \
  --sequence.seed="$seed" --bail=1
Jest 30 提供了 --randomize,它会打乱单个文件内的测试顺序,并显示 seed,而且只适用于默认的 jest-circus runner。--seed=<num> 用于设置 seed,Jest 也会用它打乱测试套件的执行顺序,其取值必须介于 -2147483648 和 2147483647 之间。在 bash 中,$RANDOM 的取值范围是 0 到 32767,因此符合要求。对于 Jest,重复运行交给循环来做:
npx jest src/cart --randomize --seed="$seed" --bail
把循环放进一个脚本,只有全部运行通过时才以 0 退出。你运行它,Agent 也运行它,谁都不需要再判断“看起来是不是没问题”。
#!/usr/bin/env bash
# scripts/flaky-check.sh
# Exit 0 only if RUNS seeded runs all pass.
set -u
RUNS=${RUNS:-50}

run_once() {
  go test ./internal/cart -count=10 -shuffle="$1" -race
}

log=$(mktemp)
for i in $(seq 1 "$RUNS"); do
  seed=$RANDOM
  if ! run_once "$seed" >"$log" 2>&1; then
    echo "run $i/$RUNS FAILED, seed $seed"
    tail -n 40 "$log"
    exit 1
  fi
done
echo "$RUNS/$RUNS runs passed"
运行 50 轮,每轮使用 -count=10,意味着 package 中的每个测试总共执行 500 次,覆盖 50 种顺序。对于 pytest,把 run_once 的函数体替换为 pytest tests/ -x -q --count=10 --randomly-seed="$1"。对于 Vitest 或 Jest,使用上面的命令,并以 "$1" 作为 seed。
跑多少次才够,取决于失败率,所以先用循环测量一下,按测试的单次执行来计数。如果每 50 次执行失败 1 次,而所谓的“修复”实际上什么都没改变,那么脚本中的 500 次执行(50 轮 × -count=10)仍然全部通过的概率就是 0.98^500,约为二万四千分之一。如果失败率是千分之一,那么仍然有 bug 的测试通过同样 500 次执行的概率就高达 61%(0.999^500)。越罕见的不稳定问题,需要的运行次数越多。依赖顺序的不稳定测试没有固定的单次执行失败率,因为它只在某些顺序下失败,所以这类问题要调高 RUNS,尝试更多顺序。
接下来是任务说明。下面的 8812 代表你的循环打印出来的 seed:
Fix the flaky test TestCheckoutTotals in ./internal/cart.

Reproduce first. This fails within a few minutes:
  go test ./internal/cart -count=10 -shuffle=8812 -race
Run it before you change anything and confirm it fails.

Failure:
  <paste the failing assertion and any race report>

Rules:
- Find the cause. No retries, sleeps, t.Skip or
  longer timeouts.
- Don't change the test's assertions or
  scripts/flaky-check.sh.

Done when both pass:
  go test ./internal/cart -count=10 -shuffle=8812 -race
  scripts/flaky-check.sh
先复现,也是 Claude Code 文档针对 bug 给出的建议:“先编写一个能够复现问题的失败测试,再修复它。”如果你希望在 Claude Code 内部强制执行这道检查,同一份文档也介绍了一种 Stop hook,它会“以脚本形式运行你的检查,并在检查通过之前阻止当前轮次结束”。
Hermes IDE 是我开发的,阅读这一节时请把这点考虑在内。上面所有操作都能在任何终端中完成。Hermes 只是把 Agent、复现循环和检查结果放进了同一个窗口。
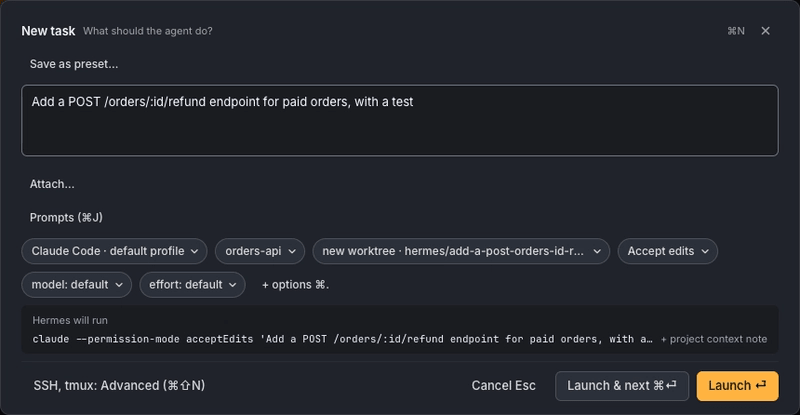
按下 ⌘N(Windows 和 Linux 上是 Ctrl+Shift+N),把任务说明粘贴为任务。Agent,例如 Claude Code 或 Codex,会在一个真正的终端中启动,使用你自己的登录身份,在独立的 hermes/<name> 分支和独立的 worktree 中工作,并将这份任务说明作为它的第一条 prompt。
⌘N 打开的 New task 面板:其中有任务内容、Claude Code 选项标签、orders-api 项目、新的 hermes/ worktree、Accept edits、模型与推理强度,以及显示 claude 命令的“Hermes will run”预览。
然后向右或向下拆分窗格,在 Agent 旁边打开一个普通 shell。git worktree list 会显示这个任务所在的目录。cd 进入该目录,自己运行带 seed 的复现命令:在 Agent 第一次修改前跑一次,最后一次修改后再跑一次。有一点需要注意:你的循环和 Agent 自己运行的测试会争用 CPU,这会改变时序。两边都忙碌时,数据竞争出现的频率可能升高,也可能降低,所以最终检查要在 Agent 空闲时运行。
拆分窗格中的两个会话:Codex 在 orders-types 上工作,Claude Code 在 orders-api 上工作,各自使用独立的 hermes/ worktree;左侧的会话侧边栏显示状态、context 使用量、费用和分支。
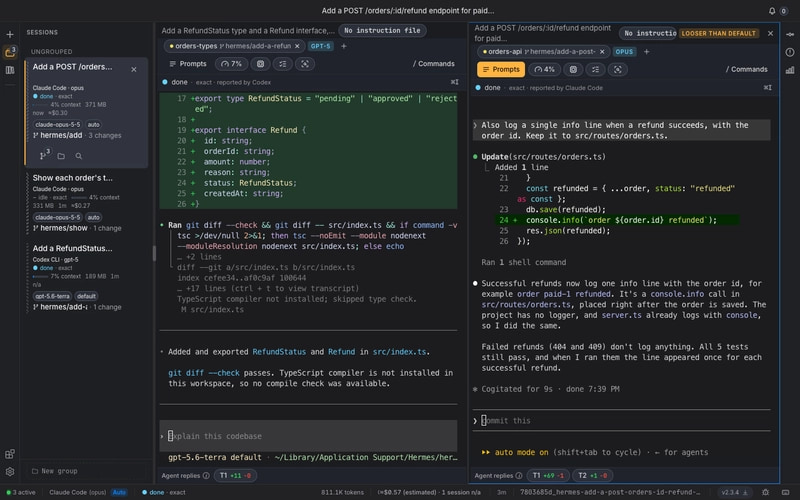
你的脚本始终是判断任务完成的标准,所以在合入改动前,先在那个窗格中运行它。然后打开 Review Desk(⌘G,Windows 和 Linux 上是 Ctrl+Shift+G),逐轮查看改动。你要确认规则得到了遵守:没有新增 sleep,没有重试,也没有放宽断言。至于检查脚本,一条普通的 git 命令就能给出答案:
git diff main...hermes/<name> -- scripts/
没有输出,就说明 Agent 没动你的检查脚本。
不稳定测试首先是 CI 问题,然后才是 Agent 问题:一旦流水线开始随机报红,人们就会养成点击重新运行的习惯,真正的失败也就淹没在噪声里。Ship It 涵盖了小团队从 localhost 到生产环境之间的各个环节,从托管、支付和身份认证,到 CI/CD 与监控,而这样的检查最终就会落在这些环节中。
Hermes IDE 可以免费下载,以 BSL 1.1 许可开放源代码,支持 macOS、Windows 和 Linux,与 Anthropic、OpenAI 或 Nous Research 均无关联。如果它帮你少重新运行了一次,在 GitHub 上点个 star,能帮助其他开发者发现它。
后续你可以考虑屏蔽此人和/或举报滥用行为。