
8.0
热点
AI SCORE
技术实践2026-10-17 22:59
用棋力引擎约束模型,减少复盘幻觉
dev.to · AI#开源#幻觉控制#本地模型
Editor brief · 编辑速览
棋局复盘项目 Second 将 Stockfish 的分析结果交给 Gemma 4 E4B 组织成教学说明,并用代码校验输出。作者测试的 29 个案例中,直接输入棋局时模型从未给出引擎首选走法,提供引擎事实后则全部命中。
Hacktoberfest 开源 AI 挑战赛第 2 周:副业赛道投稿 💸
本文是 Hacktoberfest 开源 AI 挑战赛第 2 周「副业」赛道的参赛作品。
我让 Gemma 4 E4B(一个开放模型)解释俱乐部对局中 29 次真实出现的严重失误和一般失误。它给出的讲解没有一次推荐 Stockfish 的最佳替代走法,而且每四条讲解中就有一条推荐了不符合规则的走法。后来,我不再直接给它原始棋局,而是把 Stockfish 确认的事实交给它,结果 29 次中,它全部说对了应该走哪一步。
这个差距,就是整个产品的立足点。
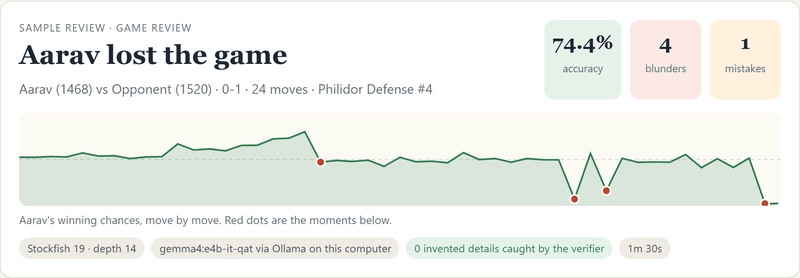
Second 是面向国际象棋教练的棋局复盘助手。教练粘贴学生的棋局(或者只输入他们的 Lichess 或 Chess.com 用户名),几分钟后就能拿到一份可以直接用于教学的复盘讲义:
决定棋局走向的 3 到 4 个关键时刻,通过棋盘图展示实战走法、更好的走法,以及对手的威胁
用 10 岁孩子也能听懂的话,简短解释每个关键时刻
一个可以在课堂上问学生的问题,以及一条需要记住的实用口诀
本周作业
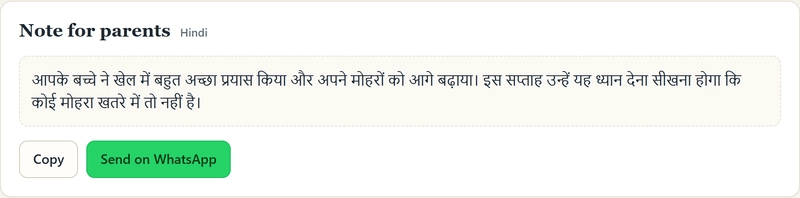
一段可以直接通过 WhatsApp 发给家长的话,支持印地语、Hinglish(印地语与英语混合)、泰米尔语、英语或其他任何语言
一份带注释的 PGN,可以直接导入 Lichess 棋谱研究
这一切都能在普通笔记本电脑上运行,使用的都是开放模型:Stockfish 负责棋局分析,Gemma 4 E4B(通过 Ollama 运行)负责组织文字,一个用纯 Python 编写的校验器负责确保文字只陈述 Stockfish 已确认的内容。
在国际象棋中,second 指的是负责赛前准备的分析助手,让棋手可以专心下棋。这里也是一样:教练继续负责教学,Second 则负责周日晚上批改作业的工作。
谁会为它付费?
自从 Gukesh 成为世界冠军以来,印度的国际象棋培训迅速升温。很多教练本身是水平不错的俱乐部棋手,或是利用课余时间教学的大学生,因此教棋本身就是一份副业。上课有报酬,课后的工作却没有:逐个打开学生的棋局,找出转折点,再写下孩子和家长真正愿意读的内容。一个有 20 名学生的教练,如果每名学生每周下两盘棋,就得复盘 40 盘。每盘花五分钟,每周就是三个多小时的无偿劳动。
Second 把每盘棋的复盘变成笔记本电脑上大约 90 秒的处理过程,这段时间教练可以去做别的事。
我的商业化设想是这样的:软件采用 GPL 许可证,永久免费,支持自行部署。教练为那些不想亲自动手的部分付费:一键安装程序、在打印讲义上印上自家棋院的名称、每周自动导入所有学生的线上棋局,以及技术支持。每名教练每月大约 ₹299(约合 3.15 美元)。这个定价之所以可行,是因为生成一份复盘没有额外成本:模型运行在教练自己的笔记本电脑上,不会每多分析一盘棋,账单就跟着上涨。
在线演示:免费 Render 实例,因此唤醒可能需要一分钟。
复盘示例:使用 Lichess 开放数据库中的真实棋局,在我的笔记本电脑上完成复盘,并附上可使用印地语、英语、泰米尔语等任何语言撰写的家长说明。
下面是我在笔记本电脑上实际运行的加速演示(实际过程大约需要 90 秒):粘贴棋局,Stockfish 检查每一步,Gemma 撰写讲解,校验器检查讲解,最后生成复盘,并附上一段印地语的家长说明(也可以使用任何其他语言)。

每个关键时刻都会展示两个棋盘:走棋前的局面(红色表示实战走法,绿色表示更好的走法),以及走棋后的局面(橙色表示对手的最佳应对,黄色表示失去保护的棋子)。
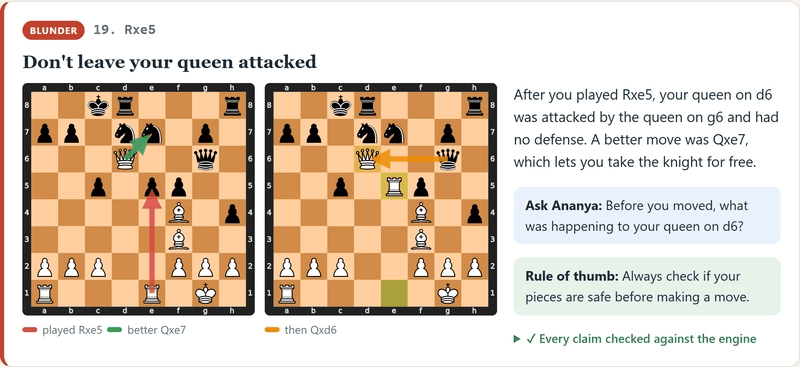
还有家长真正会读的部分:
dragon-slayer27 / chess-second

面向国际象棋教练的棋局复盘工具:Stockfish 找出失误,开放权重的 Gemma 4 负责解释,校验器核对每一项陈述。可在笔记本电脑上运行。
Stockfish 找出问题。Gemma 解释问题。代码负责核验。
试用:公开演示使用免费实例,请给它一分钟唤醒时间。另有复盘示例可供查看。
Second 把学生的棋局变成可以直接用于教学的复盘讲义:用棋盘图呈现转折点,为每个转折点提供适合孩子理解的解释、课堂提问、实用口诀、作业,以及一段用家长熟悉的语言撰写、可直接通过 WhatsApp 发送的说明。
它使用开放模型(Stockfish + 通过 Ollama 运行的 Gemma 4),在普通笔记本电脑上即可运行,因此学生的棋局和姓名始终留在教练的电脑上,生成复盘也不需要额外费用。

在国际象棋中,second 指的是负责准备工作的分析助手,让棋手(或教练)可以专注于棋局。这里也是一样:教练依然负责教学,Second 负责周日晚上批改作业的工作。
第一个实验:单独使用 Gemma,它是个糟糕的国际象棋教练
在最初的测试中,我给 Gemma 4 E4B 提供了一行事实,描述的是最著名的新手严重失误:“学生走了 3... Nf6,让对手得以走出 Qxf7#。更好的走法是 g6。”然后让它写一段教学讲解。
它给讲解起的标题是“别被快速击倒:避开底线陷阱”。但这根本不是底线将杀。它还提醒学生小心“闪击”,可这里也没有闪击。第二次尝试时,标题变成了“战术失误:避免弃后”。实际上,后吃掉一个兵就直接将杀了,根本没有弃子。
放在聊天机器人里,这些错误无伤大雅。但如果它们印在一张讲义上,一个 10 岁的孩子会信以为真,而孩子的父母正付钱请教练提供准确的指导,那就不是小事了。
所以,模型完全不参与分析
Second 的规则很简单:语言模型只负责写文字。所有与棋局有关的判断都由代码完成。
PGN / Lichess / Chess.com
  -> Stockfish: every position, best 2 lines, depth 14
  -> Facts: python-chess works out what actually happened
  -> Gemma 4: headline, explanation, question, tip, summary, parent note
  -> Verifier: is every claim in the facts?
       yes                 -> review
       no                  -> Gemma gets the list of problems and tries again
       3 failed tries      -> plain note built from the facts
Stockfish 检查每一步。系统使用与 Lichess 相同的胜率曲线和阈值:当一步棋导致棋手的获胜概率下降至少 10 个百分点时,就会被标记出来;下降至少 15 个百分点则被判定为严重失误。
代码把分析结果转化为事实。针对每个关键时刻,python-chess 会判断实际发生了什么,并用直白的句子记录下来:哪枚棋子失去了保护、正受到什么棋子的攻击,对手的应对是否构成捉双,是否存在强制将杀(以及是否属于底线将杀),更好的走法能吃掉什么,以及每条变化能赢得或损失多少子力。下面是一盘示例棋局中某次严重失误的真实事实清单(来自 Lichess 数据库中一盘等级分为 1531 的超快棋对局):
Move played: 19. Rxe5 (a blunder)
- Before Rxe5 the position was winning for you; after it, the position was losing for you.
- After Rxe5, your queen on d6 is attacked by the queen on g6 and nothing defends it.
- After Rxe5, your rook on e5 can be taken by the knight on d7, which is worth less.
- Your opponent's best reply is Qxd6, which captures your queen on d6.
- If your opponent finds the best line (Qxd6, Re4, fxe4, Bxd6), you lose about 8 points of material.
- The better move was Qxe7, which captures the opponent's knight on e7 for free.
- Following the best line (Qxe7, e4, Be2, h3), you would win about 3 points of material.
KEY FACT: After Rxe5, your queen on d6 is attacked by the queen on g6 and nothing defends it.
下面是 Gemma 根据这些事实写出的讲解:
别让你的后受到攻击却无人保护。你走出 Rxe5 后,d6 格的后受到 g6 格对方后的攻击,而且没有任何棋子保护它。更好的走法是 Qxe7,这样你就能白吃对手的马。问问 Ananya:走棋之前,你在 d6 格的后面临什么情况?实用口诀:每次走棋前,都要检查自己的棋子是否安全。
Gemma 根据学生的水平(初级、中级、高级)撰写讲解:一个小标题、两三句话、一个引导学生自己发现思路的问题,以及一条实用口诀。然后再生成总结、课后练习和给家长的反馈。
校验器会对照引擎给出的事实,检查具体的国际象棋相关断言。讲解中的每个着法、格子、“N 步将杀”、回合数和局面评估值,都必须出现在事实中。提到的每一种战术也一样:只有事实中出现了“双攻”“牵制”“弃子”“底线”或“闪击”,讲解才能使用这些说法。“你会丢掉皇后”或“f4 上的马没有保护”之类的断言,必须与事实中确实丢失或未受保护的棋子相符。给家长的反馈不能包含棋谱记号;如果要求使用印地语,就必须真正使用天城文书写。只要有任何一项未通过,系统就会明确告诉 Gemma 错在哪里,让它重试。连续失败三次后,Second 会使用根据事实拼装出的朴素讲解,确保任何编造的内容都不会传到学生面前。
TACTIC_RE = re.compile(
    r"\b(back[- ]rank|fork(?:s|ed|ing)?|pin(?:s|ned|ning)?|skewer\w*|discovered (?:attack|check)\w*|"
    r"sacrific\w*|smothered|stalemate\w*|en passant|zwischenzug|deflect\w*|decoy\w*|overload\w*|x-ray)\b",
    re.I,
)
...
for match in TACTIC_RE.finditer(text):
    word = match.group(1).lower()
    root = next(root for prefix, root in TACTIC_ROOTS if word.startswith(prefix))
    if not allowed.mentions(root):
        issues.append(Issue("wrong_tactic", match.group(0)))
我从 Lichess 开放数据库(CC0)中抽取了 16 盘真实对局,棋手的等级分在 1000 到 1700 之间,并选取双方各自最严重的一次漏着或失误,共得到 29 个关键时刻。在同一台笔记本电脑上,我让同一个模型以三种方式分别解释每个时刻:
原生 Gemma:提供此前的着法,再加上一句“这步棋是漏着,请解释原因”。这就是把一盘棋粘贴到聊天机器人里时会发生的事。
Gemma + 引擎事实:提供 Second 的事实清单,直接采用第一次回答,不经过校验器。
Second:事实、校验器、重试和兜底。
举个例子。一名初学者走出 14. g4 后:
原生 Gemma:“更好的选择是走 14. Nf7,给黑方的局面施加更大压力。”但在那个局面下,Nf7 并不是合法着法。
Second:“你走出 g4 后,局面对你变得不利。如果改走 Nxh6,你本可以赢得约 2 分的子力。”
实际结果让我有些意外:事实清单几乎完成了全部工作。有了可靠的事实清单,这次测试中 Gemma 的第一次回答全部通过了校验器,因此校验器一次也没有介入。但我还是会保留它。它就像安全带,在事实约束不够用的那一天提供保护,也让我能够说“不会有编造的内容传到学生面前”,而不是“应该不会有”。每条讲解和每项得分都记录在 eval/results.json 中。
告诉它什么最重要。我最初生成的讲解全部正确,却也全部平淡无味(“注意避免严重失误!”)。在早期的一次复盘中,事实清单已经指出,对方即将用马双攻(Nxc2+,同时攻击王和车),Gemma 却在讲 c2 上的兵。解决办法是让代码为每个关键时刻选出唯一一条 KEY FACT,并要求讲解开头就点明它。
说清楚读者是谁。第一份印地语“家长反馈”以“प्रिय Aarav”(“亲爱的 Aarav”)开头:它写给了孩子。现在,提示词会明确要求面向家长书写,用第三人称谈论孩子,并指出本周需要练习的一件事。
干脆不要把孩子的姓名交给模型。Gemma 写出 [STUDENT],再由 Second 填入姓名。在本地运行时,这一点影响不大,但它意味着托管演示版永远不会把孩子的姓名发送给任何人。
处理第一盘样本对局时,校验器自豪地报告:“抓到了 4 处编造的细节。”我去检查后发现,每一处都是我的程序有 bug,而不是 Gemma 出错。总结中说,学生“在第 5 回合完成了王车易位”,并且“准确率为 75.1%”。这两点都是真的,也都在我提供给 Gemma 的事实中,但总结检查器只知道那些关键时刻,因此连续三次拒绝了这些内容。更糟的是,随后整份总结都回退到了英文模板,尽管家长要求的是印地语。
我做了两项修复。现在,总结会严格对照 Gemma 实际看到的那份事实清单进行检查。而且,兜底会按字段分别处理:如果只有总结中的一句话有问题,就只替换那句话,保留完全合格的印地语家长反馈。
我通过 Ollama 运行 gemma4:e4b-it-qat(6.1 GB),使用的是一台配备 Intel Core Ultra 5、16 GB 内存且没有独立显卡的笔记本电脑。默认情况下,Ollama 没有使用集成的 Intel Arc GPU。设置 OLLAMA_IGPU_ENABLE=1 后,Vulkan 被启用,提示词处理速度从约每秒 31 个 token 提升到了约 315 个。现在,在网页应用中复盘一整盘棋,从点击“Review”到最终页面生成,大约需要 90 秒:Stockfish 用时约 20 秒,Gemma 为每条讲解花费约 12 秒。一次完整复盘大约使用 2,000 到 3,000 个输入 token,以及约 550 个输出 token,全部免费。
公开演示版使用同一个 Docker 镜像,运行在 Render 的免费套餐上。免费实例没有足够的内存来加载 Gemma,因此演示版在容器中运行 Stockfish,并调用 Google AI Studio 上的 Gemma 4 26B A4B 来生成讲解。由于 Gemma 是一个开放模型家族,提示词、校验器和模型家族都与笔记本电脑上相同;变化的只有模型权重在哪里运行。演示版一次处理一盘公开对局;学生的对局应该留在教练的笔记本电脑上。使用更大的托管版 Gemma,速度也很快:一盘 21 回合的对局不到 30 秒就返回了结果,每条讲解都在第一次尝试时通过了校验器。
我在 VS Code 中使用 GitHub Copilot 的智能体作为结对编程伙伴,构建了 Second。它帮助我构思并检验这个想法,编写了大部分代码和测试,在我的笔记本电脑上安装了 Ollama 和 Gemma,运行了评估,还从 Ollama 的日志中发现了利用 Intel GPU 提速的方法。每次推送代码时,GitHub Actions 都会使用真实的 Stockfish 运行测试,并构建 Render Docker 镜像、执行冒烟测试。
最难的部分已经开源。世界上最强的国际象棋引擎 Stockfish 是自由软件。一个 4B 语言模型不会下棋,也不需要会:开源软件已经解决了棋局分析问题,模型只需要负责表达。Second 只是连接两个开放项目的一层薄薄的胶水代码。
孩子的数据留在本地。教练的学生是儿童,而印度的《2023 年数字个人数据保护法》对儿童个人数据提出了额外要求,包括取得家长可验证的同意。Second 在教练自己的笔记本电脑上运行,因此无需再把棋局和姓名交给另一家公司:没有第三方数据处理方,没有数据出境,也没有需要向担忧的家长额外解释的事情。
没有账单,不用信用卡,也不用账户。如今,托管模型每盘棋的费用已经很低,但它们都需要账户、API 密钥,而且通常还需要国际信用卡,而印度有不少小规模执教的教练并不具备这些条件;随着学生增加,账单也会不断上涨。在教练的笔记本电脑上,一周内第 40 盘棋的成本与第 1 盘完全相同:零。对于一个每月收费 ₹299 的产品,这是唯一一个再也不需要反复核算的成本数字。
没有厂商锁定,也允许商业销售。Gemma 4 以 Apache 2.0 许可证发布,因此我可以基于它构建付费产品,无需向任何人申请许可。同一套提示词可以用于笔记本电脑、Ollama Cloud 或 Google AI Studio 上的 Gemma;将来教练换了配置更高的电脑,我也可以直接换用更大的 Gemma。
开放数据让评估成为可能。Lichess 数据库采用 CC0 许可。我可以使用真实的俱乐部对局进行测试,公开每条讲解和每项得分,并让每个示例都能追溯到原始对局。
它可以离线运行。比赛场馆的 Wi-Fi 差是出了名的。Second 完全不需要联网。
这个项目是在与 GitHub Copilot 智能体的一次长时间协作中完成的:从头脑风暴、环境配置,到代码、测试、评估,以及本文中的各项数据。提交历史和 eval/results.json 记录了这些工作。
我的第一位用户是一位棋下得很好的朋友。他试用了 Second,说他觉得这个工具给教练使用挺不错。能从一位没有参与开发的人那里得到第一次正面反馈,而不只是依靠自动化测试和自己的预期,让我很受鼓舞。
他的反馈很简短,所以我把它视为一个令人鼓舞的初步反应,而不是详尽的准确性评审。基准测试衡量的是具体的技术检查项;这次试用则是了解另一位棋手实际使用感受的第一步。
下一步是把它融入教练每周的日常工作:复盘学生的对局,在课堂上使用那些引导性问题,并找出哪些部分确实能节省备课时间。在把拟议中的付费方案发展为一门生意之前,我想先完成这样的验证。
Gemma 的最佳用途:Gemma 4 E4B(QAT)通过 Ollama 在本地运行,以引擎事实为依据,撰写每条讲解、总结和多语言家长反馈,并由校验器检查。Google AI Studio 上的 Gemma 4 26B A4B 则为公开演示版提供支持。
GitHub Copilot 最佳应用:使用 GitHub Copilot 的智能体完成端到端构建;每次推送代码时,GitHub Actions 都会使用真正的 Stockfish 运行测试,并构建用于 Render 部署的 Docker 镜像,对其进行冒烟测试。
Render 最佳应用:公开演示是一个 Docker Web 服务,通过 render.yaml Blueprint 部署到 Render。
如需采取进一步措施,你可以考虑屏蔽此人和/或举报滥用行为。