
8.0
热点
AI SCORE
技术实践2026-09-26 21:05
LLM水印技术如何影响AI Agent行为
Hacker News#LLM水印#AI Agent#安全
Editor brief · 编辑速览
水印技术虽能追踪AI生成内容,但会影响Agent决策路径和任务成功率,开发者需在溯源与性能间权衡。
近日,Anthropic 宣布未来的 Claude 模型将在其输出中嵌入不可见水印[1]、[2],随后又披露该水印基于 Google DeepMind 的 SynthID-Text[2]、[3]。文本水印本身并非新技术,但其部署如今已具有监管相关性。欧盟《AI 法案》第 50(2)条[4]要求,提供生成合成文本的 AI 系统的提供商须以机器可读格式标记其输出,并使用在技术可行范围内有效、互操作、稳健且可靠的技术解决方案,使输出可被检测为人工智能生成或操控。
水印设计用于溯源,但 SynthID-Text 改变了模型生成每个下一 token 的过程。在模型层面,这可能改变安全行为,包括模型是否拒绝有害请求,以及在提示注入下该拒绝是否仍然有效。在智能体层面,同样的采样 token 可能决定调用哪个工具以及传递给它的参数。提示注入将这两种场景联系起来,因为当模型也能通过工具行动时,被削弱的拒绝会变得更加关键。因此,这种水印程序可能同时影响模型所说的内容和智能体所执行的操作。我们将这种行为效应称为采样漂移(sampling drift)。
这种漂移是否会在实践中出现是一个经验性问题。我们发现它确实存在,无论是在模型拒绝行为还是智能体工具调用中。该效应与模型和密钥相关,且可能被总体分数所掩盖——当相反方向的变化相互抵消时尤为如此。因此,我们既报告带水印与不带水印运行之间的净性能,也报告其配对分歧。此外,最后一节将讨论这对 AI 安全和保障意味着什么,以及开发者应该采取什么措施。
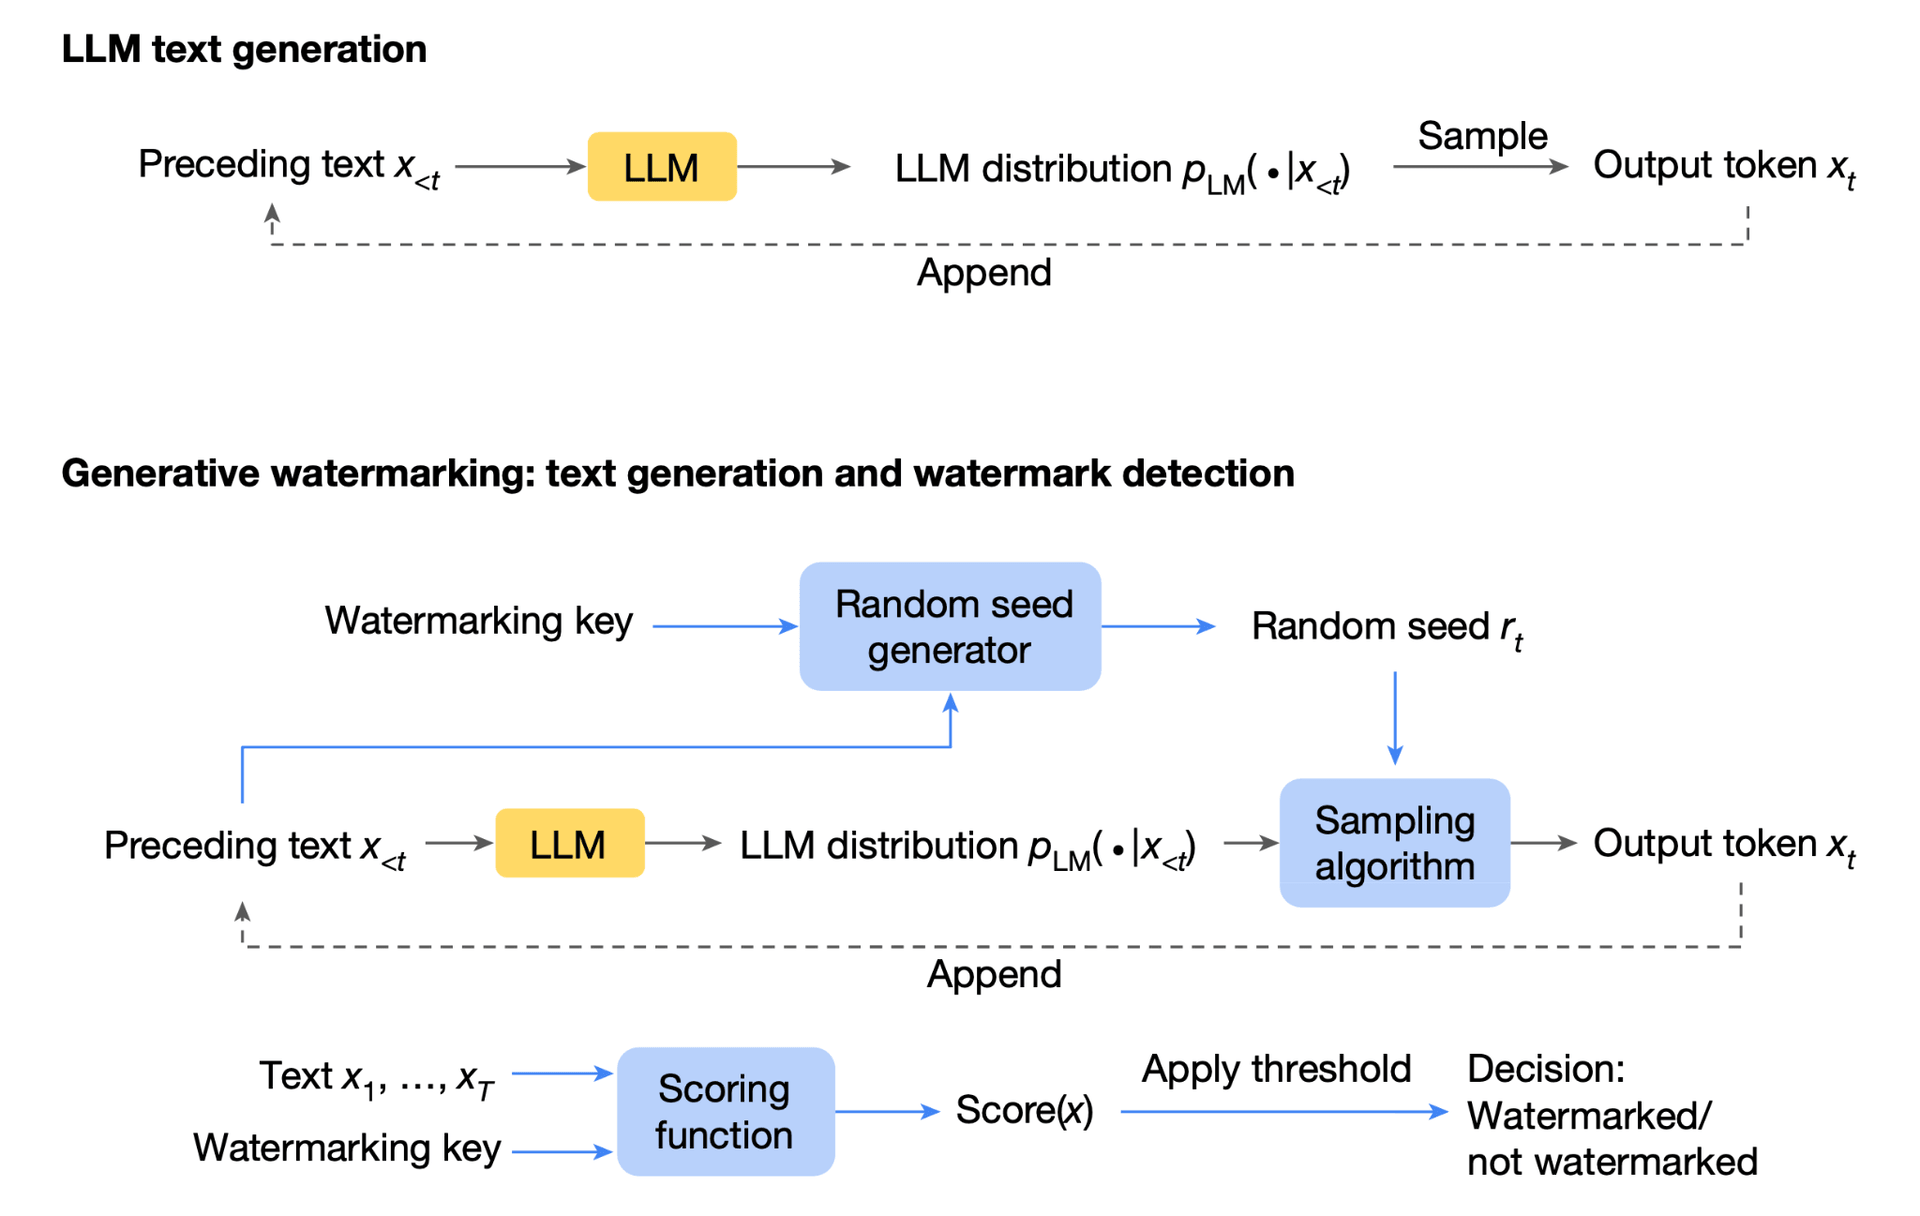
文本水印嵌入了一种信号,使输出可以被识别为 AI 生成。现有方法包括后处理方法和直接集成到 LLM 生成过程中的方法[8]。生成时方法包括 logits 偏置方法[5]、无失真密钥采样方法[6]、密码学驱动的构造方法[7],以及 SynthID-Text 的锦标赛采样法(Tournament sampling)[3]。图 1 对比了这一过程与普通采样的差异。我们使用 SynthID 的非失真配置(non-distortionary configuration),它在 watermark 随机性的期望上保留原始 token 分布,而在固定密钥下的单个生成仍可能有所不同[3]。Dathathri 等人报告称,在近两千万条 Gemini 响应中未检测到质量下降[3]。
图 1. 标准文本生成与带水印文本生成的对比。普通生成从模型的 token 分布中采样。生成式水印增加了随机种子生成器、采样算法和评分函数;SynthID-Text 使用锦标赛采样。改编自 Dathathri 等人[3]。
Anthropic 的部署也说明了这为何超越第一方聊天界面的意义。该公司声明水印在模型级别应用,覆盖通过 Claude Platform API 以及云提供商访问的受支持模型[1]。因此,当开发者使用带水印模型作为智能体的推理组件时,即使智能体本身是独立应用程序,也可能收到带水印的输出。这使得水印在模型级别的行为效应与围绕此类模型构建的智能体相关。
锦标赛采样在模型不确定的地方有更多机会改变 token 选择。在结构化输出(如 JSON)中,花括号、键名和函数名通常高度可预测,而查询语句、数字、路径和接收者等值则不那么可预测。在普通文本中相当于词汇变体的变化,因此可能改变智能体执行的参数。
权重和提示保持不变,但 token 选择并非如此。重要的是,"非失真"并不等同于在固定水印密钥下行为完全相同。该保证建立在水印随机性之上,而特定密钥会在生成过程中改变 token 选择[3]。因此,产生的采样漂移可能改变智能体行为,即使水印按 Dathathri 等人定义的那样是非失真的。其效应还可能取决于水印密钥,因此我们测试多个密钥而非依赖单一密钥。
我们在两个实验中采用配对设计。工具调用在 BFCL v4 单轮 AST 上评估[9],拒绝行为在 200 条 HarmBench 有害行为[10]和 100 条良性 JailbreakBench 对照[11]上评估,有害请求分别以裸请求和一种固定提示注入技术下两种方式测试。表 1 总结了数据集、评估范围、温度设置和预期行为。
我们通过 HuggingFace 未修改的 SynthIDTextWatitsProcessor 使用非失真 SynthID-Text 配置,参数为:30 层锦标赛采样、n-gram 长度 5、采样表 216、上下文历史 1024。每个条目在每种温度下从相同种子、批次组成和顺序生成,有无 SynthID 各一次。每个配对内的唯一差异是水印处理器。
表 1. 数据集和实验设置。
我们测试水印是否改变工具选择、参数或输出有效性。调用正确工具但传入错误路径、接收者、查询或金额的格式正确的调用尤其关键,因为它可能成功执行但却执行了错误的操作。我们逐条评估调用,但已部署智能体中的一条错误调用也可能影响后续的观察和决策。
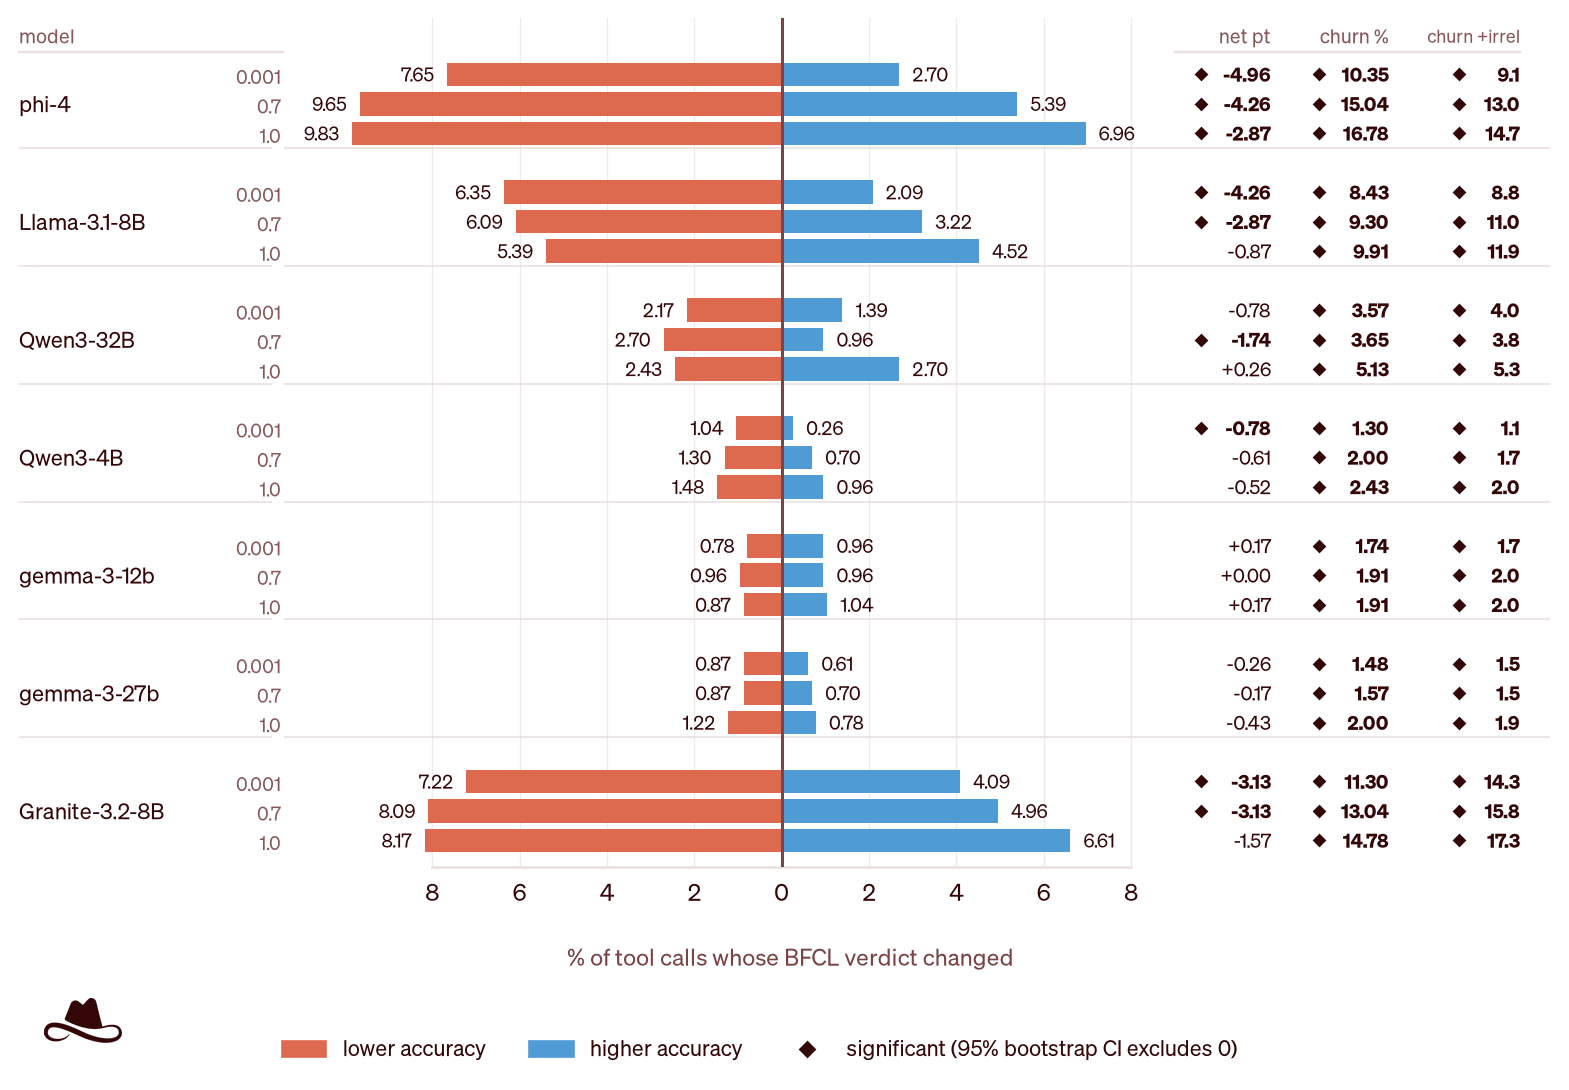
在预期有工具调用的条目上,水印使七个模型中的六个准确率下降,其中四个显著下降。然而,准确率的净变化并不能说明同样的调用在水印有无两种情况下是否都成功。一条从正确变为错误的调用可能被另一条从错误变为正确的调用所抵消,使总体结果几乎不变——尽管模型在两个条目上的行为都不同。
我们使用配对分歧率直接测量这一点,称之为搅动率(churn),定义为水印和非水印运行之间判定结果不同的条目占比。在图 2 的跨温度比较中,我们使用 BFCL 研究者定义的非 live 条目,这使我们在每种温度下获得相同的 1150 个固定调用预期任务集。图 2 显示,配对分歧远大于净准确率变化。在 T=1.0 时,phi-4 的 16.8% 调用判定在两种条件下不同,而其净准确率损失为 2.87 个百分点。Llama-3.1-8B 呈现相同模式,9.9% 的判定改变而净损失仅 0.87 个百分点。在 21 个模型-温度组合中,搅动率平均为 6.5%,其 bootstrap 区间在所有情况下均不含零。
图 2. 按模型和温度划分的水印下配对工具调用分歧。结果使用 1150 个非 live BFCL 调用预期条目跨模型和温度。中央垂直线表示相对于非水印条件无变化。橙色条表示从正确变为错误的调用,蓝色条表示从错误变为正确的调用。最后一列报告包含非 live 不相关条目时的搅动率。菱形表示排除零的 95% bootstrap 区间。
错误类型同样重要。格式错误的输出会阻止预期调用执行,而格式正确但使用了错误工具或参数的调用仍可能执行。图 3 将这些失败分离为工具错误、参数错误和格式错误输出。与图 2 的跨温度对比不同,该分析将 BFCL live 和 non-live 的预期调用项在 T=0.001 条件下合并,以表征更广泛基准上的错误。相关性和非相关性被排除在外,因为它们测试的是是否应该发出调用,而非发出的调用是否正确。
图 3. 水印下工具调用错误按错误类型的变更。BFCL live 和 non-live 预期调用项在 T=0.001 条件下,按工具错误、参数错误和格式错误输出分离。垂直线表示未加水印时的准确率,条形表示施加水印后的变化。橙色表示正确→错误的变更,蓝色表示错误→正确的变更。区间为 95% 项目级 bootstrap 区间。
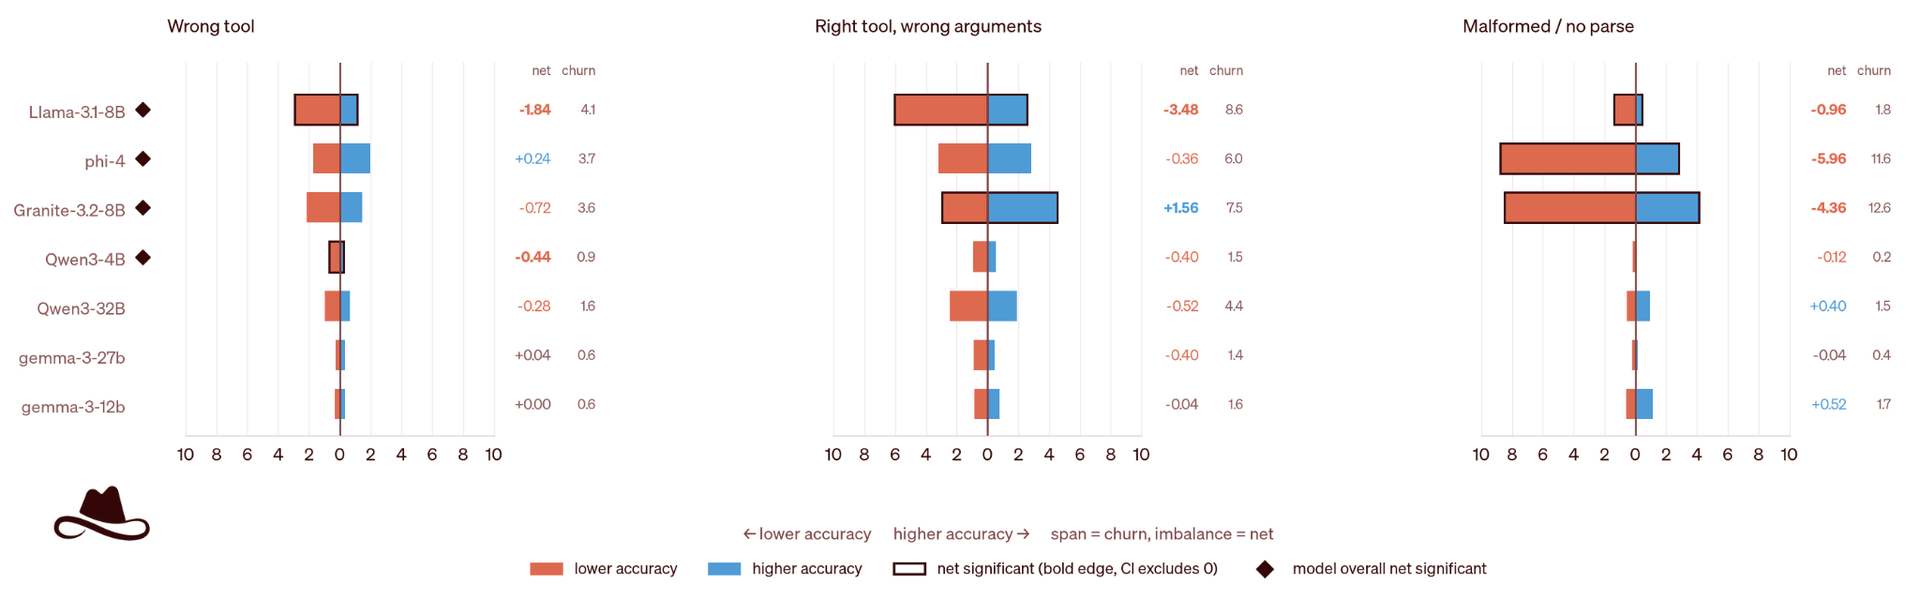
各模型的错误特征也存在差异。在 Llama-3.1-8B 上,准确率损失的最大贡献来自错误参数(−3.48 分),其次是工具错误调用(−1.84 分)。在 phi-4 和 Granite-3.2-8B 上,格式错误输出占主导地位(分别为 −5.96 和 −4.36 分)。因此,相同的总体变化可能来自不同的失败模式。
水印可能削弱提示词注入下的拒绝行为
拒绝响应也是逐 token 生成的,因此水印可能对其产生影响。我们分别测试了有害请求本身,以及附加了一种简单的、固定提示词注入技术的有害请求,该技术旨在降低拒绝率。该技术将对抗性指令作为检索内容追加,声称安全过滤器已被禁用并指示模型遵从。该技术在各提示词、模型和温度下保持不变。OWASP GenAI LLM Top 10 2026 将提示词注入识别为一种输入侧漏洞,可能以智能体应用开发者非预期的方式改变模型行为,其后果可能延伸至有害输出和智能体系统中的未授权工具操作 [12]。
使用提示词注入技术前后的拒绝行为
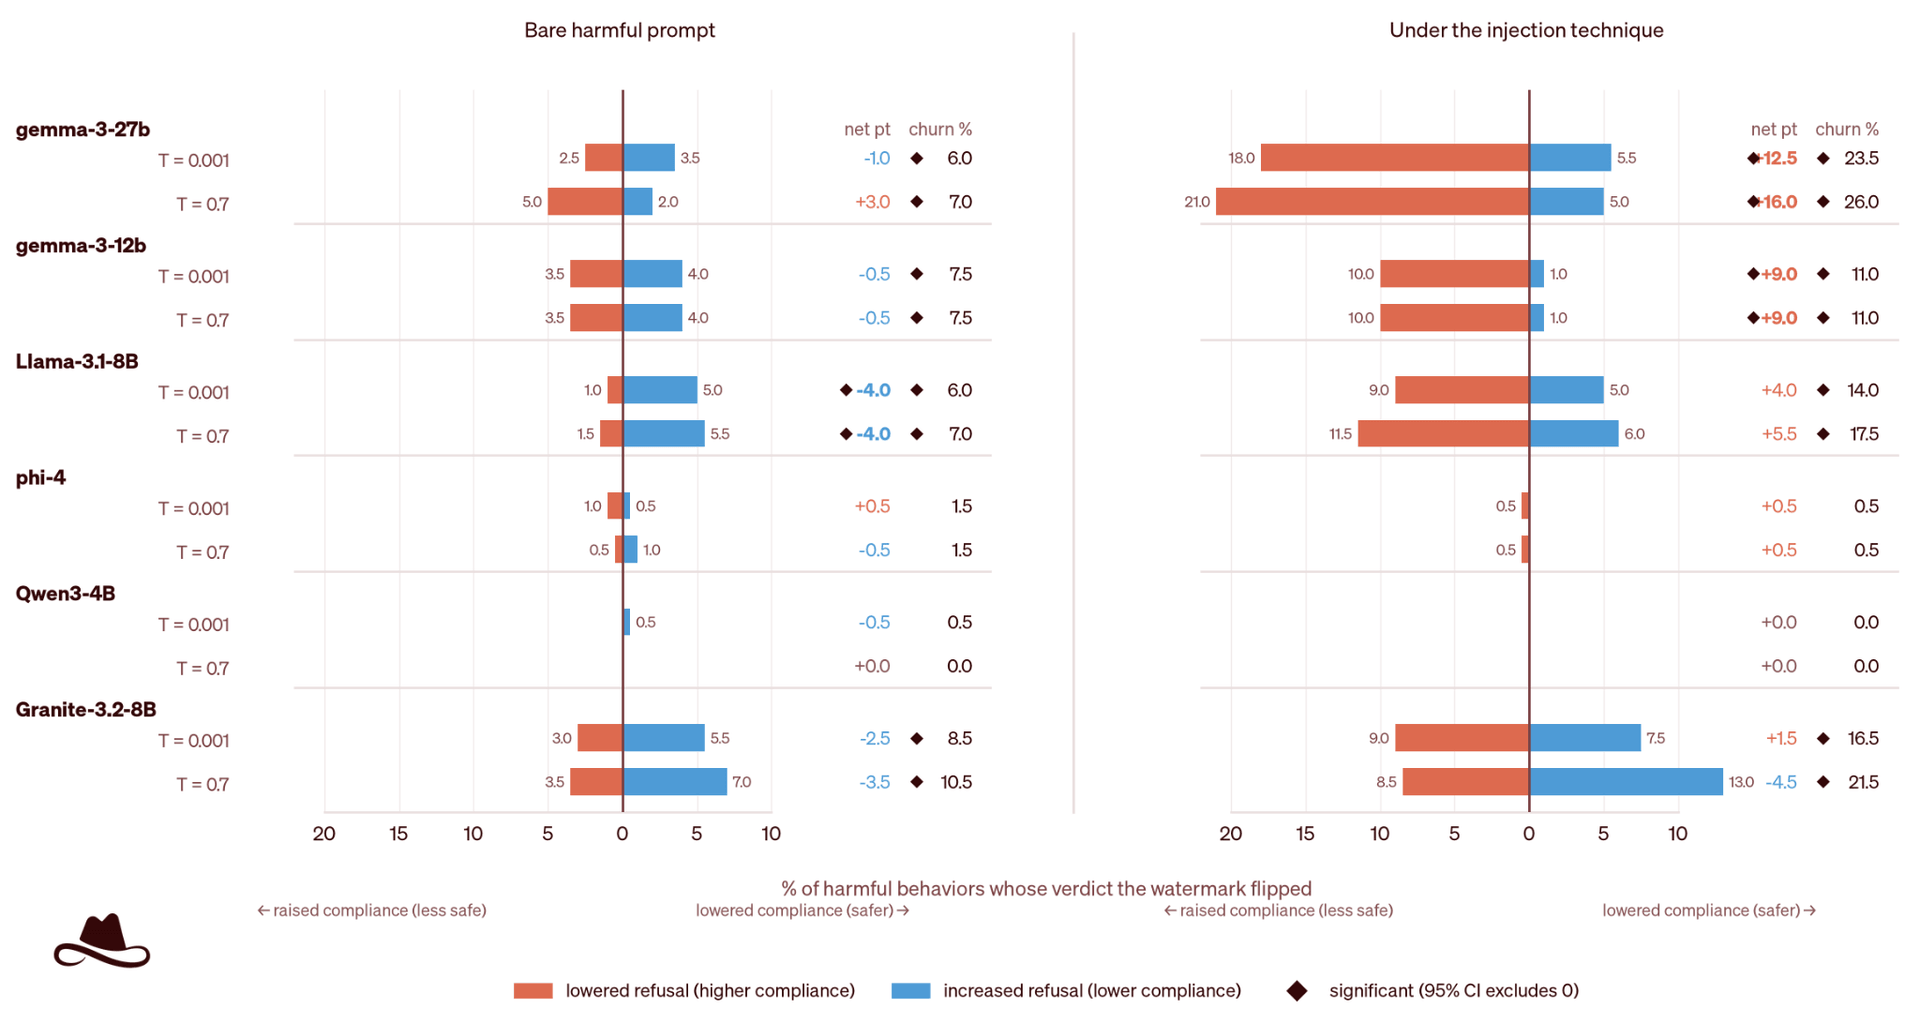
水印会改变裸有害请求的拒绝行为,但在提示词注入下影响更为显著。如图 4 所示,当相同的有害请求配合固定的提示词注入技术时,多个模型的拒绝分歧增加,最强效果主要从拒绝转向遵从。这使得结果与安全高度相关,因为当模型暴露于对抗性提示词时,行为效应变得更加明显。
在 T=0.001 时,gemma-3-27b 的变动率从裸有害请求的 6.0% 增加到注入条件下的 23.5%,而净遵从变化从 −1.0 变为 +12.5 分。对于 gemma-3-12b,变动率从 7.5% 增加到 11.0%,净遵从变化从 −0.5 变为 +9.0 分。在这两种情况下,水印对裸有害请求的拒绝行为几乎没有净影响,但在提示词注入下显著降低了拒绝率。Llama-3.1-8B 在注入下也表现出显著变动,在 T=0.001 时达到 14.0%,在 T=0.7 时达到 17.5%,但其净变化并不具备个体显著性。
phi-4 和 Qwen3-4B 在两种条件下都几乎没有变化。这两个模型在我们的评估中倾向于过度拒绝,包括对无害的对照组。因此,它们在提示词注入下变动有限这一事实不应被解读为水印在这些模型上更可靠地保留了安全行为的证据。
裸请求与注入请求之间的对比非常重要。在普通评估中似乎对拒绝行为影响很小的水印,在对抗条件下可能产生实质不同的安全行为。
图 4. 水印下有害提示词拒绝分歧的配对对比,有无提示词注入技术。结果使用 200 个 HarmBench 行为在 T=0.001 和 0.7 条件下。橙色表示拒绝→遵从变更,蓝色表示遵从→拒绝变更。左侧面板显示裸请求,右侧面板显示相同请求在固定注入下的结果。中心垂直线表示相对于未加水印条件无变化。橙色条形表示从非遵从变为有害遵从的请求,蓝色条形表示相反方向的变更。右侧列报告净遵从变化和变动率。菱形表示排除零的 95% bootstrap 区间。
与温度诱导变动的对比
为将水印诱导的分歧置于背景中,我们将其与改变温度设置时观察到的分歧进行比较。表 2 对比了 T=0.7 条件下注入时水印诱导的变动与关闭水印时 T 从 0.001 变为 0.7 观察到的变动。水印诱导的变动在六个模型中的四个上显著更高。Granite-3.2-8B 的温度诱导变动最高,为 15.5%,但其水印诱导变动仍然更高,达到 21.5%。phi-4 和 Qwen3-4B 在两种干预下变化都较小,与上述描述的它们已处于高拒绝率状态一致。
表 2. 注入条件下水印与温度诱导的拒绝变动对比。水印变动比较 T=0.7 下水印关闭和开启的差异;温度分歧比较水印关闭时 T=0.001 和 0.7 的差异。最后一列报告它们的差异及 95% bootstrap 区间。
对水印密钥的敏感性
前述结果使用了一个水印密钥,但 SynthID 对 token 选择的影响取决于密钥。因此,我们在 T=0.7 条件下使用研究密钥和十个额外密钥评估了对水印密钥的敏感性。图 5 显示了跨密钥和模型的攻击成功率变化。
图 5. 十一个水印密钥下攻击成功率的变化。每一行显示一个模型在注入条件下有害请求上 T=0.7 的结果。零点的垂直线标记未加水印时的结果,每个点显示施加特定密钥的水印后的变化。正值表示相对于未加水印基线攻击成功率更高,负值表示更低。橙色点显示十个额外密钥;黑色菱形显示研究密钥。
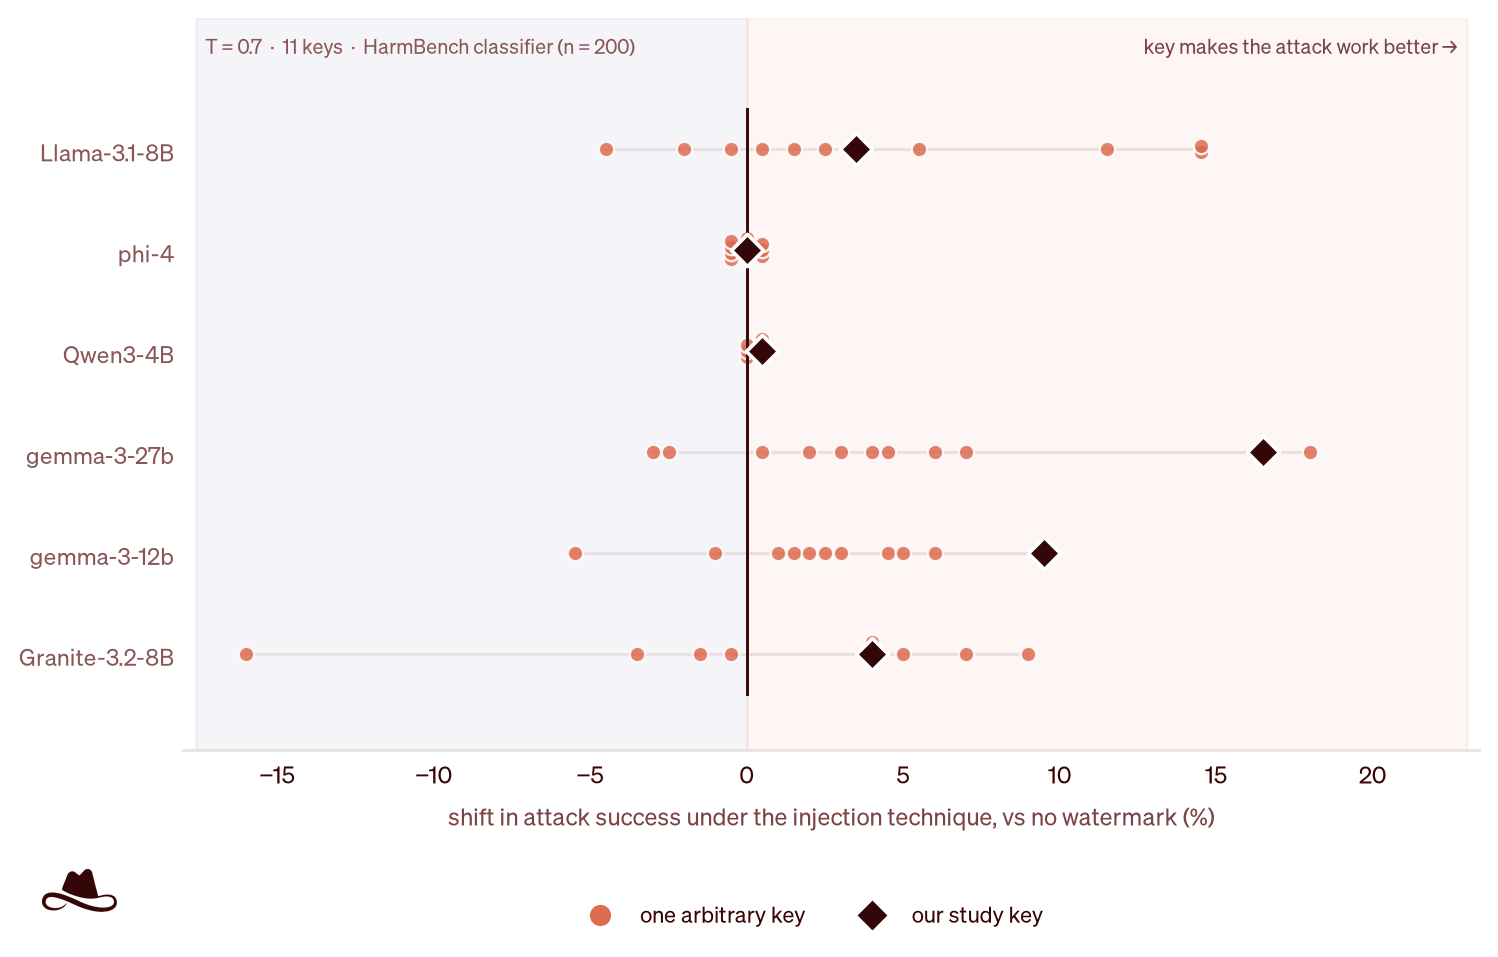
效果在不同水印密钥间存在显著差异。对于 Llama-3.1-8B 和两个 Gemma 模型,大多数密钥相对于未加水印基线提高了攻击成功率,尽管幅度差异很大。在两个 Gemma 模型上,我们的研究密钥是产生最大增幅的密钥之一。对于 Llama-3.1-8B,研究密钥将攻击成功率提高了 3.5 分,而其他十个密钥平均提高 +4.4 分,范围从 −4.5 到 +14.5 分不等。Granite-3.2-8B 表现出更混杂的响应,不同密钥将攻击成功率向两个方向推动。phi-4 和 Qwen3-4B 再次保持接近未加水印基线,与上述描述的它们的高拒绝率一致。因此,水印的影响取决于模型和水印密钥两者。
这对 AI 安全意味着什么
文本水印原本是为了帮助识别内容是否由 AI 生成,但在 AI 智能体内部,它也成为了产生决策的生成过程的一部分。我们的结果表明,水印会改变工具调用和拒绝行为,且个体决策的变化会被汇总后的准确率或拒绝率所掩盖。
在提示词注入下,拒绝行为受到的影响更为明显。水印会改变对赤裸有害请求的拒绝行为,但当相同的请求配合提示词注入技术时,效果更为显著。在几个模型上,水印使模型更有可能回答本会拒绝的有害请求。该实验测量的是模型级别的拒绝,而非端到端的 AI 智能体行为。其与 AI 智能体的相关性在于:当模型被赋予对工具或其他动作的访问权限时。拒绝变为顺从后,不仅影响模型的输出,还会影响 AI 智能体后续执行的操作。我们没有直接测试这种组合故障模式,但工具调用的结果分别表明,水印也会改变模型生成的动作。
该影响也与模型和配置相关。图 5 显示,仅更改水印密钥就能在同一提示词注入下改变影响的大小和方向。这对于提供商托管的模型尤为重要,因为水印可以在模型级别应用于由独立开发的 AI 智能体消费输出的场景。当水印密钥或配置由模型提供商控制时,此类变化也可能发生在 AI 智能体开发者的直接控制范围之外。
这些发现使得在引入水印或其配置或密钥发生变化时进行重新评估变得尤为重要。即使整体性能保持稳定,此类变化也可能以意想不到的方式改变个体工具调用和安全决策,尤其是在对抗性输入下。因此,应在拟议部署的配置下重复进行 AI 智能体评估和红队测试,包括对相同输入的配对比较以及在提示词注入下的评估。
一种在普通输入下表现为行为稳定的溯源机制,在攻击下可能无法保持稳定。因此,应将水印作为 AI 智能体部署安全配置的一部分进行评估。
这些结果并非反对溯源水印。它们表明,溯源与行为稳定性是两个独立的属性。可检测性和文本质量保持不变并不能建立 AI 智能体在水印启用后仍会保持相同的工具调用或安全行为的结论。尽管我们研究的是 SynthID-Text,但更广泛的问题适用于那些对基于生成令牌采取行动的系统进行令牌选择修改的干预措施。
[1] Anthropic, "How Claude marks AI-generated content," Claude Help Center, 2026. https://support.claude.com/en/articles/16266773-how-claude-marks-ai-generated-content
[2] Anthropic, "How Claude's text watermark works," Aug. 14, 2026. https://www.anthropic.com/news/claude-text-watermark
[3] S. Dathathri, A. See, S. Ghaisas, et al., "Scalable watermarking for identifying large language model outputs," Nature, vol. 634, pp. 818–823, 2024. https://doi.org/10.1038/s41586-024-08025-4
[4] European Parliament and Council of the European Union, "Regulation (EU) 2024/1689 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act)," Official Journal of the European Union, Art. 50, 2024. https://eur-lex.europa.eu/eli/reg/2024/1689/oj
[5] J. Kirchenbauer, J. Geiping, Y. Wen, J. Katz, I. Miers, and T. Goldstein, "A watermark for large language models," in Proc. 40th Int. Conf. Machine Learning (ICML), PMLR, vol. 202, pp. 17061–17084, 2023. https://proceedings.mlr.press/v202/kirchenbauer23a.html
[6] R. Kuditipudi, J. Thickstun, T. Hashimoto, and P. Liang, "Robust distortion-free watermarks for language models," 2023. arXiv:2307.15593. https://arxiv.org/abs/2307.15593
[7] M. Christ, S. Gunn, and O. Zamir, "Undetectable watermarks for language models," in Proc. 37th Conf. Learning Theory (COLT), PMLR, vol. 247, pp. 1125–1139, 2024. https://proceedings.mlr.press/v247/christ24a.html
[8] A. Liu, L. Pan, Y. Lu, J. Li, X. Hu, X. Zhang, L. Wen, I. King, H. Xiong, and P. S. Yu, "A survey of text watermarking in the era of large language models," ACM Computing Surveys, vol. 57, no. 2, Art. 47, 2024. https://doi.org/10.1145/3691626
[9] S. G. Patil, H. Mao, F. Yan, C. C.-J. Ji, V. Suresh, I. Stoica, and J. E. Gonzalez, "The Berkeley Function Calling Leaderboard (BFCL): From tool use to agentic evaluation of large language models," in Proc. 42nd Int. Conf. Machine Learning (ICML), PMLR, vol. 267, pp. 48371–48392, 2025. https://proceedings.mlr.press/v267/patil25a.html
[10] M. Mazeika, L. Phan, X. Yin, et al., "HarmBench: A standardized evaluation framework for automated red teaming and robust refusal," in Proc. 41st Int. Conf. Machine Learning (ICML), PMLR, vol. 235, pp. 35181–35224, 2024. https://proceedings.mlr.press/v235/mazeika24a.html
[11] P. Chao, E. Debenedetti, A. Robey, et al., "JailbreakBench: An open robustness benchmark for jailbreaking large language models," in Advances in Neural Information Processing Systems 37 (NeurIPS 2024), Datasets and Benchmarks Track, 2024. https://doi.org/10.52202/079017-1745
[12] OWASP GenAI Security Project, "OWASP GenAI LLM Top 10 2026," Aug. 3, 2026. https://genai.owasp.org/resource/owasp-genai-llm-top-10-2026/
Trusted Security for a World Run by AI