
8.0
热点
AI SCORE
编程提效2026-09-27 00:02
125B MoE模型本地运行:3090三卡80 tokens/s优化实践
dev.to · AI#llama.cpp#MoE#本地部署
Editor brief · 编辑速览
通过专家排序、分精度存储和llama.cpp补丁将Qwen3.8-Flash-Next在3张3090上从23 tokens/s提升到80 tokens/s。
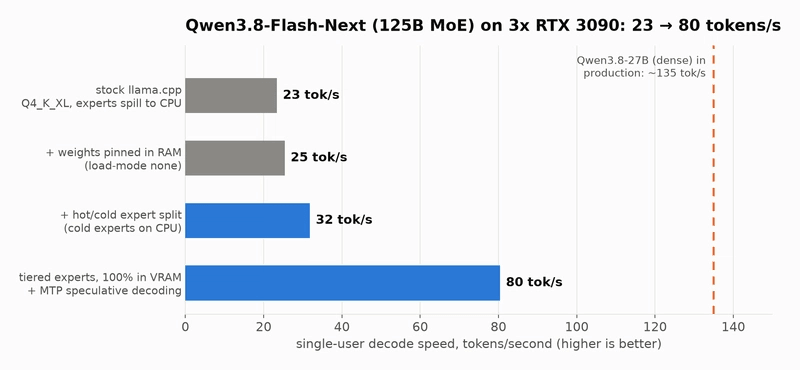
TL;DR:Qwen3.8-Flash-Next 是一个 125B 的混合专家模型:从纸面数据看,它比我在生产环境到处跑的 Qwen3.8-27B 在 agent 编程上高了 16.5 分。它塞不进我三张 RTX 3090 的 72 GB VRAM,原生 llama.cpp 把四分之一的专家塞到系统 RAM 里,只能跑 23 tokens/秒。三个改动让它跑到 80 tokens/秒,全部留在 VRAM:
按使用频率给专家排序。它们严重不均衡:最忙的 25% 承担了 52% 的工作量。
用三种精度存储。热门专家保留更多位数,冷门专家压得更狠,让整个模型能装进 GPU。
给 llama.cpp 打补丁(~400 行),让一次路由决策同时驱动三张专家表,然后在上面叠上投机解码。
质量接近 8-bit 基准:perplexity 上升 1.9%,下一个 token 的 91% 与基准一致,GSM8K 95.5%(同标准下 27B 得分 95–96.5%)。还有一个 256k 上下文配置,能在 173,000 token 深处找到一段随机代码。权衡是真实存在的,我都列出来了。所有东西都是开放的:补丁、工具、原始测量数据。
我的机器 vader 全天候跑 Qwen3.8-27B:两张 RTX 3090,vLLM,大约 135 tokens/秒。它是我第一款真正放心用于 agent 工作的本地模型,助手的大部分工作都由它完成。
然后 Qwen 发布了 Qwen3.8-Flash-Next,也就是 Qwen4 架构的预览版。他们的模型卡在几乎所有我关心的指标上都超过了我的 27B:
所以目标很明确:在同样的三张卡上跑更聪明的模型,解码速度和首个 token 时间(TTFT)还要有交互感。不加新硬件。我告诉我的 AI 工程师(Claude Code,结尾会再提到):“不行”不是可接受的答案。
GPU:3 张 RTX 3090,每张 24 GB:共 72 GB VRAM。没有 NVLink,也没有 PCIe peer-to-peer(主板没有 ReBAR),所以卡之间不能直接通信。
CPU:双路 Xeon E5-2660 v4,56 线程。
RAM:60 GB。每路 CPU 只有一个 32 GB 内存条,所以是单通道,这一点在后面影响很大。
在开始之前,先来一个小词典
如果你知道什么是 KV cache,可以跳过这节。如果不知道,它是你读懂全文的关键。
参数 / 权重。模型学到的那些数字。"125B" 就是 1250 亿个参数。每个通常占 2 字节,所以 125B 参数约 250 GB,远超 72 GB VRAM。
VRAM。GPU 自带的内存。在这个机器上比系统 RAM 快大约 20–50 倍。模型要跑得快,每个词需要的东西必须待在 VRAM 里。
量化。用更少的位(8、4、3…)来存储每个权重,而不是 16 位。就像把照片存成更小的 JPEG:文件小了,细节少了一点。"Q8_0"、"Q4_K"、"IQ3_S"、"MXFP4" 是 llama.cpp 给不同位预算和配方起的名字。
混合专家(MoE)。不是一个大网络,而是每层有很多小的“专家”网络,这里有 512 个,路由器为每个词挑选最合适的 10 个。所以模型知道 125B 参数的知识,但每个词只实际计算约 6B。这就是它能跑得快的原因,也是它体积大的原因。
Token。一个词或词片段。解码速度(tokens/秒)就是答案流出的速度。
预填充 / 首个 token 时间(TTFT)。在回答之前,模型要读完你的整个提示。这就是预填充,TTFT 就是你等多久才看到第一个词出现。
上下文 / KV cache。模型一次能在脑子里放多少文本("256k context"约 500 页),以及用来记住这些文本的内存。
n-gram 嵌入。这个模型的新特性:一个 51 GB 的查找表,用 2–3 个词的短语做索引。它只会查表,每个词只查几行,所以可以放在 NVMe 盘上。
投机解码 / MTP。一个小的内置“草稿头”猜测接下来的几个词,然后大模型一次验证所有猜测。猜对的词是免费的。
KL 散度(KLD)。压缩模型的词概率偏离原始模型多远。0 表示完全一致,越低越好。它是最敏感的质量仪表。
llama.cpp / GGUF。我打了补丁的推理引擎,以及它的模型文件格式。
一个问题,一张图
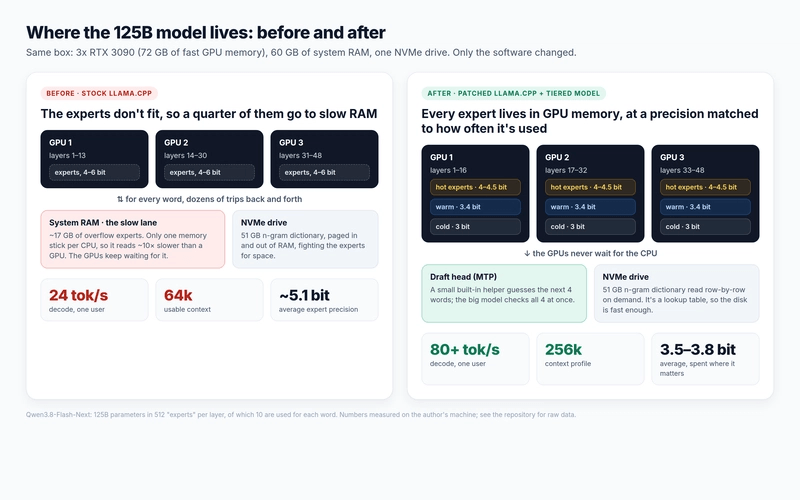
16 位模式下模型是 360 GB。即便是流行的 4-bit 版本(unsloth 的 UD-Q4_K_XL)也有 111 GB:72 GB 专家 + 27 GB n-gram 表(可以留在磁盘上)+ 几 GB 的其他东西。专家本身在 72 GB VRAM 里就放不下,更别提模型其余部分和上下文还需要空间。所以 llama.cpp 做了合理的事:把溢出的专家放到系统 RAM 里,用 CPU 来计算。
在这个机器上这意味着 23 tokens/秒。每路 CPU 只有一个内存条,CPU 读这些专家比 GPU 慢约十倍。而且每个词工作都要在 GPU 和 CPU 之间来回几十次,所以每个 GPU 都在等待。
第一步:显而易见的配置,和第一个陷阱
用默认设置第一次跑也到处看到预填充(同一个 4k 提示下 47 到 306 tokens/秒),解码更是掉到了 10 tok/s。线程状态揭示了原因:主线程卡在 D 状态(等待磁盘)。llama.cpp 内存映射模型文件,加载 GPU 部分时 70+ GB 通过页缓存流进来,而 CPU 侧的专家不断被驱逐、从 NVMe 重新读取。
--load-mode none 把 CPU 侧的权重加载到 RAM 里并保持在那里。另外, benchmark 时不要下载 188 GB 的文件:我的下载填满了页缓存,把服务器推到了 swap 里。两个都修复后,预填充翻倍(658–792 tok/s),解码稳定在 23–26 tok/s。
投机解码(MTP)几乎没用:24–29 tok/s。原因对后面的一切都很重要。5 个词的草稿意味着大模型一次检查 6 个词。每个词挑选 10 个专家,所以一次检查每层最多可能触达 60 个不同的专家,而不是 10 个,而且 CPU RAM 里的慢专家被击中的次数更多。只要专家还在 CPU RAM 里,其他任何优化都不会让它快起来。
第二步:专家不是平等的
这是整个项目的基础观察。llama.cpp 的校准数据(unsloth 随他们的量化发布的重要性矩阵)记录了 24,576 个专家在真实文本上各自被选中的次数:
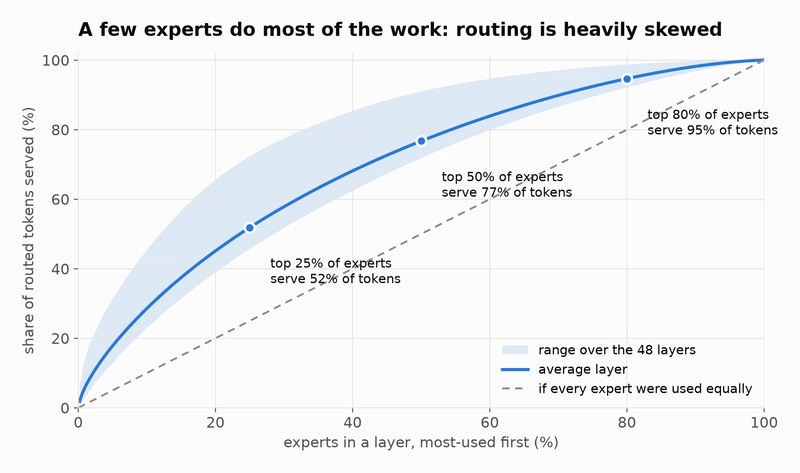
在平均层里,最忙的 25% 专家处理了 52% 的 token,最忙的 80% 处理了 95%。原生 llama.cpp 只能以整个层为单位放置专家:一层的 512 个专家是一个 tensor,要么全在 GPU 上,要么全在 CPU 上。它卸载了四分之一的专家,其中包括热门专家,所以大约四分之一的专家工作落到了慢速路径上。
第三步:把每层拆成热专家和冷专家
第一个补丁在加载时把每层的专家 tensor 拆成两部分:
热专家放到 GPU 上;
冷专家放到 CPU RAM 里;
路由器被重排,让它的选择落到正确的半边。
用同样的 19% 专家字节放在 CPU 上,冷专家现在只服务 4.5% 的路由 token,而不是约 19%,慢速路径流量减少了约 4 倍。
做对花了四个 bug,每个都值得单独列一节来说明。结果是 30–32 tok/s,答案正确。但这不该只有这点提升,所以我去 profile 了一下:
CPU 几乎不再读专家了;是往返次数在损耗。每个层都把工作交给 CPU 然后等待答案。然后一个廉价的实验:直接把冷专家丢掉(质量垃圾,只看速度),看全在 GPU 上能跑多快:52 tok/s,叠上投机解码 86–88 tok/s。这就是目标。问题变成了:怎么把每个专家都塞进 VRAM 而不破坏质量?
第四步:三个架子,全部在 GPU 上
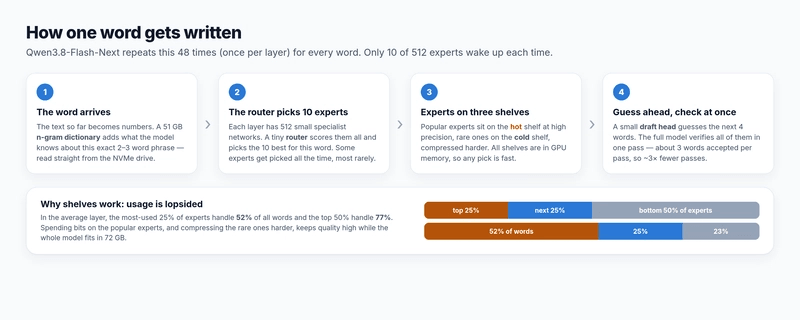
思路:如果有些专家干了大部分工作,就给它们更多位数,把不常用的压得更狠。一切都还能放进 VRAM,大部分 token 仍然看到的是一个保存良好的专家。可以把它想成一个图书馆,把畅销书用精装保存,把借阅量低的书打印成紧凑的平装书,这样整个收藏都能放进大楼里。
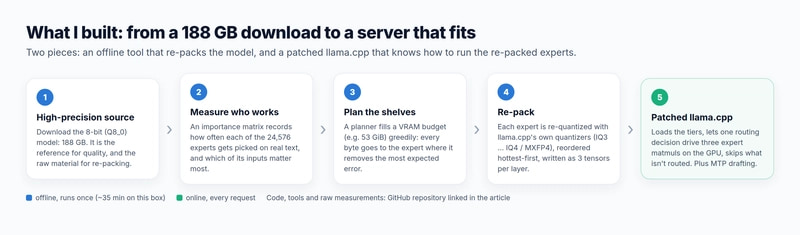
两个部分让它运转起来。
一个离线重新打包器(tools/expert_tiers.py)。它从 8 位模型(188 GB)出发,用重要性矩阵来衡量每个专家的使用频率以及其内部哪些输入重要。一个贪心规划器填满 VRAM 预算:每一字节都去到那个字节能消除最多预期误差的专家。然后每个专家用 llama.cpp 自己的量化器重新量化,文件按热到冷排序写入,每层三个 tensor。有一个细节:down-projection 矩阵行宽是 640,这种花哨的 2–3 位格式处理不了(需要 256 的倍数)。所以它们有自己的阶梯:IQ4_NL / MXFP4,而不是 IQ4_XS / IQ3。
一个打了补丁的 llama.cpp(patches/)。mul_mat_id,这个执行“每个词通过其选中的专家”的操作,学会接受一个 id 范围。每个架子的矩阵乘法看到路由器的完整选择列表,只计算落在自己架子上的 id,其余填零。三个结果直接相加。这意味着要改 CPU kernel、三个 CUDA 路径(decode、prefill 和融合的 gate+up+activation kernel)以及加载器。最上面是 Qwen 的 multi-token-prediction 草稿头,来自一个还没合并的 llama.cpp PR,重新量化为 4 位,这样也能塞进去。
结果,一张图:
四个 bug,简单说一下
给想尝试的人,也因为其中两个挺有意思。
重复的专家会让 CUDA MoE kernel 崩溃。我的第一个版本把“不在这个架子上”指向专家 0。一个词有两个冷专家时,专家 0 就出现了两次,而 CUDA 的专家分组辅助函数假设每个专家在每个词里最多出现一次。它悄悄drop了一个槽位,后面的 kernel 读到了一个未写入的索引。修复方法是让 kernel 学会真正的“跳过”。
一个 flag 存在了精度设置的位置上。我在 op_params[0] 里标记了支持跳过的节点,而 llama.cpp 已经用它来存累加器精度。这个 flag 被悄悄覆盖了。移到了第 7 位,加了一个 magic value。
无符号三元式。ids ? ids[i] : blockIdx.x,其中 blockIdx.x 是无符号的。C++ 把整个表达式提升为无符号,所以我的 -1(“跳过”)变成了 4,294,967,295,kernel 读了缓冲区外 40 亿行。compute-sanitizer 一把就找到了。
融合 kernel 隐藏了 tag。对于 decode,CUDA 把 gate、up 和 activation 融合成一个 kernel,它的“目标”是 activation 节点,而不是携带我的 id-range tag 的矩阵乘法。第一个 id-range 构建输出了 ///////////。现在 kernel 在源节点上查找 tag。
损失了多少质量?
诚实的仪表是在 24,576 token 的维基百科文本上相对于 8 位模型的 KL 散度:
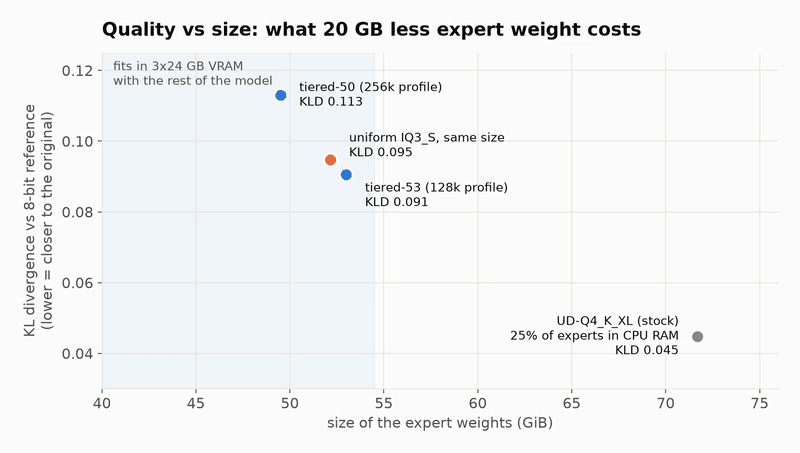
塞进 VRAM 要付出质量代价,这点绕不过去。专家权重少 20 GB 大致会让原生 4 位构建的 KL 散度翻倍。这是物理定律,不是 bug。
在同等大小下,分层优于均匀:perplexity 漂移 1.9% 对比 3.0%。但收益比我规划器预测的小:它的误差模型很粗糙,在这个大小下总字节数主导一切。用一个更好的分层配方还有更多可以挖。
在任务上,它经受住了。GSM8K(200 道小学数学题,贪心,无思维)得分 95.5%。27B 在同一标准下公布的数字是 95.0–96.5%。GSM8K 已经饱和了,所以这主要证明了没有东西坏掉。模型卡上在 agent 工作上的收益才是这次升级应该体现的地方。
速度 vs 上下文,以及 256k 配置
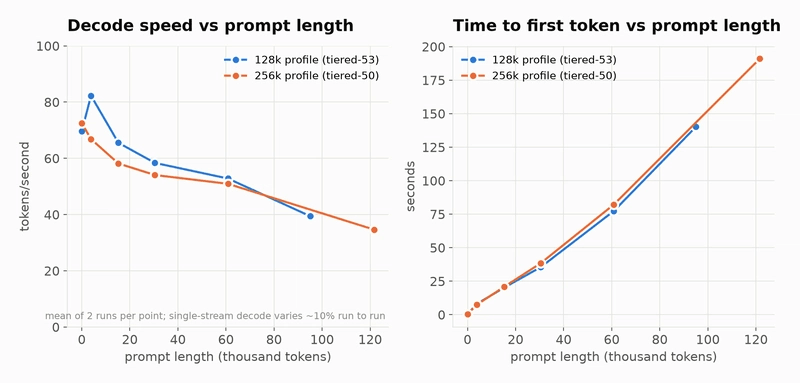
两个配置在短提示下都从约 80 tokens/秒开始,随着提示变长而减速。每个词的 attention 和索引器工作随上下文增长,草稿头的猜测也略微变差。典型数字,两次运行的平均:
预填充跑在 540–860 tokens/秒。那是相比 27B 约 1,300 的弱点,也是我下一步要看的:这也是让 120k token 提示等三分钟的部分。
256k 配置还需要两个额外的妥协。KV cache 降到 8 位,专家缩小到 49.5 GiB,因为稀疏 attention 索引器的 scratch 内存随上下文增长,在第一次尝试约 200k 时把一张卡推出了内存。重新平衡层到各卡之后,它读取了 173,692 token 的维基百科,其中在 45% 深度处藏了一个随机 10 字符代码,并返回了代码:完全正确(6BC5XYE8FS)。第二次运行,代码在 112,711 token 的 90% 深度处,同样精确。读取那么多内容花了 6.1 分钟(472 tokens/秒)。长上下文预填充在这个架构上仍然是慢的部分。
在卡层面测量(nvidia-smi,5 Hz,每个配置三次 1,024-token 生成):三张 3090 在解码时共同消耗约 540 W,模型加载后空闲时约 124 W。每 token 7.5–8.4 焦耳,每百万 token 2.1–2.3 kWh。按我的电价(白天 0.30 BGN/kWh,夜间 0.18),白天生成一百万 token 花费 0.63–0.70 BGN,夜间 0.38–0.42 BGN,约 0.35–0.40 美元。27B 同样一百万 token 花费 0.21–0.34 BGN,所以更大的脑子每个词大约贵一倍,三张卡都算进去了。这仍然是买咖啡的钱。
这是单用户的。这里所有东西一次只处理一个请求。27B 在 vLLM 上对多用户的批处理好得多。
27B 还是更快。解码约 135 对 80 tok/s,预填充约 1,300 对 540–860 tok/s。125B 更聪明,不是更快。
它用到了全部三张卡。你没法同时跑着 27B。
质量数字是 wikitext + GSM8K。它们说明压缩是温和的。它们没有证明 agent 收益完整保留;那需要我还没跑的 agent 基准测试。
分层规划器是一个启发式方法。测量数据说它有帮助;一个经过校准的会有更大帮助。
所有东西都在 SikamikanikoBG/qwen38-flash-next-3x3090:两个 llama.cpp 补丁、重新打包器、基准测试脚本,以及所有图表背后的原始数据。简略版:
# llama.cpp at 81bc6b8 + MTP PR #28243 + the tiering patch
git apply patches/0001-qwen4exp-mtp-pr28243.patch patches/0002-tiered-experts-hot-cold-split.patch
cmake -B build -DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES=86 && cmake --build build -j

# re-pack the 8-bit model into three precision shelves (53 GiB of experts)
python tools/expert_tiers.py write --src Qwen3.8-Flash-Next-Q8_0-00001-of-00006.gguf \
  --imatrix imatrix_unsloth.gguf --budget-gib 53 \
  --gu Q6_K,IQ4_XS,IQ3_XXS --dn Q8_0,IQ4_NL,MXFP4 --out fn-tier53.gguf

# serve: all layers on GPU, 128k context, MTP drafting 4 tokens
llama-server -m fn-tier53-00001-of-00002.gguf -ngl 99 -ts 16,16,16 -c 131072 \
  -b 1024 -ub 256 -fa on --jinja \
  -md mtp-shared-iq4.gguf --spec-type draft-mtp --spec-draft-n-max 4
Qwen,提供了模型和一个奖励这种工作的架构。
unsloth,提供了 GGUFs、MTP 草稿文件和重要性矩阵。
llama.cpp 和 ggml,以及 Qwen4Exp MTP PR 和稀疏 attention 衰减问题的作者们。
syv-ai/qwen38-27b-rtx3090,他们对 27B 的严谨态度为测量这个设定了标杆。
这个项目,从补丁和工具到测量和这篇撰写,都是和 Claude Code 完成的,它担任我的 AI 工程师,在我的硬件上按我的方向工作。数字来自 vader,原始数据在仓库里,错误是我们俩的。