
8.0
热点
AI SCORE
编程提效2026-09-26 18:30
Nvidia SoL-Pi系统让编程Agent token消耗减半
The Decoder#Nvidia#AI编程Agent#性能优化
Editor brief · 编辑速览
SoL-Pi通过优化模型与环境之间的控制层,使编程Agent的token使用量最高减少49%,性能几乎不变,测试了152种方案超3000次运行。
Nvidia 的新论文描述了一个自动优化编码 Agent 控制层(称为 harness)的系统。研究人员表示,Token 用量下降近一半,而性能基本保持不变。
AI Agent 在无人监管状态下运行得越久,成本就越高。单次推理会演变成冗长的推理链、工具调用和反馈循环,Token 用量也随之膨胀。
Nvidia 研究人员的这项新研究并非从模型层面,而是从 harness 层面来解决成本问题。Harness 是模型与其运行环境之间的控制层,Codex、Claude Code 或 OpenClaw 等系统都使用了这一层。
研究 AI 分析 Agent 执行轨迹、提出 harness 修改建议,只保留那些在降低成本的同时维持性能的方案。SoL-Pi 在 EdgeBench 上相比 Codex 节省 50%,相比 Claude Code 节省 54.3%。
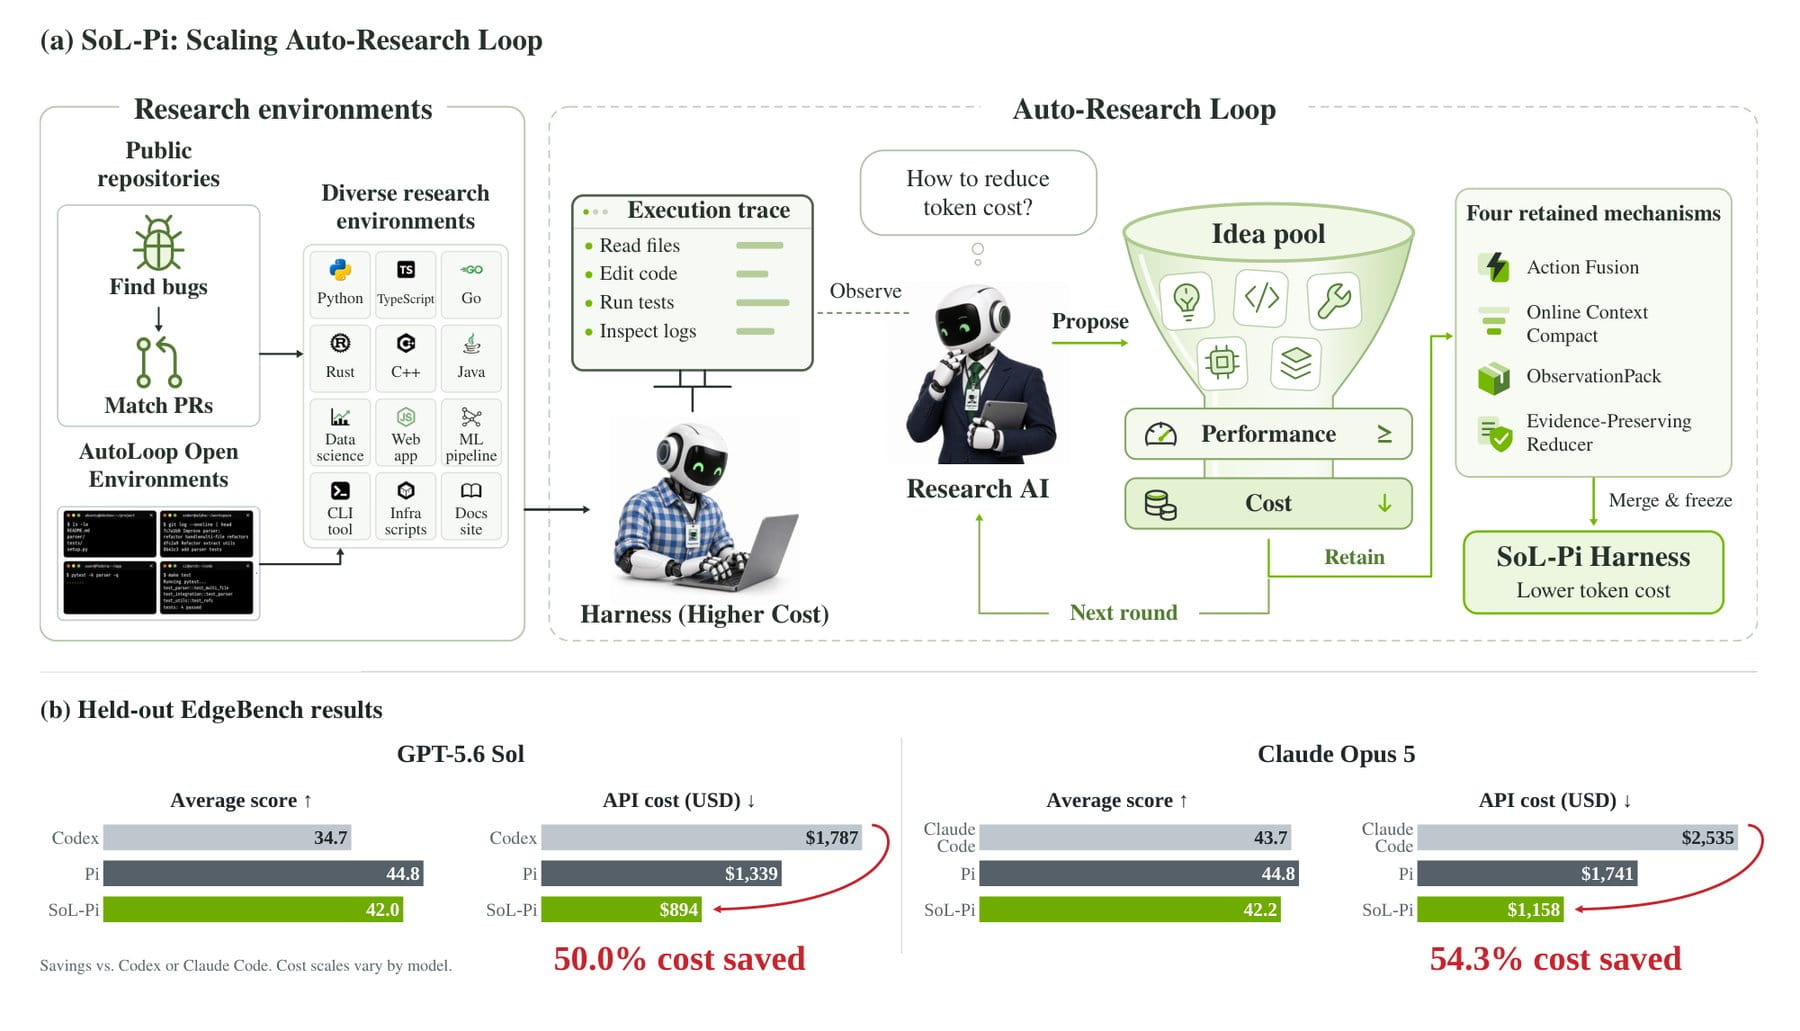
Harness 控制 Agent 如何观察状态、执行操作和处理反馈。迄今为止大多数效率优化方法都集中在通过更快的注意力核和服务基础设施、模型压缩(如量化)或替换更便宜的模型来降低每个 Token 的成本。
在实践中优化 harness 很困难,因为工具使用、上下文管理、验证和中止逻辑都紧密耦合。在一处节省 Token 的改动可能在别处引发错误,或者只是将成本推后到下一阶段。通常需要人工筛选冗长的执行轨迹,将反复出现的失败模式转化为代码。
这个名为 SoL-Pi 的系统将这项工作自动化了。研究 Agent 观察另一个 Agent 的执行轨迹,提出修改建议,并在准备好的环境中测试。能力和效率检查决定了哪些候选方案能够存活。据作者介绍,该方法借鉴了递归自我改进的思想。
评估只在 harness 冻结后才进行,且不会反馈到搜索过程中。
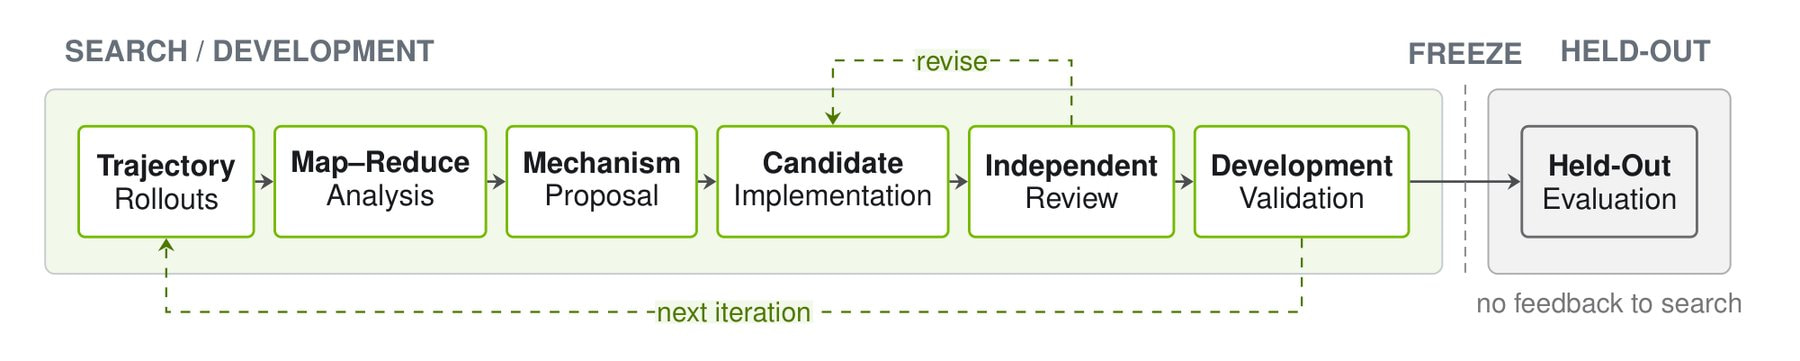
在 535 个可执行环境中,该系统探索了 152 个方向,包括从 GitHub issue-pull-request 对提取的 495 个任务和 40 个合成测试用例。整个过程生成了超过 3000 次运行和超过 60000 次 Agent-环境交互。研究人员表示,这一规模展示了系统的搜索广度,但更多搜索并不自动带来更好的结果。这是一个风险,因为之前的工作表明自动优化的 harness 往往会对训练任务过拟合,在陌生任务上收效甚微。
SoL-Pi 通过严格分离搜索反馈和评估来解决这个问题。研究人员使用 EdgeBench 作为测试基准,并将其完全隔离在搜索过程之外。在其 51 个公开任务中,他们用 11 个对完成的候选方案进行一次性验证。其余 40 个保留用于最终评估,且这些结果永不反馈到搜索中。
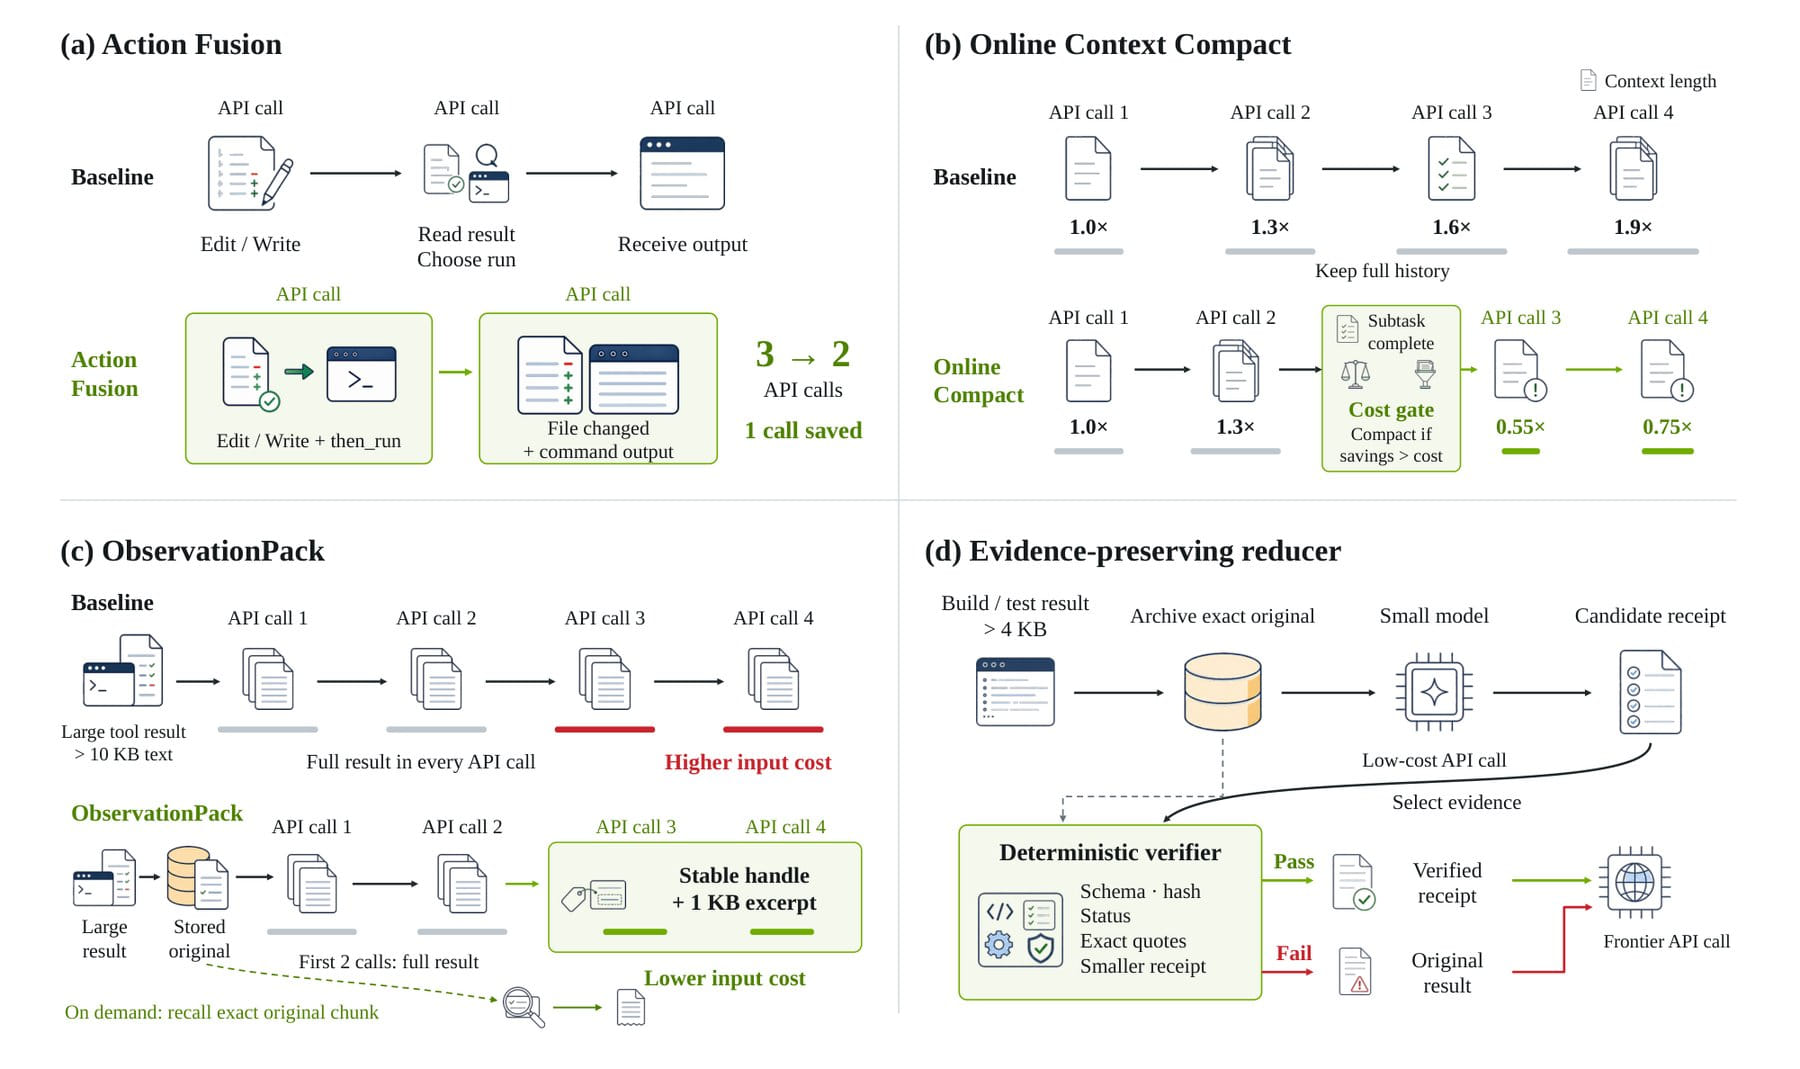
搜索产生了四种机制。Action Fusion 将两个连续步骤合并为一个,例如代码编辑后紧跟测试运行,这样就消除了一次完整的语言模型调用。Online Context Compact 在每个规划步骤后运行,在不丢失重要信息的前提下修剪累积的上下文。
ObservationPack 将冗长的工具输出存档,并在后续步骤中插入简短摘要,而不是每次都重新发送完整文本。Evidence-Preserving Reducer 将大型错误和测试日志路由到更便宜的模型,提取关键发现,并有一个自动验证步骤来捕捉任何遗漏的关键线索。
Nvidia 在 535 个可执行环境中搜索机制,并将 EdgeBench 保留用于最终评估。
在 EdgeBench 的 51 个公开任务上,SoL-Pi 的表现与原始 Pi harness 大致相当。研究人员表示,Token 用量下降多少取决于配置。最有效的变体结合了全部四种机制,Token 用量减少 49%,达到 Pi 分数的 93.7%。优先考虑性能的用户如果只选择最强的单一机制,则能以 5.3% 的优势超越 Pi 的分数,同时仍能节省 Token。在两种变体中,Token 用量下降幅度为 44.7% 到 49%。
SoL-Pi 的效率变体将 Token 用量减半,成本从 $1339 降至 $894,分数略有下降。
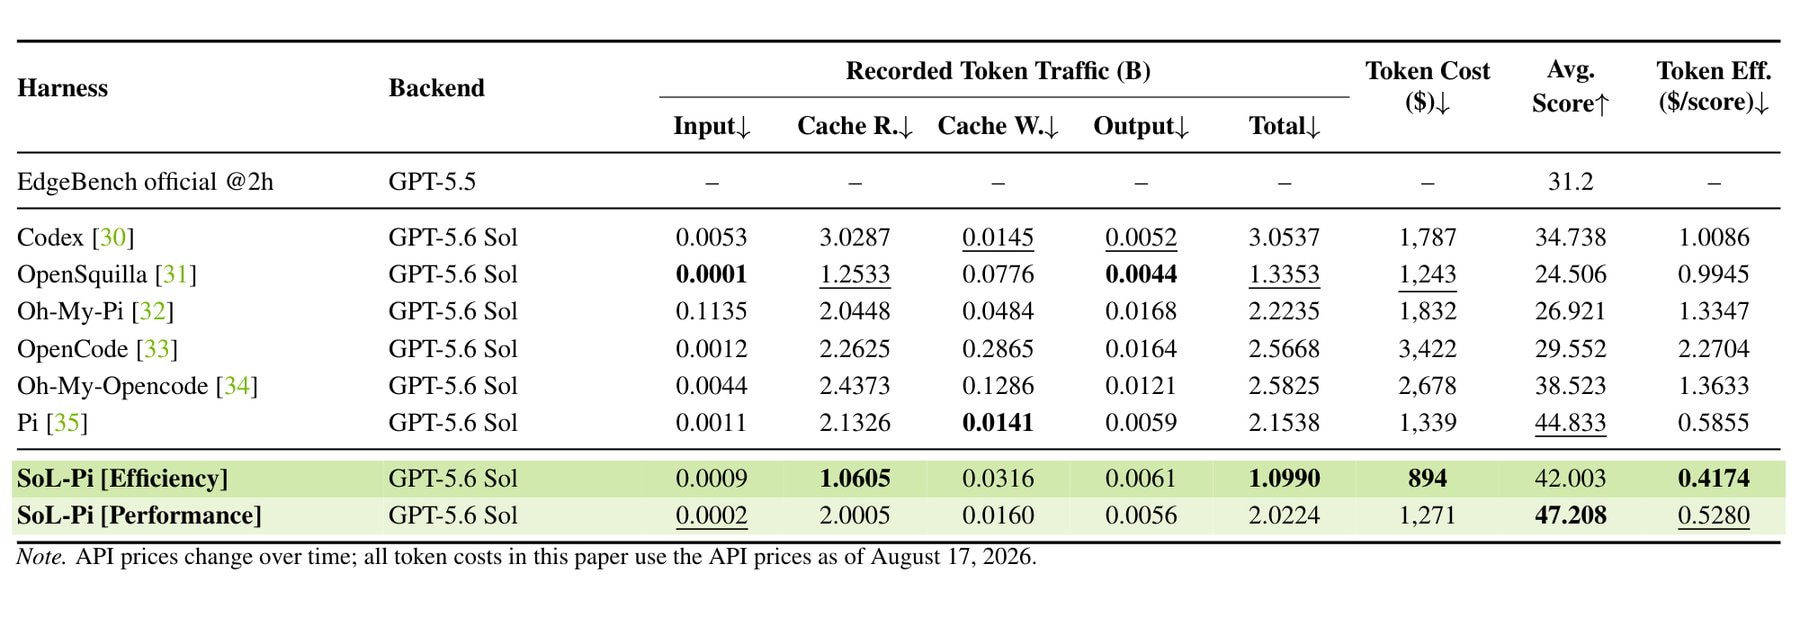
以美元计算,作者估计与原生 Codex 和 Claude Code harness 相比每小时节省 $8.75 至 $13.50,与 Pi 相比每小时节省 $4.36 至 $5.71(基于当前 API 价格)。
研究人员仅使用 GPT-5.6 Sol 构建了该系统,然后不做任何修改地应用到了 Opus 5 上。在 Opus 5 上,它保留了 Pi 94.3% 的性能,并实现了类似的节省。但这些机制在 Opus 5 下触发频率更低、力度更小,研究人员将其归因于 harness 仅在 GPT-5.6 Sol 轨迹上进行了优化。
在 EdgeBench 之外,情况更为混杂。在 Terminal-Bench 4 的 63 个 CPU 任务中,SoL-Pi 仅解决了 15 个任务,而 Codex 和 Pi 各解决了 18 个。总成本仍比 Pi 低约四分之一。
在 2026 年国际数学奥林匹克(IMO 2026)的形式化验证 Lean 4 任务中,该系统以每个已解决问题最低成本的成绩破解了六道题中的三道。在内核优化实验中,20 个 SoL-Pi Worker 组成的群体比相当的 Pi Worker 群体降低了 26.8% 的成本。
在内核优化测试中,使用 SoL-Pi Worker 的群体取得了最佳结果,成本比使用 Pi Worker 的群体低约四分之一。
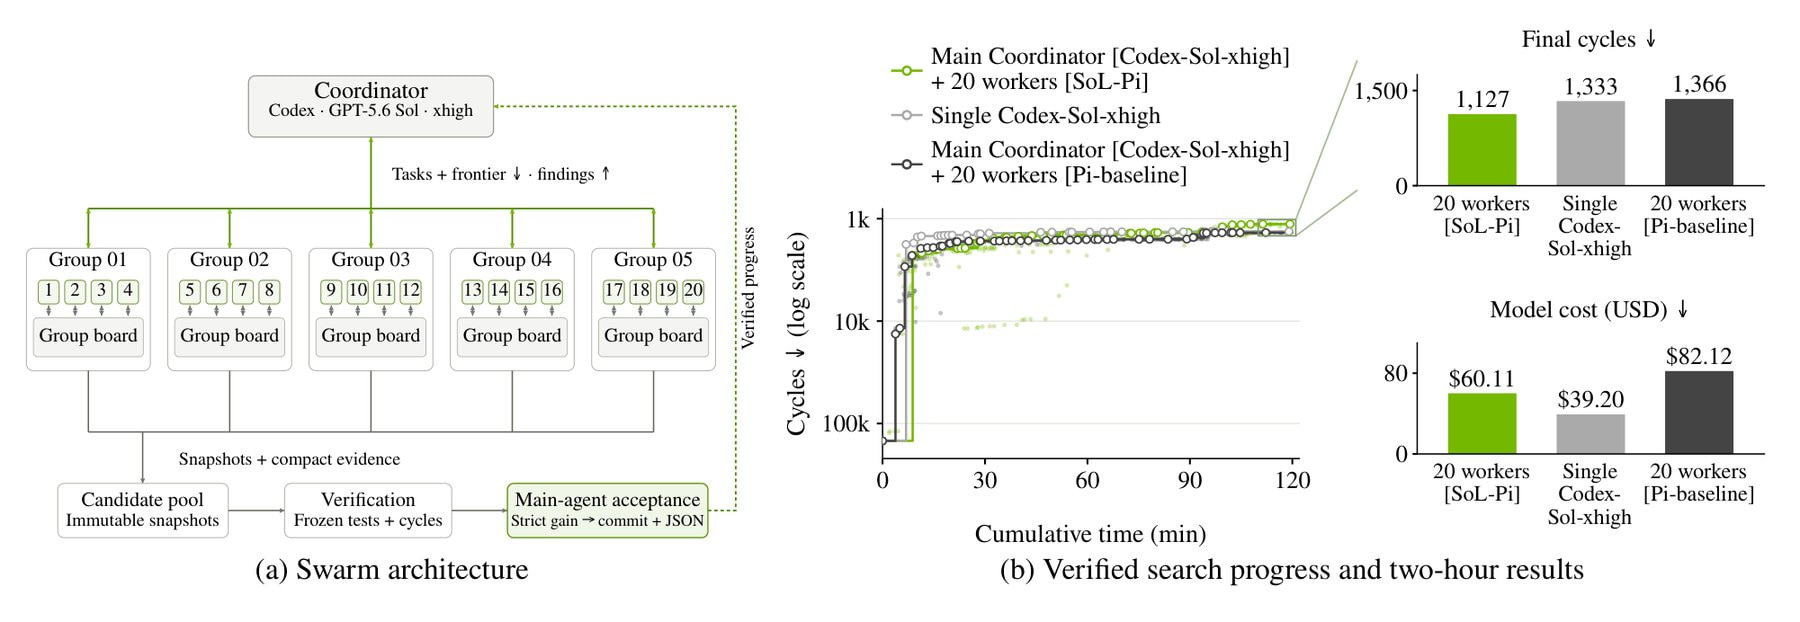
效率提升伴随着权衡,因为更短的上下文会降低提示缓存的复用率。在一次测试运行中,总成本仍从 $1339 降至 $894。展望未来,作者建议在许多任务上对 harness 进行预训练,类似于模型的预训练方式,并使用已有的精简 harness 来降低搜索其继任者的成本。他们将这种递归效率改进称为一种愿景,而非当前研究的结论。
Harness 对 Agent 成本的影响程度在工具公司 Composio 8 月的一次测试中变得清晰。该测试让 Deepseek V4 Flash 在包括 Claude Code 和基于 Pi 的 Oh My Pi 在内的四个 Agent 框架上运行。即使做的是相同的工作,每个已解决任务的成本也相差近 3 倍。
由于 Agent 消耗的 Token 越来越多,定价和优化压力持续增长。据 OpenRouter 分析师 Peter Walker 称,自 2026 年 2 月以来,Agent Token 用量增长了 14 倍,其中近 70% 来自缓存的提示。
SoL-Pi 使用的上下文压缩可能有副作用。一项研究发现,压缩平均仅保留 17% 的用户指令。并行 Agent 也会推高成本。Codex 开发者 Eric Provencher 最近警告说,超过两个子 Agent 几乎总是会浪费 Token 而不提升质量,因为它们大部分时间都在互相检查工作。