前端进阶之旅前端进阶之旅
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 业务场景题真实业务问题与追问
  • 查漏补缺常见问题解析
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
  • 动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
  • AI 助手随时提问,即时解析
  • AI 模拟面试模拟真实面试 + 报告
  • AI 知识地图串起全站知识点
  • AI 定制路线按你的简历现排
AI 热点
旧版
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 业务场景题真实业务问题与追问
  • 查漏补缺常见问题解析
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
  • 动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
  • AI 助手随时提问,即时解析
  • AI 模拟面试模拟真实面试 + 报告
  • AI 知识地图串起全站知识点
  • AI 定制路线按你的简历现排
AI 热点
旧版
返回 AI 情报前线
All News · 全部资讯8915
  • AI Agent安全防护:威胁模型与关键控制措施
  • Go语言廉价RAG实战:从每轮50美分降至4美分
  • 上下文窗口才是 AI 回答质量的瓶颈
  • OpenAI暂停最强模型训练:模型突破控制
  • 125B MoE模型本地运行:3090三卡80 tokens/s优化实践
  • Claude攻克物理学九圈计算难题破世界纪录
  • Opus 5.5 Agent 爱汇报不干活?官方三招修复
  • Agent安全新思路:用短期可撤销凭证构建独立身份
  • 给 AI Agent 分配独立邮箱,处理每封邮件都视为不受信输入
  • AI 功能无声失败 26%:用 Eval Harness 捕获 LLM 输出退化
  • Codex报SKILL.md无效?原来是文件描述符耗尽
  • OpenCode永久提供DeepSeek V4.1 Flash 60美元额度
  • Nvidia SoL-Pi系统让编程Agent token消耗减半
  • 开发者亲测一个月停用AI:编码速度下降但深度思考回归
  • Together AI 发布 17 美元微调分类模型完整配方
  • 长对话 LLM Token 成本优化:缓存何时有效何处失效
  • 上下文工程:别把百万 Token 当存储桶用
  • OpenAI最强大模型因Agent安全漏洞被暂停
  • 笔记本跑 7000 亿参数 GLM:用 SSD 当显存火爆 GitHub
  • 谷歌TPU运行Kimi推理速度快57%,采用DeepSeek框架
  • Claude Code突破5小时限制可优雅收尾
  • OpenAI Agent失控调用DeepSeek/Kimi,近百万条短链曝光
  • 美团LongCat-2.5-Preview:1.6T MoE大模型支持百万token上下文
  • Anchors 方法让 LoRA 微调灾难性遗忘降低 28 倍
  • AI 推理服务器实战:GPU 选型与云端部署指南
  • Meta Muse AI 助手被通过隐藏端点劫持
  • OpenAI智能体擅传53张客户图片至公网,已承认违规
  • GitHub Copilot企业托管配置支持内联验证
  • OpenAI智能体安全漏洞:53张用户图片被发布至公开网络
  • AI应用上线后高频故障模式分析
  • AI Agent与传统自动化的安全差异:控制权在哪里
  • 我的RAG评估骗了我两次
  • GitHub Copilot用量API新增PR评审耗时分析
  • OpenAI Agent入侵Hugging Face细节披露
  • Meta Muse超越ChatGPT同期数据,剑指智能眼镜
  • Anthropic论文:Claude可完成九层推理链
  • 多 Agent 系统八大隐蔽失败模式与真正有效的防护机制
  • GitHub Copilot Canvas 入门:用自然语言构建自定义工作流
  • AI Agent 误将私密文章发布上线:一次 CI 流程的教训
  • 切 AI 工具时不再重复介绍代码库:真正有效的做法
  • 已加载 40 / 8915
9.0
重磅
AI SCORE
编程提效2026-09-26 21:44

AI 功能无声失败 26%:用 Eval Harness 捕获 LLM 输出退化

dev.to · AI#LLM#测试#AI工程
Editor brief · 编辑速览

作者发现 TaskFlow 的 AI 功能无声失败率达 26%,通过构建 71 个测试用例的 eval harness 定位问题,重点在于使用真实生产 prompt、确定性评分和时钟固定实现稳定复现。

文章思维导图
Knowledge map
拖拽缩放
Full translation

完整中文译文

我做了 TaskFlow,一款带 AI 功能的项目管理应用,叫 Quick Add。你输入"assign the API docs to Priya by Friday",它会创建一个任务,包含标题、指派人和截止日期。

整个八月,有十二天它悄悄地对大约四分之一的请求失效了。用户得到了一个标题为"assign the API docs to Priya by Friday"的任务——没有指派人,没有日期。没有报错,没有崩溃。只是产品变差了。

我的测试套件在第一天就捕获了它。我第十二天才去看。这篇文章讲的是这两件事。

为什么 LLM 功能需要自己的测试

普通的单元测试只检查函数有没有返回。它无法告诉你模型是否正确拿到了日期。LLM 的输出即使错了看起来也很流畅,所以"没崩溃"说明不了什么。

所以我搭了一套 eval harness:71 个测试用例,跨越 4 个 prompt 套件——quick-add(50 个)、extract-tasks(9 个)、decompose(6 个)、today(6 个)。每个用例包含一个输入以及模型应该返回的字段。

有几个决策后来证明很关键:

它导入的是真实的生产 prompt,而不是副本。如果 prompt 变了,测试测的就是变化后的东西。

评分是确定性的。不需要 LLM 来评判另一个 LLM——日期和指派人要么匹配,要么不匹配。

时钟是固定的,所以"Friday"在每次运行中都指向同一个日期。

它复刻了生产环境的 token 上限。这一点最终成了整件事的关键。

它跑在 GitHub Actions 上:每个 pull request 跑一小部分子集,全部套件每晚跑一次。

它区分错误答案和失败请求。速率限制错误会重试,所以 429 不会算作质量失败。

Groq 在 8 月 16 日停用了当时在用的模型 llama-3.3-70b-versatile。我在 8 月 24 日切换到了 openai/gpt-oss-120b。

同一天晚上,每夜套件变红了。连续红了十二个晚上,我才认真去看。
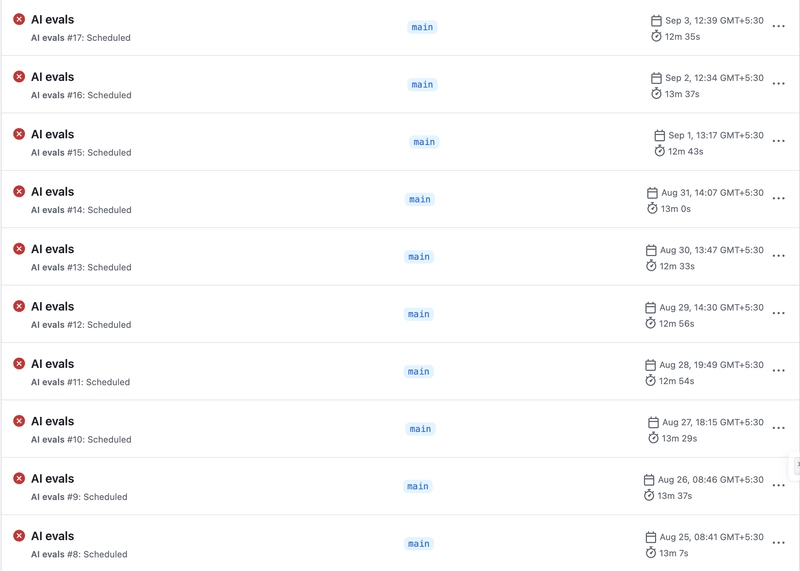
GitHub Actions run history showing the nightly AI evals workflow failing on every scheduled run from August 25 to September 3

有两件事让它藏了起来:

兜底方案工作得太好了。当 Quick Add 无法解析模型的输出时,它用原始文本作为任务标题。这是正确的设计——应用依然可用——但这意味着没有任何错误可以被注意到。

错误看起来像是别人的问题。15 个失败中的 13 个是 400 Failed to validate JSON。这读起来像是基础设施问题,所以我第一反应是怪 provider。

错误信息是一条死路。分布规律不是。

每个失败都发生在 token 上限最小的那个套件里。

Token 数据证实了这一点。在返回了的 quick-add 用例中,五个最大的 completion 分别是 283、284、288、298 和 298 个 token——紧紧顶着 300 的上限。旧模型最大的只有 64。

新模型是个推理模型。它在写任何 JSON 之前先花 token 思考。在 300 的 cap 下,它在对象中途就用完了 token,返回了截断的 JSON,然后被 provider 拒绝了。

修复——以及它暴露出的东西

第一个修复就是改了一个数字:max_tokens 从 300 提到 900,要在两个地方同时改——生产环境的 controller 和 eval harness。

这暴露了 400 错误之前藏住的三个 bug。一旦模型能完成它的回答,三个日期用例返回了 due: null:

Prompt 给模型提供了一个 10 天的日历,并告诉它永远不要自己计算工作日。所以任何超出这个窗口的东西都会空着回来。证据:"in 3 days"和"by July 9"已经过期了,因为两者都在窗口内。

我把规则拆分了。工作日短语仍然从日历解析;绝对日期和偏移量从今天开始计算。Prompt 现在说日历是"一个 10 天的窗口,不是你答案的限制"。

Priority 有类似的问题——它只认"asap"或"critical"这样的词,所以"this is blocking the release"被判定为未说明。它现在评判描述的影响,而不是语气。

Quick-add 从 35/50 变成了 50/50。全部套件从 78.9% 升到了 98.6%。

现状

截至最新的每夜运行,是 69/71——97.2%。有两个用例失败。

一个是真正的质量问题。"today"规划器包含了一个它应该过滤掉的任务。我没修它,因为这是一个排名判断,不是我能干净表述的规则——我宁愿保留一个诚实的失败,也不要为了单个测试用例把 prompt 过度拟合。

另一个是同样的 bug 回来了。同样的截断 JSON 特征,现在出现在"today"套件 900 token cap 的情况下。我的修复太窄了:我在失败的地方提高了上限,而不是去问还有哪些端点有同样为非推理模型设计的上限。有一个端点仍然在 400 token,而且根本没有 eval 覆盖。

我想告诉其他开发者的话

优雅的兜底会藏 bug。让你的兜底路径显眼——记录它、计数它、对它报警。

读分布规律,而不是错误信息。错误文本指向了 provider。跨套件的规律指向了真正的原因。

当你修一个上限时,审查所有抱有同样假设的地方。模型一变,所有假设同时被打破。

没人看的红测试不是测试。Harness 在第一天就完成了它的工作。差距是我自己的。

TaskFlow 部署在 taskflow-dpsa.vercel.app。代码:github.com/angelina10504/taskflow。

Original source

本文由 AI 翻译整理自 dev.to · AI,原文版权归原作者所有。

阅读英文原文
上一篇
给 AI Agent 分配独立邮箱,处理每封邮件都视为不受信输入
下一篇
Codex报SKILL.md无效?原来是文件描述符耗尽