
8.0
热点
AI SCORE
编程提效2026-09-26 17:09
上下文工程:别把百万 Token 当存储桶用
dev.to · AI#LLM#上下文工程#Token 优化
Editor brief · 编辑速览
长上下文窗口不是存储方案,塞入过多文档会导致模型准确率下降 10.9 个百分点;应在调用 API 前先明确模型回答问题真正需要的信息。
百万级上下文是一个桶,不是智能。真正的难题不在于有足够的空间存放数据,而在于决定往里面放什么。
大多数工程师首先犯的错误是把长上下文当存储方案来用。看到 100 万 token 的上下文窗口,兴奋地把所有文档、日志、配置文件一股脑儿塞进去,然后纳闷为什么模型产生幻觉或遗漏了明显的答案。在 OpenAI Multi-Needle Context Retrieval 基准测试中,从 12.8 万 token 到 100 万 token,准确率下降了 10.9 个百分点。问题不在模型本身,而在于你在模型看到你真正的问题之前,就让它干起了本该由你做的筛选工作。
对 LLM 的 API 调用有基本了解(本文使用 Python 和 curl 示例,请根据你的技术栈自行调整)。
能够访问具有长上下文窗口的 LLM(GPT-4.1、Gemini 2.5 Pro 或 Bedrock 上的 Claude Sonnet 4 均支持 100 万 token)。
一个真实的使用场景,包含多份文档、日志或源文件——不是玩具示例。
基本了解你的模型回答问题需要什么(这是关键部分)。
在调用任何 API 之前,先坐下来思考:模型需要哪些信息才能正确回答你的问题?
如果你在问一个关于特定客户问题的问题,你不需要整个客户数据库。如果你在排查生产环境错误,你不需要过去六个月的每一条日志。你需要的是信号。
花 15 分钟列出直接回答你问题的文档、章节或数据类型。按重要性排序。对于可有可无的内容要坚决剔除。这是基础。
一旦确定相关内容,就将其拆分为小型、带标签的片段。带有标题、摘要和元数据(如创建日期或类别)的文档,比一堆毫无区分度的大段文字更容易让模型理解。
原因:模型是按顺序处理文本的。分块和打标让你得以暗示结构。一项研究发现,动态生成的干扰项导致主流模型的性能平均下降超过 45%。不相关的上下文会对你产生负面影响。
权衡:你在预处理阶段需要做额外工作。但这比让模型苦苦挣扎要便宜(无论是 token 消耗还是延迟)。
以下是我的结构方式:
import json
from datetime import datetime

# Example: chunking customer support tickets
tickets = [
    {
        "id": "TKT-2025-001",
        "date": "2025-01-15",
        "domain": "billing",
        "summary": "Customer reports duplicate charge on recurring subscription",
        "body": "Customer was charged twice for monthly plan on Jan 15. Refund issued. Root cause: payment processor retry logic fired twice due to network timeout."
    },
    {
        "id": "TKT-2025-002",
        "date": "2025-01-16",
        "domain": "api_access",
        "summary": "Rate limiting causing 429 errors in batch processing",
        "body": "Client hitting rate limits when submitting 500 requests in parallel. Solution: implement exponential backoff and request queuing."
    }
]

# Tag and serialize for the prompt
context_items = [
    f"[{t['domain'].upper()}] {t['summary']}\nID: {t['id']} | Date: {t['date']}\n{t['body']}"
    for t in tickets
]

print("\n---\n".join(context_items))
本文依赖的关键数据 — 来源:openai.com。
现在你已经有了打标、分块后的上下文,不要把所有内容都传给模型。只检索或过滤出与你问题匹配的部分。
原因:即使有 100 万 token,你发送的每一个 token 都要付费(而且随着上下文增长,模型在"大海捞针"时表现会变差)。如果你的问题是关于账单问题的,只检索打标为"账单"的片段。这叫上下文工程,是区分可用系统和昂贵系统的关键。
权衡:你需要一个检索机制——语义搜索、关键词匹配或轻量级 embedding 模型。这增加了一步。但这会削减 token 消耗和延迟,并提高准确率。
以下是一个简单的基于关键词的过滤器:
def filter_context(items, query_keywords, domain=None):
    """Filter context items by keyword and optionally by domain."""
    filtered = []
    query_lower = query_keywords.lower()

    for item in items:
        # Match domain if specified
        if domain and f"[{domain.upper()}]" not in item:
            continue
        # Match keywords in summary or body
        if any(kw in item.lower() for kw in query_lower.split()):
            filtered.append(item)

    return filtered

# Example usage
query = "duplicate charge billing"
relevant = filter_context(context_items, query, domain="billing")
print(f"Filtered to {len(relevant)} items")
对于生产环境,使用 embedding 或向量数据库。原则是一样的:检索,而不是广播。
有些上下文至关重要,有些只是辅助。安排好顺序,让模型先看到关键内容,必要时再跳过其余部分。
原因:即使经过过滤,模型往往对早期 token 的注意力更强。如果最重要的上下文先到达,它对答案的影响就更大。Heisenberg Research Labs 的 AI 研究总监 Ryan Peters 这么说:"100 万 token 的上下文窗口是一个桶,不是大脑——如果你把所有东西都倒进去,指望模型自己整理,那你就是在让模型做本该在 prompt 离开你键盘之前就该由你完成的筛选工作。"
权衡:几乎没有。这是纯粹的结构改造,不花一分钱。
critical = relevant[0] if relevant else "No critical context found"
supporting = "\n---\n".join(relevant[1:]) if len(relevant) > 1 else "No supporting context"

context_prompt = f"""You are answering a question about customer support tickets.

## CRITICAL (use this first):
{critical}

## SUPPORTING (reference if needed):
{supporting}

## QUESTION:
{query}

Answer based on the critical context first. Use supporting context only if it adds clarity.
"""
一旦你开始看到模型自我怀疑或与你已知事实矛盾,上下文中的某些内容就在起到反作用——一条冲突的日志条目、一份过时的政策、一份陈旧的文档。
原因:模型在矛盾面前表现挣扎。不相关的上下文会主动损害准确率。在一个需要五步推理的任务中,一项研究发现 GPT-4.1 的准确率从加入 1 条无关上下文时的 26% 下降到加入 15 条无关上下文时的 2%。
权衡:你必须保持纪律。往里加东西很诱人,往外拿很难。但往外拿才是正确的做法。
测试:如果删除一个文档不会改变或恶化你的答案,就把它排除在外。
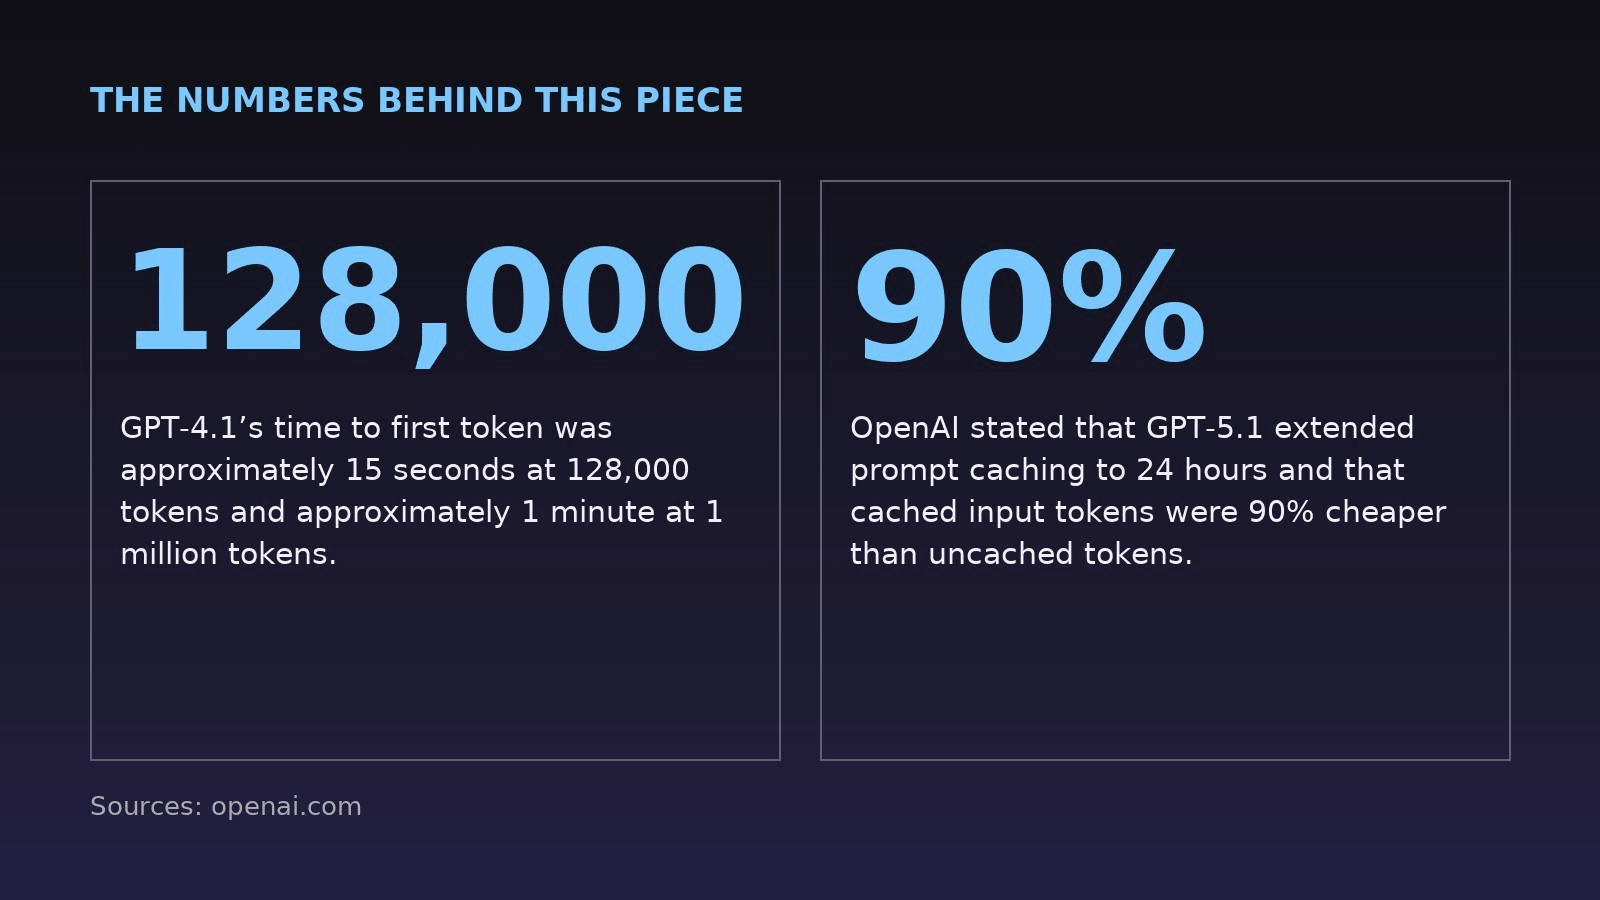
如果你在多个问题中复用相同的上下文(如代码库、知识库或客户资料),就缓存它。OpenAI 表示 GPT-5.1 将 prompt 缓存扩展至 24 小时,缓存的输入 token 比未缓存的 token 便宜 90%;其他提供商对重复前缀也有类似的折扣。
原因:提供商复用已经对相同 prompt 前缀做过的工作,而不是再次处理。对于长上下文,这既省钱又省首 token 时间。
权衡:缓存会过期(GPT-5.1 为 24 小时;Anthropic API 默认 5 分钟,可选 1 小时生命周期),只有完全相同的前缀才能命中缓存。把静态材料放在前面,变化的问题放在最后,并决定当静态部分发生变化时如何刷新它。
import anthropic

client = anthropic.Anthropic()

# Static context (e.g., codebase, docs) that repeats across requests
static_context = """
# Our API v2 Reference
...[large static doc]...
"""

response = client.messages.create(
    model="claude-sonnet-5",
    max_tokens=1000,
    system=[
        {
            "type": "text",
            "text": "You are a helpful API documentation assistant."
        },
        {
            "type": "text",
            "text": static_context,
            "cache_control": {"type": "ephemeral"}
        }
    ],
    messages=[
        {"role": "user", "content": "How do I authenticate?"}
    ]
)

print(response.content[0].text)
一股脑儿倾倒所有内容,指望模型自己过滤。你在让模型做本该由你做的工作。模型是用来对你已经筛选好的上下文进行推理的。
忽略延迟。GPT-4.1 在 100 万 token 时返回结果约需 1 分钟,而在 12.8 万 token 时约需 15 秒。这是一道硬墙。如果你的使用场景需要速度,就不要幻想 100 万 token 的上下文窗口是免费的。
新旧数据混用。如果你的上下文同时包含今天的日志和六个月前的日志,模型可能会对哪些是最新信息感到困惑。使用日期、版本标签,或将旧上下文明确放入"参考"层级。
不进行测量。用不同量的上下文发送同一个问题,并记录准确率。如果增加更多上下文并不能提升准确率,说明你已经找到了信号噪声阈值。在那里停下。
问:什么时候真正应该使用完整的长上下文窗口?
答:当答案确实依赖于综合来自多个独立来源的信息,而且你已经进行了严格过滤时。例如:总结一份冗长的法律文档,或关联跨多条日志的事件。如果你的使用场景不涉及这种综合,很可能你过度使用了长上下文。
问:我怎么知道我的上下文是否过多?
答:测试它。移除一个分块。重新运行查询。如果答案相同,说明这个分块不是必需的。如果你移除某内容时准确率下降了,就保留它。这是唯一诚实的测试。
问:我是否应该始终使用语义搜索 / embedding 进行上下文检索?
答:从关键词过滤和领域打标开始。如果这个方案有效,就坚持用它——它更简单、更便宜。只有当关键词匹配产生太多假阳性或假阴性时,才迁移到 embedding。大多数使用场景在达到规模之前不需要 embedding。
Bigger Context Is Not Always Better: Why Long-Context LLMs Need Context Engineering
Anthropic's Claude Sonnet 4 in Amazon Bedrock Expanded Context Window (aws.amazon.com)
How Is LLM Reasoning Distracted by Irrelevant Context? An Analysis Using a Controlled Benchmark (aclanthology.org)
Adaptive Distraction: Probing LLM Contextual Robustness with Automated Tree Search for NeurIPS 2025 (research.ibm.com)
Stanford CRFM (crfm.stanford.edu)
OpenAI launches new GPT-4.1 models with improved coding, long context (reuters.com)
Heisenberg Research Labs