
8.0
热点
AI SCORE
编程提效2026-09-27 02:02
Go语言廉价RAG实战:从每轮50美分降至4美分
dev.to · AI#Go#RAG#成本优化
Editor brief · 编辑速览
LiveReview团队用Gemini File Search替代向量数据库实现RAG,调用次数从两次降到一次,API费用降低12倍,并附踩坑记录。
你好,我是 Maneshwar,我在构建 LiveReview——一个针对业务关键系统的爆炸半径感知 AI 代码审查工具。欢迎给项目点个 star,帮助开发者发现这个项目,试用一下,并分享你的反馈来帮助改进产品。
一次运行要花 50 美分。
不是一个月。不是一千次运行。是单次运行。
把一份设计方案粘贴进去,得到一个基于我们书架上的书籍和内部复盘案例的接地气评审,然后看着五毛钱蒸发掉。
评论区有人在警告 API key 存储隔离的奇怪问题
用 Go 做廉价 RAG:Gemini File Search,无需向量数据库,两次调用,一次托管存储
第一部分是这篇故事的乐观版本:一个 Go 二进制文件,Gemini 托管的 File Search,无需向量数据库,还有一个免费套餐让整个方案看起来像一顿免费的午餐。
然后免费套餐用完了,付费计费上线了,免费的午餐变成了品鉴菜单。
团队五个人,每人每天跑好几次,这个数字随着工具思考的强度而增长。
这篇文章讲的是我们用什么替换了它,我们测量了什么,以及我们构建、基准测试、然后删除的那一个组件。
"免费"这个词做了太多工作
定价页上是这么介绍 File Search 的,而且说的都是真的。
存储免费。查询时嵌入免费。你只在索引时付一次钱。
但它没有加粗告诉你的是:
搜索是由一个模型执行的。这是一个模型在回答过程中调用的工具。这意味着检索到的片段以普通输入 token 的形式进入那个模型的上下文,然后模型在回复之前通过它们进行推理。
而在 Gemini 3.5 Flash 上,推理费用是每百万输出 token 9.00 美元。
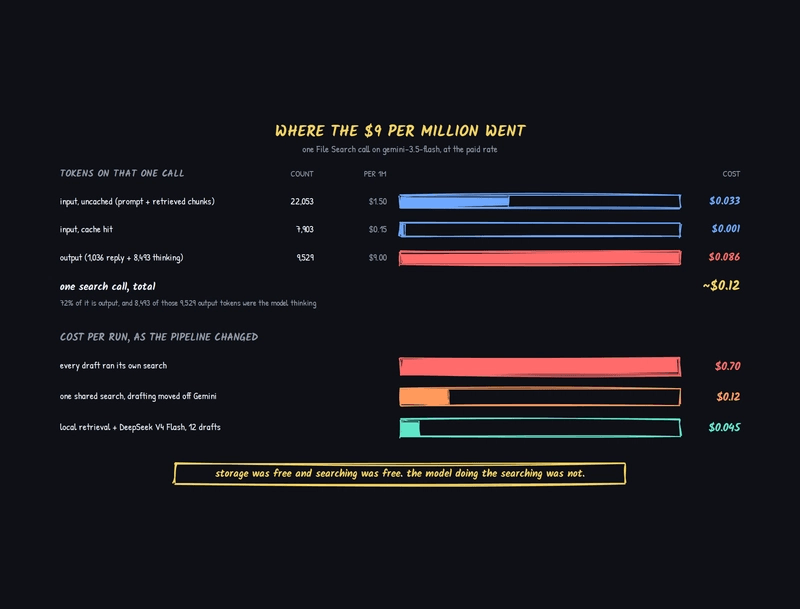
看看那行输出。
9,529 个输出 token,其中 8,493 个是模型在思考。而这个调用的全部工作就是"找到相关段落并提交"。
我们付了一个推理模型去推理应该复制哪几段文字。
第一个修复是结构性的,效果很好。草稿步骤以前各自执行搜索,这意味着三个草稿就是三次搜索。把搜索分离出来让一次搜索供给所有草稿,一次运行从约 0.70 美元降到了约 0.12 美元。
便宜了六倍,但形状还是不对。
因为昂贵的那部分从来不是搜索本身。而是附在上面的思考。
检索不需要大脑。
它需要一个索引、一个相似度函数和一个平局决胜机制。每一个都是你可以在充电时在笔记本电脑上运行的东西。
一个本地的 Chroma 存储,用 Qwen3-Embedding-0.6B 进行嵌入,用稠密向量加 BM25 搜索,用 Reciprocal Rank Fusion 融合。
所有模型调用迁移到 Atlas Cloud 上的 DeepSeek V4 Flash,输入每百万 0.14 美元,输出每百万 0.28 美元。
大致比之前的方案每 token 便宜十倍,1M 上下文窗口,支持 JSON 模式。
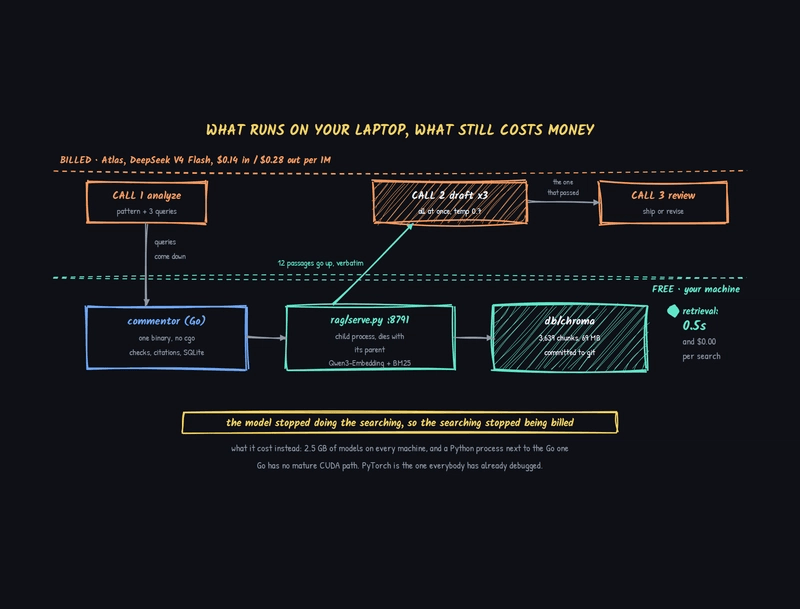
检索服务是 Python,作为 Go 二进制文件的子进程运行,在一个没有其他人连接的端口上。它随 make run 启动,随它终止。
我确实尝试说服自己不设这个边界。
Go 没有成熟的 CUDA 方案。诚实的路线是把模型导出到 ONNX 然后通过 cgo 链接 Go 运行时,精确匹配驱动、CUDA 和 cuDNN 版本。PyTorch 是一百万人已经调试过的路径,包括在 WSL2 上,CUDA 穿透会以各种奇怪的方式坏掉。
加一个进程边界比加一整类"在我机器上能跑"的新问题要便宜。
分块是准确率真正所在的地方
每个人都在讨论选哪个嵌入模型。几乎没人讨论你喂给它什么,而那才是收益所在的地方。
我们的语料库是 71 个 markdown 文件,其中大部分是曾经是 PDF 的书籍。PDF 转换来的 markdown 充满了不是文本的东西。
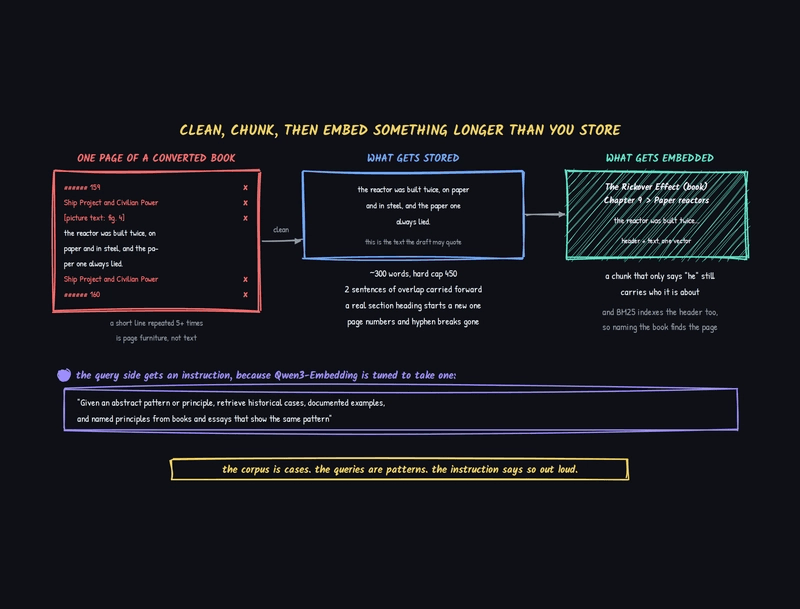
清理器剥离转换器自己的页脚、只是页码的行、图片-文字块,以及把一个词拆到两行的连字符换行。
让我惊讶的是跑马标题。
一本转换来的书在每一页顶部重复章节标题,通常被提升为 markdown 标题。
不处理的话,它会把文本撕成五彩纸屑,一段关于纸堆反应堆的文字回来时中间夹着"Ship Project and Civilian Power"。
修复它的规则简单得令人尴尬:在一个文件中出现五次或以上的短行是页面装饰,不是正文。
然后是分块。大约 300 词,硬上限 450,按句子边界拆分,两句话带入下一个块,这样一个跨边界引用的内容至少在一个块中存活。一个真正的章节标题开始一个新块,一旦当前块有足够的内容能独立成段。
然后是我即便你从这篇文章里什么都学不到也会偷走的那部分。
嵌入比你存储的更多。
你存储的块是草稿允许引用的文本。你嵌入的字符串在顶部粘了一个标题:
EMBED_MODEL = "Qwen/Qwen3-Embedding-0.6B"

# 每个块嵌入什么
f"{title} ({kind}) › {heading_path}\n\n{text}"

# 查询侧得到一个指令,因为 Qwen3-Embedding 是
# 仅在查询上进行了指令微调的。文档按原样嵌入。
QUERY_PROMPT = (
    "Instruct: Given an abstract pattern or principle, retrieve historical cases, "
    "documented examples, and named principles from books and essays that show "
    "the same pattern\nQuery: "
)
第九章中间的一个块可能只说"他决定另辟蹊径"。
加上标题,那个向量仍然知道它是 Rickover,在一本关于 Rickover 的书里,在一个关于纸堆反应堆的章节里。没有它,它就是一个漂浮在虚空中的代词。
查询指令是第一部分的想法,"用模式搜索,而不是帖子",推到了嵌入本身这一层。语料库是案例。查询是模式。对一个被训练成倾听模型的模型大声说出来不花一分钱。
稠密检索找到释义,BM25 找到名称
向量搜索擅长"这两段意思是相同的",却奇怪地不擅长"这段包含 Rickover 这个词"。
关键词搜索则相反。
所以我们两个都跑,各取 40 个候选,然后用融合。
flowchart TD
    Q[来自调用 1 的一个查询] --> DN[稠密 top 40, Qwen3-Embedding]
    Q --> BM[BM25 top 40, 标题 + 文本]
    DN --> RRF[Reciprocal Rank Fusion, k=60]
    BM --> RRF
    RRF --> SEL[每个查询保留最好的 4 个]
    SEL --> CAP{该文件已有 2 个块?}
    CAP -- 是 --> SKIP[跳过,所以没有一本书主导]
    CAP -- 否 --> KEEP[保留]
    KEEP --> RR[轮询合并, 3 个查询]
    SKIP --> RR
    RR --> DUP{与已选的一个近似重复?}
    DUP -- 是 --> DROP[丢弃: 一篇帖子同步了两次]
    DUP -- 否 --> OUT[12 段文字传给草稿]

classDef decision fill:#f4d35e,stroke:#b8991f,color:#1a1a1a
    classDef start    fill:#e9ecef,stroke:#6c757d,color:#1a1a1a
    classDef dense    fill:#9d8cff,stroke:#5b4bcc,color:#1a1a1a
    classDef lex      fill:#6ea8ff,stroke:#2f5fc4,color:#1a1a1a
    classDef good     fill:#5ee6c8,stroke:#1f9c86,color:#1a1a1a
    classDef bad      fill:#ff9a5c,stroke:#c4602a,color:#1a1a1a
class CAP,DUP decision class Q start class DN,RRF dense class BM,SEL,RR lex class KEEP,OUT good class SKIP,DROP bad
def hybrid(self, query: str, k: int = CANDIDATES) -> list[tuple[int, float]]: score: dict[int, float] = {} for ranked in (self.dense(query, k), self.lexical(query, k)): for r, i in enumerate(ranked): score[i] = score.get(i, 0.0) + 1.0 / (RRF_K + r + 1) return sorted(score.items(), key=lambda x: -x[1])[:k]
这就是整个融合逻辑。六行代码。
它之所以有效,是因为从不比较两个分数。0.82 的余弦相似度和 14.3 的 BM25 评分之间没有任何可比性。排名才有。
一份文档在两个列表中都排在第 3 位,胜过只在单个列表中排第 1 位的文档,而常数 k(文献中最终确定的数字是 60)防止了每个列表顶端的文档压垮其他所有结果。
BM25 同时为标题、标题和正文建立索引,这与嵌入头的处理方式相同,所以在查询中提到一本书的名字真的能找到那本书的页面。
几条规则保证了最终 12 条结果的公正性。每个文件每个查询最多两个分块,所以一本 400 页的书不能填满每一个位置。查询轮转合并,所以三个查询各贡献最佳段落之后,任何一个才能获得第四个。
而且任何与已选内容词重叠率超过 0.6 的都会被丢弃,因为我们的博客语料库有几个帖子被同步了两次,它们很客气地把自己作为两个独立来源返回。
## 被裁掉的 reranker(重排序模型)
标准建议是:广泛检索,然后用 cross-encoder 重新排序。所以我们这么做了,使用了 bge-reranker-v2-m3。
然后一次运行需要六分半钟,我开始找原因。
检索服务自己的日志只有一行:`search: 3 queries -> 8 chunks in 117.5s`。
三次查询乘以 40 个候选项,等于 120 次 cross-encoder 前向传播,运行在一张同时还要拉动桌面的 4 GB GTX 1650 上。它不是在挣扎,只是老老实实地在不适合的硬件上干活。
在撕掉它之前,我们先测量了。黄金集从已完成的会话中自动构建:用 Call 1 的检索查询,配上接受草案实际引用的文件,你就得到一个来自真实使用场景而非凭感觉构建的检索测试。
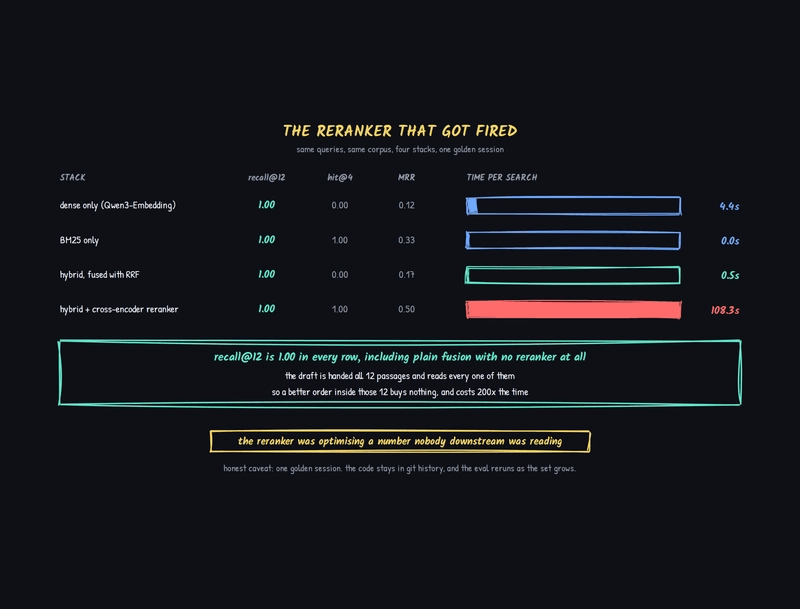
reranker 在 MRR 和 hit@4 上赢了。它确实把更好的段落放到了更靠前的位置。
但它根本没有改变 recall@12,而 recall@12 是唯一有用户的数字。
draft 调用在其 prompt 中获取全部 12 个段落。它读取全部 12 个。下游没有 top-4 截断,没有 truncation,没有任何对第 1 段和第 9 段区别对待的东西。
所以 reranker 花 108 秒改进了一个下游没有任何东西在读的排序。它在优化一个我们偶然选择的指标,因为它出现在每篇检索论文里,而不是因为我们的 pipeline 消费了它。
它被移除了,推理过程写在 retriever.py 顶部,这样下一个人就不会"修复"它的缺失。
还有诚实的警告,也写在那里:这是一个黄金会话。更难的查询可能真的需要重排序才能把正确的段落拉入前 12 名。代码在 git 历史里,eval 是一个 make target,当黄金集足够大到有意义的时候,我们会再次运行它。
删除前先测量。保留前也先测量。
## 两小时的嵌入,四台笔记本
3,639 个分块,在共享的 4 GB GPU 上每个大约 1.8 秒,总共约两小时,比任何人想等的时间多一小时五十分钟。
但嵌入是确定性的,语料库按文件清晰分割。所以它可以在人之间并行化,而不只是跨核心。
flowchart TD C[71 files, 3,639 chunks] --> S[shard_files: disjoint quarters] S --> M[four laptops, --shard i/4] M --> R{sha256 AND chunk count match?} R -- yes --> SK[already embedded, skip] R -- no --> EM[embed, halve the batch on OOM] EM --> G[commit the shard, hand it back] SK --> G G --> I[rag/integrate.py] I --> V{same embedding model everywhere?} V -- no --> X[refuse: mixed vectors lie quietly] V -- yes --> O{every file in exactly one shard?} O -- in two --> X O -- in none --> W[warn, merge what arrived] O -- yes --> F[copy vectors into db/chroma]
classDef decision fill:#f4d35e,stroke:#b8991f,color:#1a1a1a classDef start fill:#e9ecef,stroke:#6c757d,color:#1a1a1a classDef work fill:#9d8cff,stroke:#5b4bcc,color:#1a1a1a classDef box fill:#6ea8ff,stroke:#2f5fc4,color:#1a1a1a classDef good fill:#5ee6c8,stroke:#1f9c86,color:#1a1a1a classDef bad fill:#ff9a5c,stroke:#c4602a,color:#1a1a1a
class R,V,O decision class C start class M,EM work class S,G,I,SK box class F good class X,W bad
uv run rag/ingest.py --shard 1/4 --out db/chroma-shards/1 uv run rag/ingest.py --shard 2/4 --out db/chroma-shards/2
uv run rag/integrate.py db/chroma-shards/*
合并过程完全不进行嵌入。它检查每个分片是否使用了相同的嵌入模型、是否有文件落在了两个分片中、以及是否有文件落在了零个分片中,然后将向量复制到一个存储中。
这些检查不是偏执。混合嵌入模型不会崩溃。它们会永远自信地返回错误的邻居,这是一个比堆栈跟踪糟糕得多的故障。
构建这个也暴露了增量逻辑中的一个真实 bug。Resume 通过将文件的 sha256 与存储中的内容进行比较来判断"已完成"。
在一个文件运行到一半时被 kill,该文件的 sha 完全正确但其分块数量不足,所以它会被永远标记为已完成,静默地丢失半本书。
修复是一个 AND:sha256 和分块数量都必须匹配。
然后我们提交了完成的存储。db/chroma 在 git 中是 69 MB,什么都不是,这意味着团队中的其他任何人永远不需要嵌入任何东西。Clone,运行,搜索。
## 现在检索是免费的,把它花在 draft 上
杀掉最贵的调用的好处是,便宜的调用变得有意思了。
一次 draft 现在只需要几毛钱。所以 pipeline 不是draft一次然后失败时重试,而是以 0.7 的 temperature 同时发出三到四个 draft 让它们竞速。
每个回复在到达时就在 Go 中被解析和检查。通过检查的 draft 被立即拒绝。第一个通过的进入 review 调用。只有当全部失败时,批次才会重试,并将最接近的 draft 的失败附加到 prompt 中。
每个 draft 都被保留和展示,包括被拒绝的及其未通过的检查,因为"这里是四次尝试以及为什么其中三个不好"比一个 draft 加一个耸肩对阅读的人来说更有用。
这确实产生了一个真正愚蠢的 bug,并行性使它更可能发生。
在一次运行中,第一批产生了一个通过所有检查的 draft。然后审核者要求修改。8 次重写之后,没有一个通过,pipeline 发货了最接近的失败重写。
它手里有一个通过的 draft,却为了一个更差的把它扔掉了。修复是显而易见的后备方案:如果没有重写通过,发货已经通过的那个,并附上审核者的笔记。
重试很便宜。丢失你已经付过钱的工作不是。
## 取代信任 grounding 元数据的检查
我们自己传递段落解锁了我真正在乎的东西。
当托管搜索工具返回 grounding 元数据时,你知道模型看了哪些分块。你不知道它放在引号里的词是否在任何一个分块中。
现在 pipeline 可以证明它。
输出中的每个 `history.sources[].passage` 必须逐字出现在它所命名文件的分块中。当 authority 用 `exact_words` 引用给定文件之一时也是如此。Markdown、换行和引号样式首先被规范化,`...` 标记省略,剩余部分须按顺序出现。
失败不是警告。是检查失败,就像长度违规或未解决的法规引用一样,并进入与所有其他内容相同的重试循环。
这就是"模型有权访问正确的书"和"模型正确引用了正确的书"之间的区别,而只有后者才值得展示给审阅者。
现在的账单长这样
一次真实的端到端运行,包含 15 次模型调用,跨三个批次生成 12 份草稿:
210,976 个输入 token,55,285 个输出 token
检索耗时 0.5 秒,不花一分钱
对比托管搜索上相同管道形状的 $0.70。便宜了 15 倍,而最贵的部分现在是实际进行写作的部分——这才对。
关于这个数字的两个诚实的脚注。
Atlas 报告每份草稿的大部分输入都被缓存了,但我们仍按全价对每个输入 token 计费,所以 $0.045 是上限,而不是估算。
而且延迟上升了,而不是下降了。检索从 117 秒降到了半秒,但 DeepSeek 在每份草稿前都会认真思考,所以完整运行仍然需要两到四分钟。
我们买的是成本,而不是速度。对于"粘贴一份设计文档,回来时带着咖啡",这是正确的权衡。对于聊天框来说就是错误的权衡。
如果你的检索是一次模型调用,你就是在用推理价格做一次查找。
把它拉到你自己的机器上,把精力花在清洗和分块上,而不是模型选择上;嵌入一个从不展示给任何人的上下文头;用排名而不是分数来融合稠密检索和词法检索;检查引用而不是信任它们。
然后在构建聪明的部分之前先构建评估。我们的评估告诉我们把那个聪明的部分扔掉,这每次搜索节省了 108 秒和一个我们不需要的永久依赖。
这个系统中最好的组件是那个不在其中的组件。
你们的团队注意力是有限的,而 AI 生成代码的洪流正在使保持生产环境的安全性和可靠性变得更加困难,而不会拖慢你的速度。
我正在构建 LiveReview,一个面向业务关键系统的爆炸半径感知 AI 代码审查工具。
LiveReview 不会对每个 diff 一视同仁,而是根据爆炸半径——即变更通过调用图的影响范围——对每次变更进行评分,这样你就可以将注意力集中在真正重要的地方。
把代码审查的精力花在业务风险最高的地方——而不是均匀分布在每个 diff 上。
HexmosTech / LiveReview

面向业务关键系统的爆炸半径感知 AI 代码审查


LiveReview 是一个 AI 代码审查工具,它根据爆炸半径对 diff 的每个区块进行评分:变更通过调用图的影响范围有多大、触发了多少持久状态、测试覆盖有多完善。一个对共享认证检查的 3 行修改可能比一个 300 行的 UI 调整排名更高。你的团队注意力首先流向最高风险的代码,而不是均匀分布在每个 diff 上。
LiveReview 的爆炸半径和审查优先级评分,实时显示在 diff 视图中。
一个修改了 40 个其他文件的函数中的 3 行修复,同时还会写入数据库,应该得高分。
一个 300 行的 UI 变更在一个文件中,有完整覆盖……
点击下方,用你的代码库试用 LiveReview:

如需进一步操作,你可以考虑屏蔽此人或举报滥用行为