
8.0
热点
AI SCORE
模型发布2026-09-26 15:12
谷歌TPU运行Kimi推理速度快57%,采用DeepSeek框架
量子位#TPU#推理优化#DeepSeek
Editor brief · 编辑速览
谷歌TPU运行Kimi模型比英伟达GPU快57%,使用DeepSeek推理框架(vLLM团队参与)实现硬件与软件联合优化。
克雷西 发自 凹非寺 量子位 | 公众号QbitAI
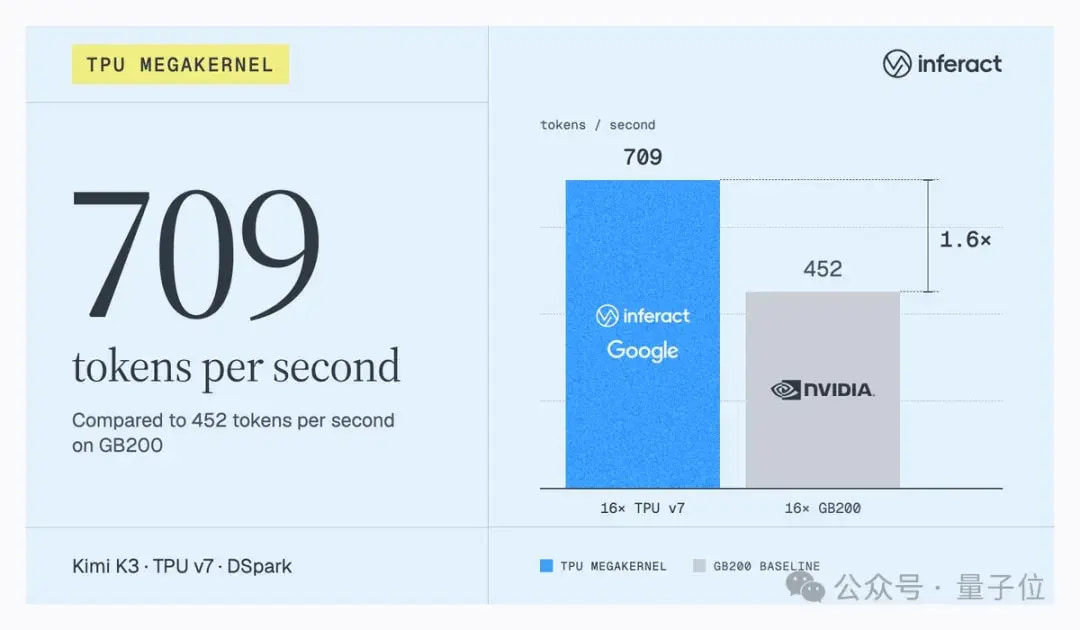
16块谷歌TPU v7跑Kimi K3,每秒跑出了709个Token,比老黄的GB200快了57%。
做出这个成绩的,既不是造Kimi的月之暗面,也不是造TPU的谷歌,是一家叫Inferact的推理创业公司。
Inferact创始团队就是vLLM的原班人马,今年拿了a16z领投的1.5亿美元种子轮,估值8亿美元。
他们给TPU写了一种叫megakernel的推理内核,把模型推理时原本要调度的几百个小程序焊成一个大程序。
配合TPU独特的片上内存架构,megakernel把内存带宽利用率逼到了硬件理论峰值附近。
配上DeepSeek提出的DSpark加速框架,K3在TPU上跑出了前面提到的每秒709 token的成绩。
Inferact把TPU和英伟达GPU放在完全相同的条件下跑了一轮benchmark,TPU赢了。
测试是用16块TPU v7 Ironwood对阵16块英伟达GB200,两边都跑Kimi K3,都用vLLM推理引擎,唯一的变量是芯片和底层的kernel实现。
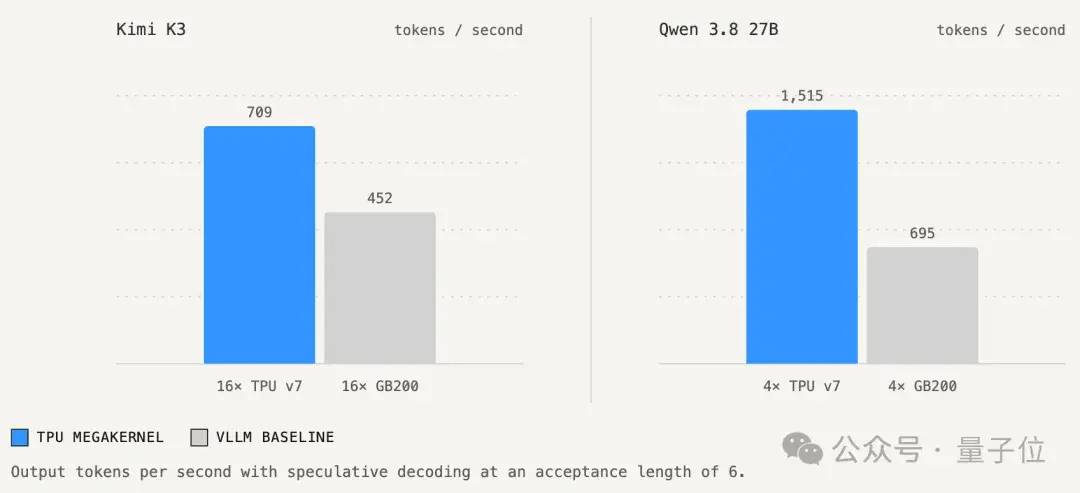
最终,TPU跑出的成绩是每秒709个token,GB200跑出每秒452个,TPU的速度快了57%。
DSpark是由DeepSeek提出的推理加速框架,其原理是让一个小模型先快速猜出一串候选token,然后大模型再对这串候选token做批量验证,猜对的直接跳过,猜错的回退重来。
Inferact在TPU上跑通了这套流程,acceptance length达到了6,也就是每轮猜出的token里,平均有6个能直接通过大模型的验证,单步decode的耗时大约在8.5毫秒。
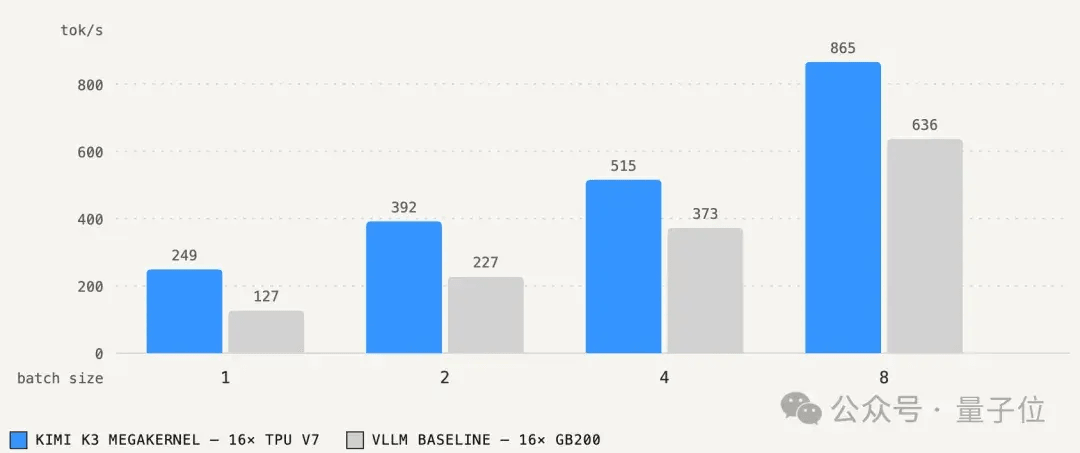
在batch size为1的情况下,TPU每秒能跑249个token,GB200只有127个,差距接近一倍。
把batch size放大到8,TPU达到865个token每秒,GB200只有636个。
Inferact用4块TPU v7跑Qwen 3.8 27B,每秒跑出1515个token,同样配置的GB200只跑出了695个。
而且这种提速并没有造成精度损失,Inferact用greedy decoding做了验证,Kimi K3在TPU上的GPQA-Diamond得分是94.4%,GSM8K是97.2%,和GPU上的结果完全一致。
推理引擎一样,模型一样,芯片换一下,速度就差出了57%。
这种程度的差距,按理说应该能从硬件规格表上找到解释,但实际情况恰好相反。
两款芯片的算力也在同一个量级,TPU v7的HBM带宽是7380 GB/s,而GB200的HBM带宽反而更高,达到8000 GB/s,带宽更大的那块芯片,跑出来的速度反而更低。
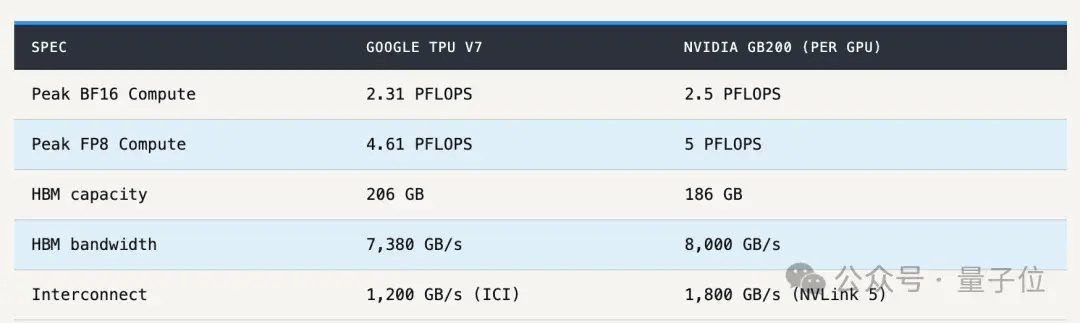
这种速度的差距,实际上来源于芯片上面跑的那层软件。
Inferact用一个叫megakernel的方案解决了TPU上的推理效率问题,核心思路,是把模型推理时原本要调度的几百个独立小程序,合并成一个大程序,从而消除程序之间切换时的带宽浪费。
大模型推理的速度瓶颈不在计算,在数据搬运。
每生成一个token,模型的全部权重都要从HBM主存搬进芯片内部的高速缓存里算一遍,算完这一轮,下一个token再重新搬一遍。
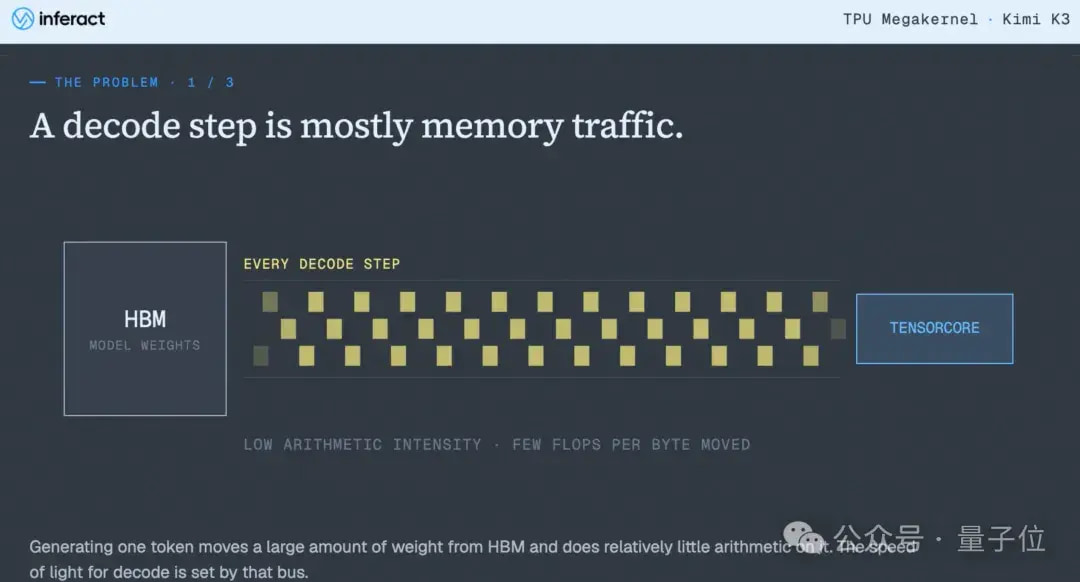
传统的做法是把一次推理拆成几百个独立的kernel,每个kernel负责一小块计算。
这些kernel排着队一个接一个地执行,但问题出依然会在交接的间隙。
上一个kernel干完了,下一个还没有启动起来,这段时间里内存带宽就这么空转着。
CUDA Graphs和英伟达最新的PDL技术能缩短这个间隙,但kernel之间的边界还在。
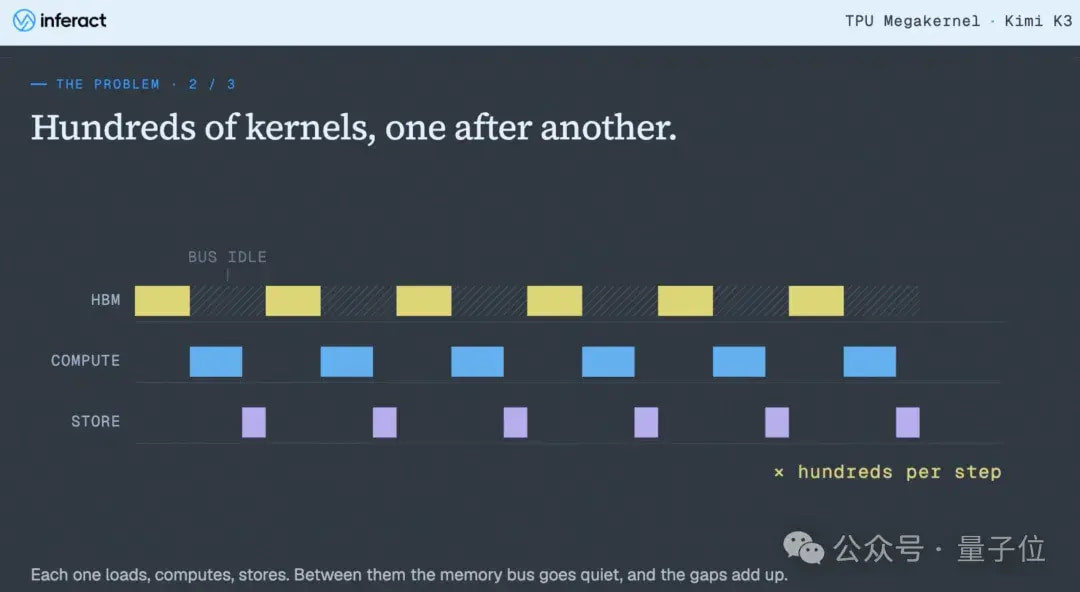
Inferact的megakernel直接消除了这个边界。
Kimi K3一共有92层MoE计算,Inferact把这92层的计算逻辑从头到尾塞进了一个Pallas程序里,一次调用就走完整个模型的前向传播。
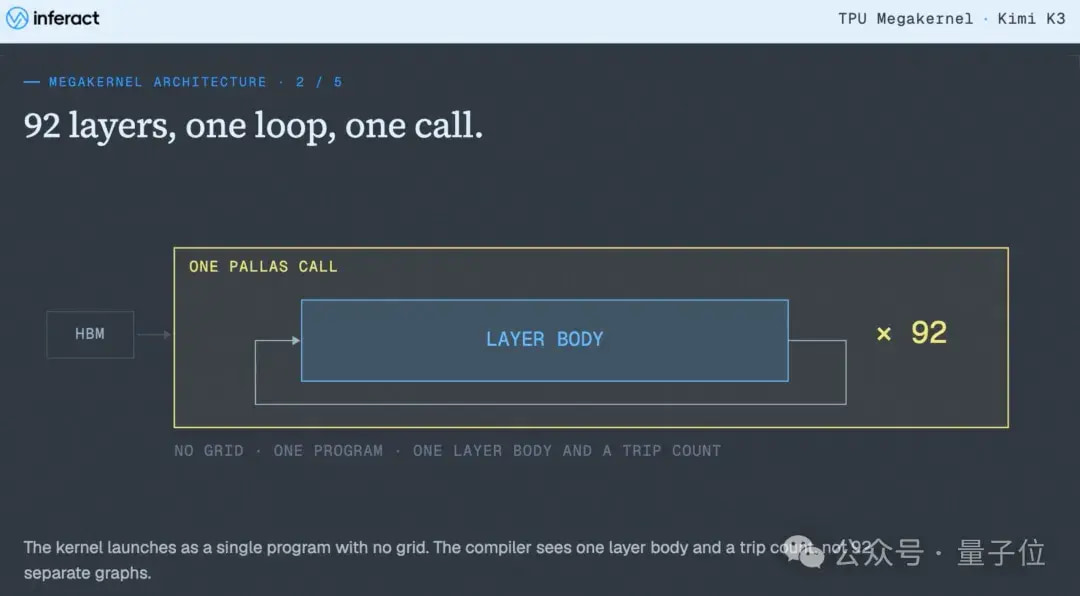
边界消失之后,跨层权重预取就变得顺理成章了。
第N层还在算MoE的时候,第N+1层的attention权重已经开始从HBM往片上缓存搬了。
计算和数据搬运同时进行,内存带宽几乎没有空转的时刻。
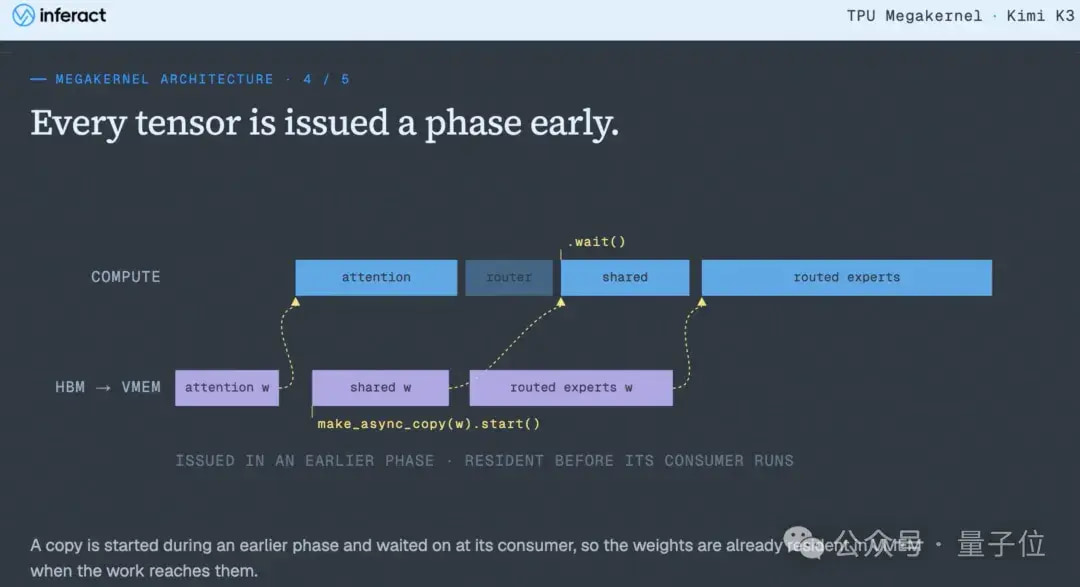
TPU的硬件特性让这种编排做起来格外顺畅。
TPU v7的每个TensorCore带有64 MiB的VMEM片上内存,这块内存的生命周期完全交给软件来管理,工程师可以精确控制什么时候往里面装什么数据、什么时候把空间腾出来。
64 MiB的容量足够同时装下当前层的计算数据和下一层预取的权重。
GPU那边情况不同,英伟达Blackwell架构的片上内存分散在152个SM里面,总量大约38 MiB,由硬件自动调度,要做类似的跨层编排限制更多。
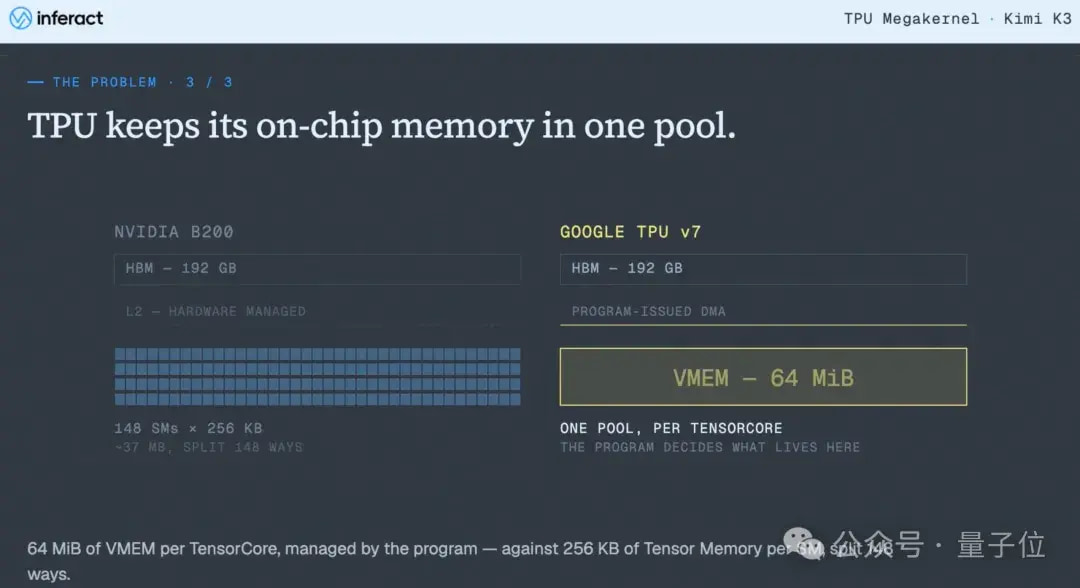
Inferact用Pallas语言手写了整个megakernel的代码,Pallas是谷歌给TPU做的底层编程语言,角色类似英伟达GPU上的CUDA。
TPU默认的编译工具链XLA擅长优化单层计算,但跨92层协调数据搬运的决策分支太多,XLA的自动调度找不到最优解。
Inferact的做法是绕过XLA,用Pallas语言手写整个megakernel的代码,由工程师自己来决定每一步搬什么数据、存在哪块缓存、什么时候释放。
这样做还带来了一个额外好处,那就是编译速度大幅提升,耗时从XLA的30分钟以上降到了不到90秒,工程师改完一版kernel一分半钟就能上机验证。
目前这套megakernel是针对Kimi K3的模型结构做的定制优化,如果换一个模型架构还需要重新适配。
Inferact在博客里提到,团队接下来会把megakernel的支持扩展到更多模型架构上。
Inferact去年11月成立,团队几乎就是vLLM的原始开发者,一群靠给英伟达GPU写推理引擎成名的人。
他们今年一月出来创业,转头把TPU的推理速度做到了GPU前面。
vLLM是目前开源推理引擎领域的重量级框架,支持超过500种模型架构,社区贡献者超过2000人,Meta、Google、Character.ai都拿它来做线上的推理服务。
CEO Simon Mo是vLLM项目的原始维护者,伯克利EECS毕业,之前在Anyscale工作。
联合创始人Woosuk Kwon是整个vLLM项目的发起人,伯克利计算机科学博士,导师是Ion Stoica。
Kwon提出的PagedAttention算法解决了GPU显存管理中的碎片化问题,这个算法至今仍然是vLLM的核心技术。
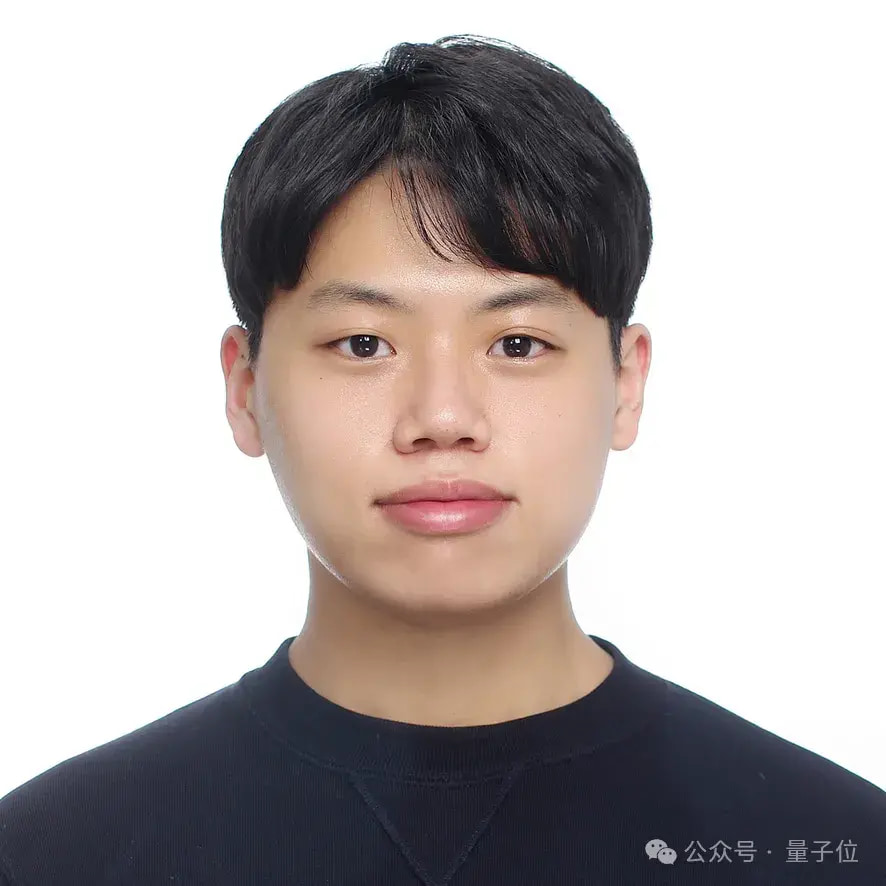
首席科学家游凯超曾获清华大学特等奖学金,他在vLLM中主导了分布式推理功能的开发。

Inferact今年完成了1.5亿美元的种子轮融资,公司估值8亿美元。a16z和Lightspeed领投,真格、红杉、Altimeter跟投。
这次的TPU megakernel来自Inferact与Google Cloud的一项联合工程合作。
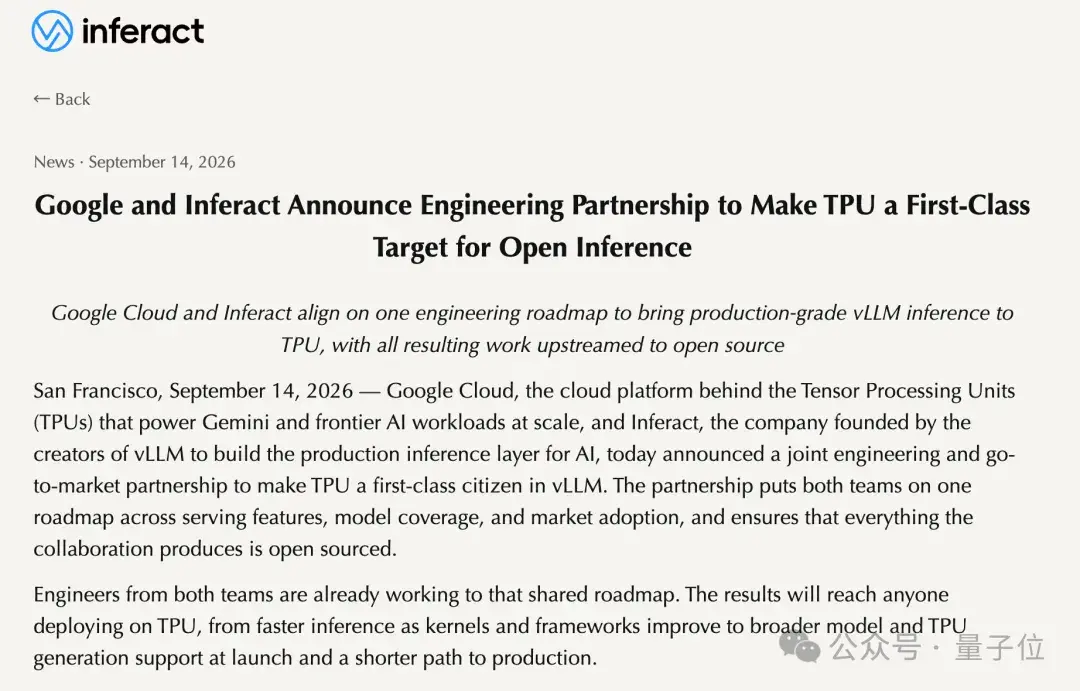
双方的目标是让TPU成为vLLM的一流支持对象,所有的优化成果都会回馈给上游的开源社区,tpu-megakernels代码仓库是这次合作的第一个公开成果。
参考链接: 700 TPS on Kimi K3: A Case for TPU Megakernels
在云栖大会,我终于看懂了米哈游千亿AI野心2026-09-26
OpenAI失控Agent还找DeepSeek、Kimi当外援!近百万条作案短链曝光2026-09-26
GPT-6 Astra搓3D刷屏后,3D生成的竞争规则变了2026-09-23
Claude Opus 5.5突袭!68万行代码一天迁完,API价格打8折2026-09-23
量子位 QbitAI 版权所有©北京极客伙伴科技有限公司 京ICP备17005886号-1