前端进阶之旅前端进阶之旅
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片
  • 场景篇按分类整理的大前端场景考点
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
  • 动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
  • AI 助手随时提问,即时解析
  • AI 模拟面试模拟真实面试 + 报告
  • AI 知识地图串起全站知识点
  • AI 定制路线按你的简历现排
AI 热点
旧版
返回 AI 情报前线
All News · 全部资讯10189
  • 模型快十倍,智能体为何只快一点
  • 用决策模型做评测,先调分类阈值
  • 编码 Agent 实测:成本之外看交付细节
  • Mercury 3 发布:主打高速生成与百万上下文
  • 用 Node 拆解向量池化与检索质量
  • 补齐 Oracle 方言约束,轻量模型首答率跃升
  • 拆解 Claude Code 的完整智能体循环
  • 邮件 Agent 重试前先校验退信
  • 用信号队列约束 Agent 等待邮件
  • 用 Cloudflare 搭建 Agent 收信中枢
  • 一次字符串替换如何让线上文章翻倍
  • AI 搭项目失败,先确认代码是否拉取成功
  • 检索匹配再高,也救不了过期知识库
  • 本地模型帮你给常用命令起快捷名
  • MCP 无状态改版涉及哪些迁移工作
  • 检查 Supabase 服务端鉴权的信任来源
  • 流式 AI 接口延迟该如何拆分测量
  • 模型故障切换如何追踪实际调用路径
  • 百灵开放五款语音模型供开发者组合
  • Drex Max 为电脑操作智能体输出决策概率
  • 无人值守的 Claude 循环如何耗尽额度
  • Bedrock为Claude提供严格结构化输出
  • 错误码搜不准?给向量检索补上 BM25
  • 让 Agent 崩溃后续跑,并处理重复副作用
  • 用 TypeScript 搭建带人工审批的客服智能体
  • Copilot 模型策略支持 REST API 管理
  • Copilot多种使用场景启动模型弃用
  • 把框架说明随包交付,让编程智能体可用
  • Nx 恶意包如何借编程智能体窃取秘密
  • 用分层防护限制 Agent 越权与误操作
  • 在表格中用自然语言分析完整BigQuery数据
  • 亚马逊推 TorchNeuron,拓宽 PyTorch 芯片选择
  • OpenCode平台遭入侵,密钥被盗刷
  • Cloudflare如何将AI审查成本降68%
  • 将Copilot任务无缝接续到VS Code
  • Gemini 4 Argon 主打多 Agent 三维制作
  • 用关联 ID 串起 Agent 日志与异常
  • MiniMax新模型以半价提升编程表现
  • 用ADK消除语音代理调用工具时的冷场
  • 62行Bash拆解编程代理的运行机制
  • 从调用轨迹定位代理的延迟与费用问题
  • AI 迁移脚本删库:备份失败为何未阻断
  • DeepSeek 推出 Agent 搜索与网页抓取接口
  • Bedrock新增长视频结构化解析模型
  • 语音识别迁移 Trainium2 的优化实战
  • vLLM 推送式 KV 传输降低推理等待
  • vLLM 双向复用 KV 缓存,降低多轮首字延迟
  • 英伟达发布面向企业与个人电脑的开放模型
  • Agent 工具报错,先判断副作用再重试
  • 在常驻虚拟机上搭建持久化编程 Agent 团队
  • 用DGX Spark承载本地n8n AI工作流
  • 已加载 51 / 10189
8.0
热点
AI SCORE
编程提效2026-10-20 07:35

无人值守的 Claude 循环如何耗尽额度

dev.to · AI#Claude#自动化#用量控制
Editor brief · 编辑速览

作者的模型循环因缺少停止条件,隔夜消耗了套餐额度的 13 个百分点。文章解释 Claude 与 Claude Code 共享用量池、不同限额的区别,并介绍无人值守循环的三项限制措施。

文章思维导图
Knowledge map
拖拽缩放
Full translation

完整中文译文

一个没有停止条件的 LLM 循环,在我的 Claude 订阅上跑了一整夜,消耗了套餐额度的 13 个百分点。问题不在于每个 token 的价格,而在于代码里没有任何机制能结束循环,也没有人看着。这篇文章会介绍 Claude 套餐限额究竟如何运作、如何查看用量,以及我现在为每个无人值守循环设置的三道上限。
限额与聊天应用共享

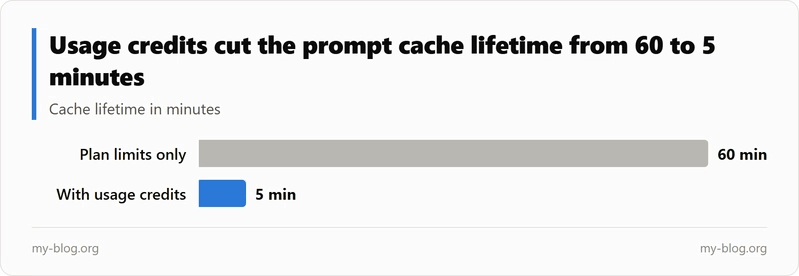
Prompt cache lifetime drops from 1 hour (60 minutes) to 5 minutes when usage credits are used

Pro 和 Max 订阅都包含 Claude Code,限额分为两项:5 小时的会话限额和 7 天的每周限额。根据 Anthropic 帮助页面的说明,Claude 和 Claude Code 共用同一个额度池。在聊天应用中消耗的额度,会减少 Claude Code 可用的额度,反过来也一样。

正因为额度共享,早上看到用量条“高得出乎意料”时,仅凭终端里的信息很难解释原因。如果部分用量来自聊天应用,它就不会出现在终端的用量明细中。

触及限额时,有两个细节很容易搞错:

  • 只有提示信息明确指出某个模型时,切换模型才有帮助,比如触及了 Opus 专属限额。如果提示的是通用的“all models”限额,切换模型没有用。
  • 你可以等待额度重置、启用 usage credits,或者在重置后自动继续运行。v2.1.234 及更新版本可以通过 /rate-limit-options 配置自动继续,组织则使用 autoContinueAtUsageLimit 设置。

usage credits 有一个副作用:prompt 缓存的有效期会从 1 小时(60 分钟)缩短到 5 分钟,因此,同样的使用习惯会带来更高的消耗。另外,Max 套餐附带的每月 API 额度,不能用于扩展 Claude Code 的限额。

正确查看 /usage

在 Claude Code 中输入 /usage。如果你是订阅用户,可以忽略 Session 区块,重点看套餐用量条,以及下方的明细。明细分为三部分:

  • Attribution:按 skill、subagent、plugin 和 MCP server 划分的用量占比。
  • Behavior flags:长上下文、缓存未命中等情况。
  • Loops:每个定时任务的运行次数和 token 用量,需要 v2.1.242 或更新版本。

按 d 查看过去 24 小时,按 w 查看过去 7 天。有一点要注意:这些数字来自当前机器上的本地记录,不包含其他设备和 claude.ai 应用中的用量。

那次通宵运行的事故是怎样的

2026-08-01,一个 LLM 循环在未经任何人批准的情况下运行了一整夜,套餐用量增加了 13 个百分点。这里的 13 来自用量表的读数,是运行前后的差值。我刻意没有把它换算成 token 数,因为任何换算系数都只能是估算值。(完整的事故复盘中有详细说明。)

根本原因在于,这个循环停不下来。如果有人盯着,几分钟内就会把它终止。换成更便宜的模型也解决不了问题,因为退出条件依然缺失,只不过消耗得慢一些。
给循环设置三道上限

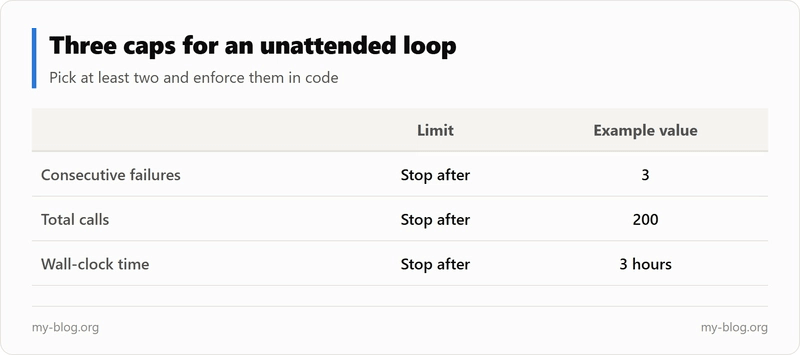
Example caps: 3 consecutive failures, 200 calls, 3 hours

从下面三项中至少选择两项,并在代码中强制执行:连续失败次数上限、总调用次数上限,以及实际运行时长上限。我自己的示例值是连续失败 3 次、调用 200 次和运行 3 小时。

import time

MAX_FAILS, MAX_CALLS, MAX_SECONDS = 3, 200, 3 * 3600

def run(task, step):
    start, calls, fails = time.time(), 0, 0
    while not task.done():
        if fails >= MAX_FAILS:
            return "stopped: 3 consecutive failures"
        if calls >= MAX_CALLS:
            return "stopped: 200 calls"
        if time.time() - start >= MAX_SECONDS:
            return "stopped: 3 hours"
        calls += 1
        try:
            step(task)
            fails = 0
        except Exception:
            fails += 1
    return "done"

每次迭代开始前都会执行检查,函数会返回停止原因,方便记录日志。先测试这些保护条件:给 step 传入一个始终抛出异常的函数,确认恰好尝试 3 次后,就会返回失败提示。

有一个陷阱:遇到 429 后进入冷却等待,并不算设置了上限。它是一种恢复运行机制,因为每到新的限额窗口,它都会让循环重新运行。它只是让循环客客气气地永远跑下去。

每次无人值守运行前的检查清单

  • 开始前,写下预计用量。
  • 请一个人审核并批准这个预估。
  • 至少设置两道上限,并完成测试。
  • 退出时,记录停止原因和用量。
  • 每月审查一次所有 cron 任务、调度器条目和后台运行程序。

这些保护措施只适用于你自己编写的循环。对于 Claude Code 自带的 /loop,需要查看 /usage 中的 Loops 行,再手动关闭它或延长运行间隔。而且,由于明细不包含聊天应用的用量,早上看到用量条偏高时,单凭屏幕上的信息并不总能确定消耗来自哪里。

完整复盘,以及关于限额、额度和模型切换的 FAQ,都收录在 my-blog.org 上的原文中。

我自己的网站上还提供免费工具:34 个计算器和操作指南,涵盖贷款、离职补偿、税后工资,以及储蓄与存款对比。有新内容时,会通过一封邮件统一通知,不含广告。

如果需要采取进一步行动,你可以考虑屏蔽此人,或举报滥用行为。

Original source

本文由 AI 翻译整理自 dev.to · AI,原文版权归原作者所有。

阅读英文原文
上一篇
Drex Max 为电脑操作智能体输出决策概率
下一篇
Bedrock为Claude提供严格结构化输出