
8.0
热点
AI SCORE
技术实践2026-10-20 15:24
模型快十倍,智能体为何只快一点
dev.to · AI#性能优化#并发#Agent
Editor brief · 编辑速览
文章用 Python 定时模拟模型生成与工具调用,对比提升生成速度、并行调用独立工具及两者结合的效果。实验采用假设速率,旨在分析端到端耗时,并非 Mercury 的性能实测。
Inception 表示,Mercury 3 在 NVIDIA GPU 上的生成速度可达每秒 1,068 tokens [1]。在这个实验中,我们将对比每秒 100 和 1,000 tokens 这两种假设速度。我们并不是在对 Mercury 做基准测试。
这么说,你的 Agent 就能快十倍,对吧?🚀
我们用一个两分钟就能运行起来的 Python 小实验来验证一下。然后,再用真实网络请求做一遍,因为有意思的地方就在这里。
一次 Agent 请求通常是这样的:模型先生成一段内容,然后调用一些工具,比如搜索、数据库或 API,接着继续生成。我们用定时等待来模拟这两个部分,这样就能清楚地知道每一秒花在了哪里。
模型生成:60 tokens。每秒 100 tokens 时,需要 0.6 秒;每秒 1,000 tokens,也就是快 10 倍时,需要 0.06 秒。
三个工具:分别耗时 0.2、0.4 和 0.6 秒,彼此之间没有依赖。
接下来,我们尝试两种优化,分别测试,再组合起来测试:换成快 10 倍的模型,以及让三个工具同时运行,而不是一个接一个地执行。
将下面的代码保存为 wait_lab.py:
import asyncio
import statistics
import time

conditions = [(100, False), (1000, False), (100, True), (1000, True)]

async def trial(rate, parallel):
    start = time.perf_counter()
    await asyncio.sleep(60 / rate)  # pretend the model is writing
    if parallel:
        await asyncio.gather(*(asyncio.sleep(t) for t in (0.2, 0.4, 0.6)))
    else:
        for delay in (0.2, 0.4, 0.6):
            await asyncio.sleep(delay)
    return time.perf_counter() - start

async def main():
    samples = {condition: [] for condition in conditions}
    for repeat in range(5):
        order = conditions if repeat % 2 == 0 else list(reversed(conditions))
        for rate, parallel in order:
            samples[(rate, parallel)].append(await trial(rate, parallel))
    for condition in conditions:
        values = samples[condition]
        print(condition, 'median', round(statistics.median(values), 4))

asyncio.run(main())
运行 python3 wait_lab.py,不需要安装任何第三方包。让这些任务同时运行的,就是 asyncio.gather [2]。
下面是我们这次运行的结果,每种配置运行 5 次取中位数,使用 Python 3.14.7:
再看一遍:模型快了 10 倍,整个流程却只快了 1.43 倍。仅仅让工具同时运行,效果就超过了更快的模型,而且不花钱。
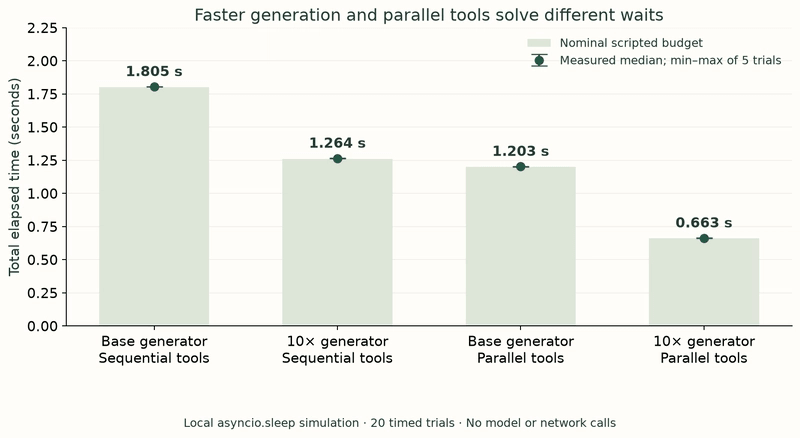
这是我们的实测结果。用的是定时等待,并没有调用真实模型:这里研究的是时间花在了哪里,而不是 Mercury 本身。
原创表情梗图。Emoji 来自 Twemoji,采用 CC-BY 4.0 许可。
这有一个名字:Amdahl's law(阿姆达尔定律)[4]。它的意思是,优化某个部分能带来多大收益,取决于这个部分原本占总耗时的多少。
如果模型生成占总耗时的比例为 p,而你让它快了 s 倍:
speedup = 1 / ((1 - p) + p / s)
在我们的实验里,总耗时为 1.8 秒,其中模型占 0.6 秒,所以 p = 1/3。当 s = 10 时:1 / (2/3 + 1/30) = 1.43 倍。考虑四舍五入后,这与实测加速比一致。
用三个边界情况检查一下,就容易理解了:
如果模型占总耗时的 0%,换成更快的模型不会带来任何变化。
如果模型占总耗时的 100%,就能获得完整的 10 倍加速。
即使模型快到不需要任何时间,整体加速比也无法超过 1 / (1 - p)。在这里,上限就是 1.5 倍。
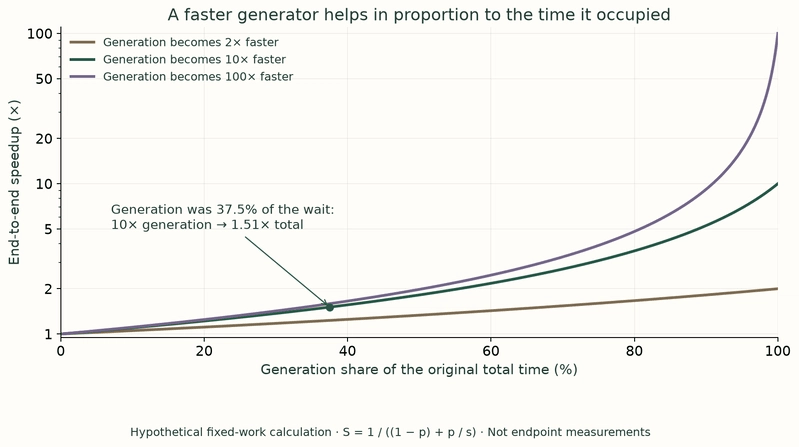
这张图根据公式计算得出,并非实测。注意,只有当模型占据了绝大部分等待时间时,曲线才会明显上扬,在此之前都相当平缓。
定时等待很“听话”:我们预设的延迟,通常只会额外增加一点调度开销。真实请求涉及的因素就多了。
于是,我们把定时等待换成了对 PyPI JSON API [3] 的三个真实请求,分别获取 numpy、pandas 和 requests 的包信息。先逐个请求,再同时请求。每种方式各运行五轮,交替调整先后顺序。然后再用 HEAD 请求重做一遍:请求相同的 URL,但不下载响应体。
将下面的代码保存为 network_lab.py,运行 python3 network_lab.py。它只使用标准库,包含预热在内共发送 66 次请求,并将每一次计时请求的结果保存到 network-results.json。运行一次即可,不要反复请求,给公共服务造成压力。你得到的中位数是一次新的观测结果,不是在复现下面这些精确数字。
import asyncio
import json
import statistics
import time
import urllib.request
from pathlib import Path

PACKAGES = ("numpy", "pandas", "requests")

def fetch(package, method):
    start = time.perf_counter()
    request = urllib.request.Request(
        f"https://pypi.org/pypi/{package}/json", method=method)
    with urllib.request.urlopen(request, timeout=20) as response:
        body = response.read()
        status = response.status
    return dict(package=package, status=status, bytes=len(body),
                seconds=time.perf_counter() - start)

async def trial(method, parallel):
    start = time.perf_counter()
    if parallel:
        rows = await asyncio.gather(*(
            asyncio.to_thread(fetch, p, method) for p in PACKAGES))
    else:
        rows = [await asyncio.to_thread(fetch, p, method) for p in PACKAGES]
    return dict(seconds=time.perf_counter() - start, requests=rows)

async def main():
    results = {}
    for method in ("GET", "HEAD"):
        await trial(method, False)  # unrecorded warm-up; no connection reuse assumed
        samples = {"sequential": [], "parallel": []}
        for repeat in range(5):
            order = ("sequential", "parallel")
            if repeat % 2:
                order = tuple(reversed(order))
            for name in order:
                samples[name].append(await trial(method, name == "parallel"))
        medians = {name: statistics.median(r["seconds"] for r in rows)
                   for name, rows in samples.items()}
        results[method] = dict(samples=samples, medians=medians)
        print(method, medians, "speedup",
              medians["sequential"] / medians["parallel"])
    Path("network-results.json").write_text(json.dumps(results, indent=2))

asyncio.run(main())
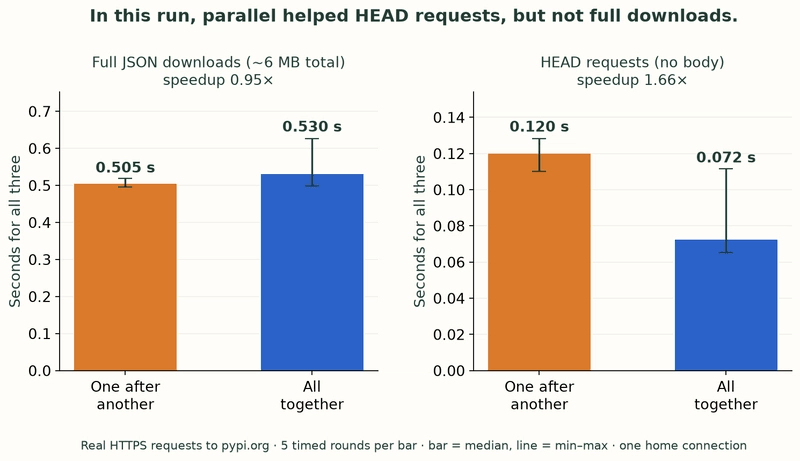
通过同一条家庭网络连接发出的真实 HTTPS 请求。你的结果会有所不同。
在我们保留下来的这次五轮测试中,完整下载并没有因为同时执行而变快:加速比为 0.95 倍。并发执行的耗时中位数反而略高。🫠
数据量很小的 HEAD 请求则快了 1.66 倍。
再看看这次测试中,每个下载在逐个执行和同时执行时的耗时:
numpy(3.7 MB):逐个执行时为 0.27 秒,同时执行时为 0.53 秒。
pandas(2.2 MB):逐个执行时为 0.16 秒,同时执行时为 0.42 秒。
requests(0.2 MB):逐个执行时为 0.07 秒,同时执行时为 0.10 秒。
同时执行后,每个下载都变慢了。共享带宽是一个可能的解释,但我们没有测量带宽是否已经饱和。DNS/TLS 建连过程、CDN 的行为、缓存、服务器负载和线程开销,都可能影响这些耗时。把 GET 换成 HEAD,同时改变了请求方法和传输的响应体,无法单独隔离出某一个原因。
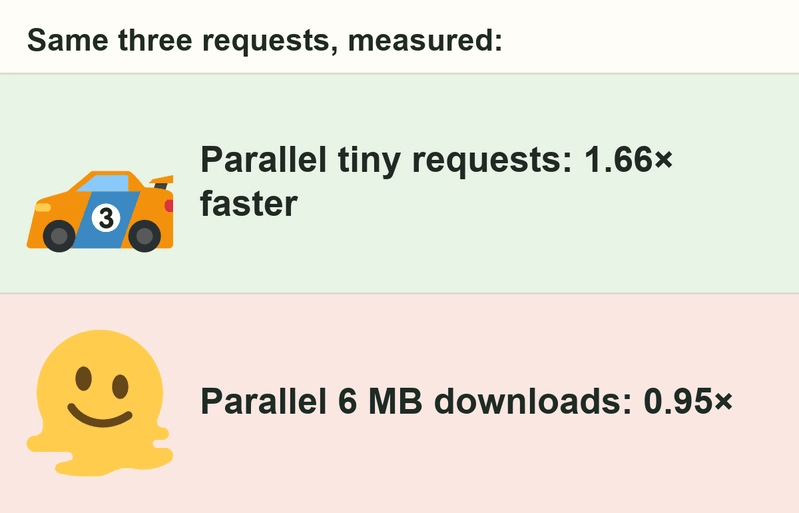
根据我们的实测数字制作的原创表情梗图。Emoji 来自 Twemoji,采用 CC-BY 4.0 许可。
⚠️ 常见错误:把所有工具调用都塞进 gather,然后期待速度提升。调用之间必须相互独立,才能安全地重叠执行。相互独立、主要耗时在等待响应的调用,往往受益最大;大文件下载、共享的速率限制,或繁忙的数据库,都可能让收益缩水,甚至越并发越慢。
⚠️ 常见错误:只根据每秒生成多少 tokens 来评价模型。应该测量从发出请求到获得有用答案的整个过程,并记录模型和工具分别占用了多少时间。错误答案生成得再快,也还是错误答案。
第一轮使用定时等待,没有调用模型。第二轮使用真实请求,但只来自一条网络连接、一次观测过程,每种配置各运行五轮。这些实验都没有测量 Mercury 或其他任何模型的真实速度。真实 Agent 还会有首个 token 延迟、重试,以及彼此依赖的工具调用;换一个模型,也可能改变完成任务所需的步骤数。
这个实验说明的是:在花钱提速之前,先弄清楚时间到底花在了哪里。有时,解决办法是更快的模型;有时,只需要一个 gather;还有些时候,两者都解决不了。🐢
Inception:Mercury 3 发布介绍(厂商自行公布的数据;本文未复测)。
Python 3.14 文档:asyncio 的 sleep、gather 和 to_thread。
维基百科:Amdahl's law。
素材署名:图表和表情梗图均为原创,根据我们保存的结果制作。Emoji 图形来自 Twemoji,采用 CC-BY 4.0 许可。
本文撰写过程中使用了 AI 起草。
如需采取进一步措施,可以考虑屏蔽此人和/或举报滥用行为。