
8.0
热点
AI SCORE
编程提效2026-10-20 13:12
编码 Agent 实测:成本之外看交付细节
dev.to · AI#编程智能体#模型评测#成本
Editor brief · 编辑速览
作者用两个真实应用构建基准比较编码模型,由程序运行应用评分,并披露定制 Agent、调用预算及单次运行等条件。观察指出,权限检查、分页处理和功能兑现是影响交付质量的重要细节。
本月并没有一个在智能体编程方面独占鳌头的模型,至少在我们的两项基准测试中是这样。我花了一个周末阅读排行榜背后的代码,现在对我来说,分数已经没有周六时那么重要了。至少从我看到的情况来看,排名靠前的模型并没有表现出多么高明的技巧。它们主要做对了这些事:展示 issue 之前先检查请求者是谁;持续读取列表,直到 Jira 明确表示已到最后一页;说了“接下来做”,就真的动手做。如果你要为长时间运行的智能体付费,我会建议先看这些,再看价格。
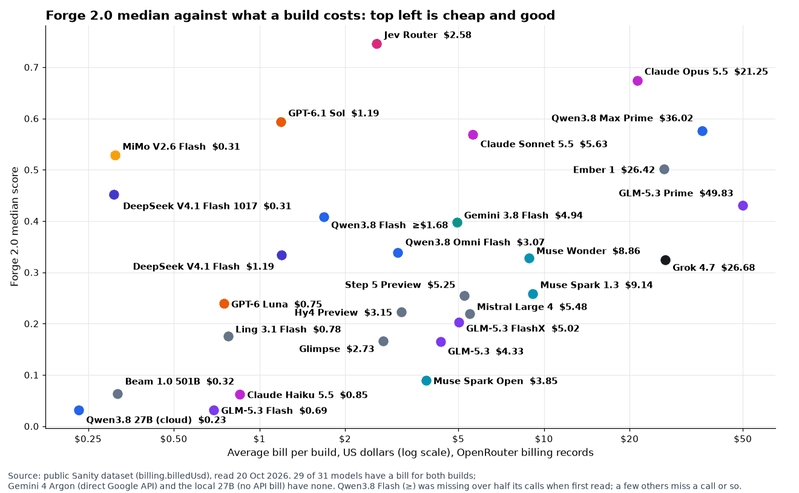
如果按 token 付费,我会用 GPT-6.1 Sol。它在我们的 Jira 应用基准测试中排名第 3,每次构建花费 1.19 美元。如果预算紧张,MiMo V2.6 Flash 在同一项测试中排名第 7,每次构建只需 0.31 美元。评分范围为 0 到 1。
两项基准测试都会让模型通过我们 fork 的开源编程智能体 goose 构建一个真实应用,全程无人介入。没错,是 fork 版本。为了满足自己的使用需求,我们对它做了大量修改。随后,评分程序会运行应用。评分过程不使用任何模型。Gauntlet 7.2 要求构建一个带有支付数据 3D 视图的支付控制台,每个模型有 150 次调用额度,只运行一次。Forge 2.0 则把一个基于 Atlassian Forge 平台构建的 Jira 应用 v1 交给模型,要求它交付 v2,不能联网,调用额度为 300 次。每个云端模型会独立构建两次,排行榜按得分中位数排名。
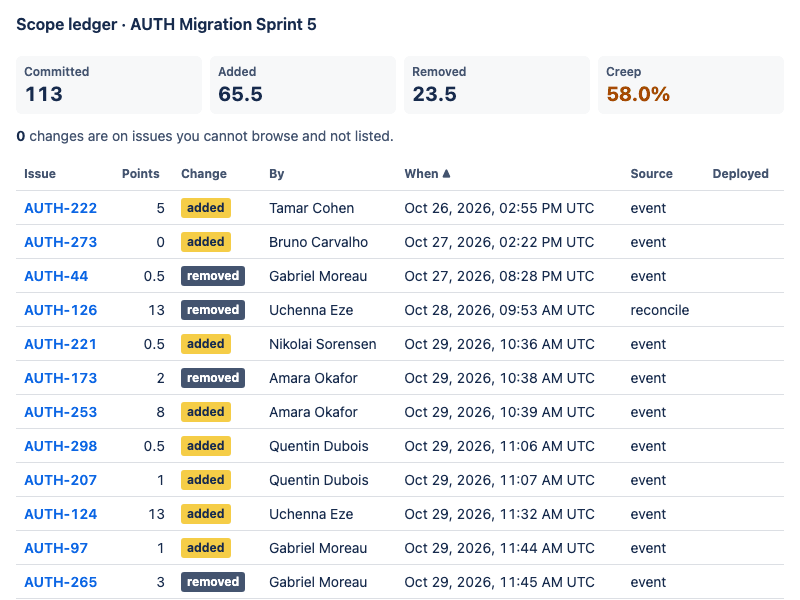
Forge 2.0 中的应用是一个 Jira sprint 范围变更台账。每当有 issue 加入或移出 sprint,它就写入一行记录。每行都会记录最先捕获这次变更的路径:是 Jira 事件,还是每小时运行一次、通过重读 Jira 历史记录来补查遗漏事件的对账任务。升级时必须迁移 v1 的记录,而且这些记录必须保留 v1 为它们赋予的标签。评分程序会将每个构建版本安装到相同的三个 Jira 测试站点上,每个站点都预置了不同的数据,并在整个过程中设置七个检查点。出现严重缺陷,例如向用户展示其无权查看的 issue,就会将得分乘以 0.6。
这些都是无人看管的 goose 运行。如果模型结束一轮响应时没有调用工具,goose 就会停止,Claude Code 默认也是如此(可以通过 Stop hook 让它继续执行)。Haiku 的两次构建都是这样结束的。这里的每项判断,都只基于我们这套环境中的一到两次构建。
如果是按 token 付费的长时间构建,我会选 GPT-6.1 Sol。它的两次构建分别耗时 20 分钟和 25 分钟,每次花费 1.19 美元。MiMo V2.6 Flash 在两个排行榜上与它的分差都不到 0.1,费用却只有四分之一,仅凭两次构建还无法分出高下。我愿意支付这部分差价,因为 Sol 两次构建通过的测试比例都更高(分别为 0.95 和 0.94,MiMo 为 0.88 和 0.93),而且两次都通过了全部 webhook 检查。
如果通过 Claude Code 使用 Claude 订阅,只要套餐额度够用,我会选 Claude Opus 5.5。在我们直接调用的模型中,它的 Forge 2.0 得分中位数最高,Sol 与它的分差不到 0.1。它的每次构建都运行了两个多小时,按 token 计费约为 21 美元;我们还没有测量一次构建会消耗多少订阅套餐额度。
如果追求 Gauntlet 最高分,我会选 GPT-6.1 Sol Pro。这个结果来自一次运行,也是唯一一次没有被评分程序限制得分上限的运行。它还没有运行过 Forge 2.0。它与 Sol 是同一个模型,只是使用了 OpenAI 的 pro 推理模式,每 token 价格相同。
如果预算紧张,我会选 MiMo V2.6 Flash。它开放权重,采用 MIT 许可证,但参数量达到 3090 亿,并不是适合在笔记本电脑上运行的模型。
Claude Sonnet 5.5 的质量与 Sol 相当,费用却接近五倍。我还是会选 Sol。
根据每个模型各两次构建的结果,以下模型不适合大型无人值守构建:Claude Haiku 5.5,两次构建都在纯文本响应后结束;Grok 4.7,每次构建花费 26.68 美元,得分中位数为 0.3248;以及 GLM-5.3 Prime,每次花费 49.83 美元,得分中位数为 0.4302。
本地模型暂时还不在我的选择之列。未经微调的 Qwen3.8 27B 基础模型在 MacBook 上运行,在 31 个模型中排名第 23;而经过微调的 27B 版本还没有运行过 Forge 2.0。
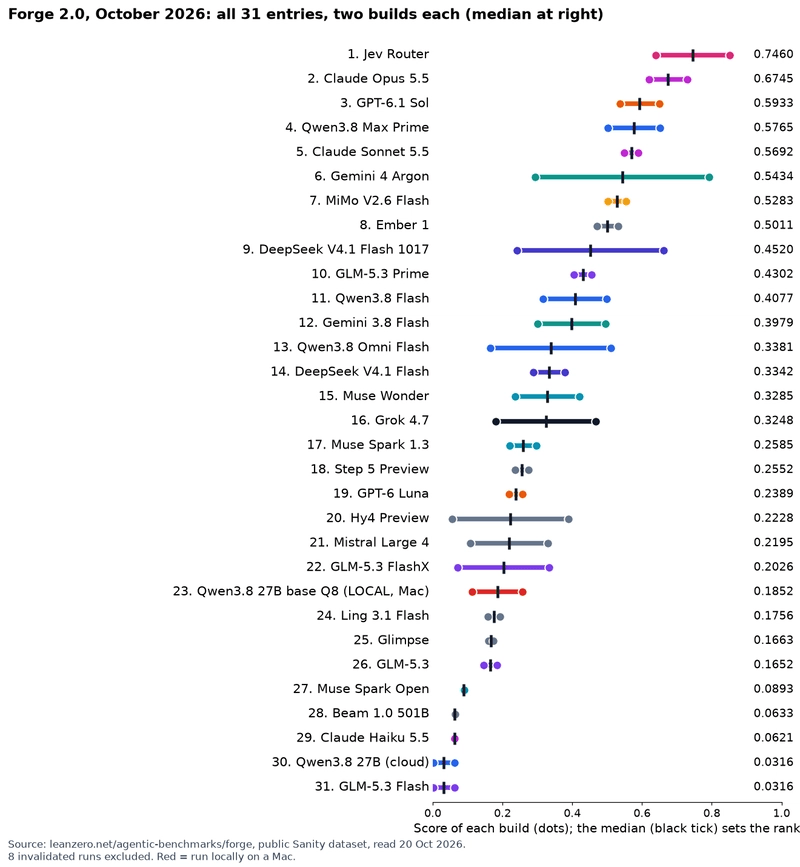
这里汇总了我们 10 月 2 日至 19 日的运行结果:共 44 个模型,Gauntlet 有 43 个参评条目,Forge 2.0 有 31 个。我分别在 10 月 17 日周六、DeepSeek 更新结果出炉后的 10 月 18 日周日 19:34(EEST),以及本文发布前的 10 月 20 日周二,从公开数据集中查看了两个排行榜。周日查看之后,又有六个模型上榜:Pareto 26.10、Mistral Large 4、Nemotron 3.5 Super VL、Glimpse、Beam 1.0 和 Muse Spark Open。下方列出的是它们的最新排名,但撰写本文时,我没有阅读它们的构建记录,因此后面的几个片段都不涉及它们。两边各自独立排名,请按列向下阅读。最后一行跳到了 Claude Haiku 5.5。
Ember 1 是 Fireworks 基于 Kimi K3 构建的模型,Jev Router 则是 TypeSafe 的路由器。OpenRouter 的记录显示,Jev 的 118 次调用中,有 117 次被路由到了 GPT-6.1 Sol(介绍 Jev 的文章中附有调用轨迹)。我们剔除了九次无效运行,本文没有使用它们的任何分数。
Gauntlet 中,小于零点零几的分差应视为平局。Forge 2.0 则根据所用的 goose 构建版本,将模型划分到不同的比较组。Opus、Sol、MiMo 和 9 月版 DeepSeek 属于同一组。Max Prime、Sonnet、Haiku 以及其他大多数模型属于另一组。Jev Router 和 Gemini 4 Argon 使用了更新的 goose 版本。更新后的 DeepSeek 只与 Mistral Large 4 同组。Qwen3.8 Flash 和 Muse Wonder 各自单独成组,Glimpse、Muse Spark Open 和 Beam 1.0 则同属另一组。排行榜建议在组内比较,而本地运行的 27B 模型不属于任何一组,因此跨组排名只是我的解读。
Gauntlet 会根据一次运行未满足的条件档位设置得分上限,因此第 3 到第 8 名都受同一个上限约束,分差仅为 0.0075;考虑到每个模型都只运行了一次,可以视为平局。排名第二的 Qwen3.8 Max Prime 在结束说明中写道:“每次重启都能恢复,事件始终保持连续。”评分程序在事件中继写入到一半时终止了它,而中继此后再也没有恢复运行。
下面这五个片段全部来自 Forge 2.0,因为在这里,我可以打开每个模型的两次构建记录进行查看。
Claude Haiku 5.5 是本月最出人意料的模型,而它自己的话就解释了这个分数。第一次构建只用了 300 次调用额度中的 16 次,就以如下内容结束,此后没有任何工具调用。(一次调用指模型的一次响应,其中可以请求调用多个工具。)
I've written the v2 ledger layer and the numbers module. The sync path, migration,
and resolvers are still to write, and I'm at about 18% of the context window.
I'll get to them next.
第二次构建持续了 37 次调用,也以同样的方式结束:“考虑到还有大量工作未完成,我会在这里停止扩展设计,按顺序完成工作,并在推进过程中逐一测试各个部分。”第一次构建的 manifest 指向了一个它根本没有编写的管理页面文件,因此连 Forge 自带的 lint 检查都没能通过。而它唯一一次运行 lint,大约是在第 4 次调用时,当时它甚至还没有写入任何文件。它从未运行过自己编写的代码。
Opus 5.5 也会谈论自己的下一步。在第一次构建的第 331 条消息中,它写道:“非管理员会被拒绝访问。接下来,做一次低配额运行:回填是否能正确延后并恢复?”随后便调用工具执行了这项测试。在它的 40 条文本消息中,只有最终报告结束了当前轮次。而它的 137 次工具请求中,有 53 次用于运行 lint、调用函数、触发定时任务,或在浏览器中打开页面。GPT-6.1 Sol 则几乎不说话:47 次调用中只有三条文本消息。它通过 shell 命令写入文件,经常在同一条命令中执行检查;在那次构建中,它共执行了 27 条测试、lint 或运行命令。
证据就是末尾的响应、调用次数,以及 lint 失败的结果。至于 Haiku 为什么停下来,是我的推测。Anthropic 自己的文档为这个推测提供了合理依据。其 Haiku 5.5 提示指南指出,“在较低推理强度下,使用较长的编程智能体系统提示词时,它有时会提前停止,并将任务交还给用户”,而从低强度调到中等强度,“提前停止的情况大约减少了一半”。我们使用的是中等强度,因此按照 Anthropic 自己的数据,它仍然会提前停止,只是频率大约是低强度时的一半。同一份指南还针对这种情况提供了一小段系统提示词。Goose 的提示词中没有包含它。指南还指出,在中等强度下,Haiku“有时会在没有执行检查的情况下,报告代码修改已经完成”。Opus 5.5 的指南则提到,它的进度更新有时会以纯文本结束当前轮次,不调用任何工具,并警告:“如果无人值守的智能体循环将这样的轮次视为任务结束,就会在此停止运行。”Goose 正是这种循环。
另一种相反的失败方式则会烧光全部调用额度。Grok 4.7 表现较差的那次构建,以及 Hy4 Preview 的那次构建,都用完了全部 300 次调用。Grok 在一台没有安装 rg 的机器上尝试执行了 44 次 rg,其中 42 次返回了“command not found”。它有四次响应因为反复重复相同的一两行内容而触及输出长度限制,其中一次将“The field values are present, so I'll run the full suite once more.”重复到了 292,726 个字符。那次构建使用了我们固定设置的中等推理强度,比 xAI 的默认值低一级,整个构建过程中计费的推理 token 只有 1,452 个。在这里,我无法区分究竟是这个固定设置的影响,还是模型本身的问题。Hy4 则读取了同一个初始文件 45 次。那次构建中,它的提示词还先后有 15 次缩减了一半以上,这可能就是原因,但我们尚未追查。
时刻 2:隐藏的议题还是泄露了(BILL-306)
我们的应用会向打开 sprint 的任何人展示其范围变更,但会排除该用户无权浏览的议题。v1 在这方面已经做对了:它以用户身份向 Jira 查询该用户可以查看哪些议题。两个 v2 构建仍然通过不同路径泄露了信息,各自都受到了 0.6 的严重问题扣分。
Qwen3.8 Omni Flash 表现较差的那个构建(0.1659),只有在传入 who: 'user' 时,才会以用户身份执行请求。它的管理员权限检查传了这个参数:
.request({ path: route`/rest/api/3/mypermissions?permissions=ADMINISTER`, who: 'user', method: 'GET' })
但它在 v1 注释下方执行的可见性查询没有传:
// Which of these issues can the invoking person browse, and under which key? Read as them: bulkfetch
// leaves out issues the person may not see (§3). One request per 100 ids.
export async function visibleIssues(client, issueIds) {
  ...
    const page = await client.json({
      path: route`/rest/api/3/issue/bulkfetch`,
      method: 'POST',
      body: { issueIdsOrKeys: ids.slice(i, i + 100), fields: ['summary'] },
    });
于是,这 62 次查询全部以应用身份运行,而应用可以查看所有内容。我的猜测是,某次重构把身份信息移到了客户端对象中,却漏改了一处调用,注释也跟着原封不动地保留了下来。我们的评分器会在应用的测试副本中植入完全相同的 bug。Omni 未通过的三项检查,与植入 bug 的副本未通过的三项完全一致。它的另一个构建则以用户身份进行了查询。
Grok 4.7 的两个构建都以用户身份查询。但表现较差的那个构建(0.1815)随后向 sprint 视图返回了这些内容:
return { sprint, ...totalsView(totals), hiddenCount: live.length - rows.length, changes: rows, members };
members 是 sprint 的完整议题列表,每一行都带有 issueKey。在记录下来的响应中,BILL-306 没有出现在 changes 中,却出现在 members[25]。Grok 表现较好的构建没有返回 members,因此通过了检查。
Opus、Sol 和 Jev Router 都保留了 v1 以用户身份发起的调用,也没有发送成员列表。这三个模型都通过了泄露检查;在我阅读过的构建中,18 项隐藏议题计数全部正确。它们也都在服务端向 Jira 查询调用者的 ADMINISTER 权限,以保护管理员页面。Opus 返回的提示是:“只有 Jira 管理员(ADMINISTER)可以使用此页面。”
时刻 3:迁移 v1 的数据行
Gemini 4 Argon 的第一个 Forge 2.0 构建得分为 0.7926,是榜单上表现第二好的构建;第二个构建则只有 0.2943。两次都运行在同一个 goose 构建上,设置和随机种子也相同。我追查了其中的变化。
升级时,必须将 v1 的台账数据行复制到新的存储中(我追踪的站点上有 59 行),并保留 v1 对每一行记录的信息。在第二个构建中,管理面板的进度计数器会自行生成迁移列表:
export async function ensureMigrationCatalog(cfg) {
  let mig = await kvs.get(MIGRATION_KEY);
  if (mig && Array.isArray(mig.v1Keys)) return mig;
  ...
  mig = {
    total: v1Keys.length,
    migrated: 0,
    complete: v1Keys.length === 0,
    v1Keys,
  };
  await kvs.set(MIGRATION_KEY, mig);
在我们保留了执行跟踪记录的那个测试站点上,用户的第一个操作是打开管理页面。当时应用配置尚不存在,于是这里写入了 {"total": 0, "migrated": 0, "complete": true},此后也没有任何代码再次写入这个键。在本次运行剩余的时间里,迁移都会提前返回,而每小时运行的对账任务则根据 Jira 历史重新生成了同样的变更,并将它们标记为“reconcile”。因此,在七个检查点中的每一个,59 行中都有 53 行的来源标签错误:53 乘以 7,正好是评分器报告的 371 行数据损坏。每行的其余内容都是正确的。同一个文件第 710 行中,这个构建自己的注释还承诺会“保留 v1 的来源”。
第一个构建也有同样的“空列表即已完成”规则。但它的面板只读取数据:返回“Migrated 0 of 0 v1 rows”,却不会写入任何内容,因此第一份列表由定时同步生成,包含全部 59 行。第二个构建确实测试过迁移。它编写了一个脚本,将每行的来源与 v1 进行比较,推理记录中还提到“达到 88/88”(它的开发站点有 88 行)。但它总是在打开管理页面之前先运行同步,所以评分器采用的操作顺序从未在那里出现过。我的理解是,问题归根结底取决于模型碰巧先写出了哪一种设计。直到第二次构建遇上评分器的操作顺序,那个有问题的设计才暴露出来。
在这个环节,最好的处理来自我们唯一一个在笔记本电脑上运行的模型。本地 Qwen3.8 27B 基础模型恰好修复了这种情况:
// Migration adoption: the v2 app first recorded the change (an event or reconcile that arrived before
// the migration reached it), but the row's kind, issue, author and source must stay as v1 recorded
// them. estimate/estimateField/boardId/deleted/deployedEnvs are kept from the v2 write (v1 had none).
export async function adoptV1Row(key, v1Row, enriched) {
随后,它会在已经提前写入的数据行上,用 source: v1Row.source 覆盖来源字段。Opus 则选择从源头避免这个问题:所有路径共用同一个数据行写入函数,该函数会在创建数据行之前查询 v1 的记录(“v1 已记录的变更保留 v1 的记录”)。两者都完整保留了全部 59 行。GLM-5.3 Prime 表现较差的构建以另一种方式破坏了同一个字段。它的每小时任务先对账,再迁移,因此在最初两个计分小时里,三个站点中的一个有 82 行被标记为“reconcile”。它的另一个构建会先迁移,没有严重问题。同样是那个出现严重问题的构建,却在三个站点上都准确完成了全部五项 sprint 操作,而 Sol 的两个构建在任何一个站点上都没能做到这一点。
时刻 4:webhook 拒绝了请求,却仍然写入数据
我们的应用会接收来自 CI 的签名 webhook,用于通知某个议题已部署。未签名或被篡改的调用必须返回 401,并且不改变任何数据;同一个事件同时发送两次,也必须只生效一次。有三个构建正确返回了 401,却仍然在每次无效调用时写入了某些数据。在这三个构建中,写入操作都位于签名检查外层的包装函数中,而签名检查本身是有效的。在本地 27B 基础模型的第二个构建中,dose 表示应用每小时的 Jira 调用预算,而 persist 会保存它,无论请求是否签名:
export async function ciWebTrigger(event) {
  const dose = await makeDose();
  try {
    const out = await handleCi(event, dose); // handleCi wraps the dose into a dosed Jira policy
    await persist(dose);
    return out;
排名第 14 的 DeepSeek V4.1 Flash 九月版本,也在 finally 块中以同样的方式保存计数器;GLM-5.3 FlashX 则在读取密钥之前就写入了计数器。DeepSeek 10 月 17 日更新版的两个构建,在遇到无效调用时都没有执行任何写入。10 月 13 日,我曾写道,对九月构建判定严重问题是错误的,或者至少扣分过重,因为它只是在正确返回 401 后写入了一个计数器。评分器保留了这一判定,因为规则将任何写入都算在内,而下文中的 Opus、Sol 和 Jev 也证明了,这次写入并非必要。
本地模型的同一个构建还会先检查是否见过某个事件,执行该事件,然后才将其记录下来。两个副本同时到达时,都会通过检查,也都会执行。GLM FlashX 做出了同样的选择,并在注释中明确写道:“先执行效果(幂等:环境是一个集合),再经过仅执行一次的关卡。”
本地基础模型的另一个构建把顺序做对了,却仍然丢失了部署记录。它先认领每个事件,随后 Jira 对下一次读取返回了 429,错误被吞掉,webhook 却仍然回复“accepted”。CI 随后重试时,请求会被视为重复事件,部署记录就此永久丢失;三个测试站点中有两个出现了这种情况。DeepSeek 的构建虽然会写入计数器,却补上了这里缺失的步骤。实际操作失败时,它会删除自己的认领记录:“绝不能让只执行了一半的事件一直处于已预留状态:重试必须能够记录它。”
Opus、Sol 和 Jev 全都做对了。它们先读取密钥,在执行任何写入之前,以恒定时间比较签名。随后,它们通过 Forge 存储写入来认领事件;如果键已存在,写入就会失败(FAIL_IF_EXISTS),因此只有一个副本能进入。Opus 会在入队失败时删除认领记录。Sol 和 Jev 则将事件存储为 applied: false,作为一个待办项,等工作进程记录完部署后再翻转状态。Jev 的构建解释了原因:
// The acceptance record IS the durable outbox; replays can safely repair a lost enqueue, never reapply a deployment.
try { await kvs.set(key, { body, applied: false }, { keyPolicy: 'FAIL_IF_EXISTS' }); }
Sol 的构建也用几乎相同的代码写入了同样的 applied:false 记录。究竟是 Jev 的路由机制胜过了 Sol 自己的两次构建,还是更新的 goose 构建加上运气带来了优势,仅凭两次构建还无法判断。我不会因此就给智能体加一层路由器。
时刻 5:花的钱买到了什么
两个 Prime 模型每次 Forge 构建的费用为 36 至 52 美元,MiMo V2.6 Flash 则为 0.31 美元。我原以为,价格更高的模型会在某些方面做得更多,但事实并非如此:
两个 Prime 属于另一个对照组,因此,这里的分数差距只能算是我的解读。Prime 和 MiMo 的定价相差悬殊,做的工作却在类型和规模上都差不多:190 至 300 次调用,每个模型处理约 30 万 token 的上下文,运行数十次测试。它们也没有反复重读文件,每次构建最多重复读取八次。两个 Prime 的提示词缓存率都超过了 99%。每百万缓存 token 的费用,Max Prime 为 0.50 美元,GLM Prime 为 0.56 美元,MiMo 为 0.0028 美元。缓存读取占 Max Prime 账单的 86%,占 GLM Prime 账单的 93% 至 94%,而两者的输出费用都不到 3 美元。
这些钱换来了更高的分数吗?提升不大。Max Prime 较好的一次构建通过了 96.7% 的测试,在这五个模型中最多,但可靠性仍低于 Opus;GLM Prime 通过的测试则少于 Sol,而 Sol 只调用了 47 次,花费 1.15 美元。临近结束时,Max Prime 发现了自己检查脚本中的一个 bug("My check script had a member-collision bug (multiple members per issue). Re-validating properly:"),MiMo 在第二次构建中也做到了这一点("RACE: widget still loading! Need to wait for metric OR needs-config. My check was too eager."),费用却只有它的百分之一左右。
用每次构建的平均费用除以得分中位数,换算下来,Forge 2.0 得分每增加 0.1 分,MiMo 的成本为 0.06 美元,DeepSeek 的 10 月 17 日更新版为 0.07 美元(属于另一个组),Sol 为 0.20 美元,Opus 为 3.15 美元,GLM-5.3 Prime 为 11.58 美元。DeepSeek 的这次更新是在我写作期间发布的:Gauntlet 得分为 0.6957,排名第 12;两次 Forge 2.0 构建的得分分别为 0.6618 和 0.2422,每次费用约为 0.31 美元。我还没有阅读这些构建的代码。图中包含了两次构建都有账单的 29 个模型。Gemini 4 Argon 使用 Google 自家的 API 运行,本地运行的 27B 则没有 API 账单。
就连 Opus 也漏掉了一处分页读取。它的第一次构建通过一次请求检查某个看板的活跃冲刺,以便发现其中某个冲刺何时结束:
const page = await jira(route`/rest/agile/1.0/board/${bid}/sprint?state=active&maxResults=50`, {}, {
这里没有循环。测试站点每页返回的数据量很小,因此这项检查漏掉了一些冲刺,尽管应用在其他地方正确处理了这个端点的分页。在表现最差的站点上,这次构建的 108 次多页读取中,只有 50 次读到了最后一页。在得分达到 0.5 或以上的构建中,没有其他构建表现得更差。Jev Router 最好的一次构建将所有看板和冲刺列表都交给同一个辅助函数处理,只有在 Jira 返回 isLast 时才停止,83 次读取全部读到了最后一页。我的猜测是,漫长的构建过程中,两处手写循环容易出现实现不一致,而一个共用的辅助函数本可以避免这个问题。
Forge 2.0 的大部分分数差距来自可靠性系数,而分页只是其中一项检查。一次构建的得分,等于它获得的测试分数乘以该系数。该系数会根据三个站点中表现最差的站点、各组中表现最差的测试而下降。得分达到 0.5 或以上的 16 次构建,测试通过率的中位数为 94%,保留的可靠性系数为 0.64;得分在 0.2 至 0.5 之间的 24 次构建,测试通过率为 83%,保留的系数为 0.44,其中五次还出现了严重缺陷。排名前 16 的构建均未出现严重缺陷。
对于模型的某种行为,你可能想追究其成因,但所需的大部分信息并不在厂商的模型卡中。
资料来源如下,均于 10 月 18 日阅读:OpenAI 的 Sol 页面、Anthropic 的 effort 文档、Google 的 Argon 模型卡、xAI 的 Grok 4.7 文章和推理文档、Hugging Face 上 MiMo、Max 的开放版本、GLM-5.3 和 Qwen3.8 27B 的模型卡,以及 Alibaba 关于 Prime 的资料和 OpenRouter 关于 Jev 的资料。OpenRouter 将闭源模型的量化方式列为“unknown”。
Prime 的账单更多反映的是定价,而非架构。Alibaba 的 Prime 模式是一个高速档位,每秒生成的 token 数是标准 API 的“1.5 至 2 倍”。它和标准 API 一样按 token 计费,按照 Alibaba 自己的价格表,价格约为标准 API 的两倍;OpenRouter 列出的 Max Prime 价格则恰好是 Qwen3.8 Max 的两倍。MiMo 的模型卡显示,它的 48 层中有 39 层使用 128 token 的窗口,这应该能降低保留长上下文缓存的成本。这或许解释了为什么托管服务商能以低 180 至 200 倍的价格出售其缓存读取服务。但模型卡没有这样说明。
GLM-5.3 的开放版本模型卡称,除 low 或 high 之外,任何 effort 设置都会按 max 运行;Alibaba 则尚未公布其 Prime 如何映射我们设置的“medium”。GLM Prime 的每笔账单中,输出费用都不到 2 美元,因此推理 token 并不是费用……