
9.0
重磅
AI SCORE
模型发布2026-09-29 02:00
Claude Sonnet 5.5 发布:性价比翻倍
The New Stack#Anthropic#Claude#大模型
Editor brief · 编辑速览
Anthropic 推出新版主力模型,性能接近 Opus 但价格仅为一半。
Anthropic 于周一发布了 Claude Sonnet 5.5,这是其主力模型的最新版本,也是 Claude 5.5 家族的第二个模型(仅次于上周发布的 Opus 5.5)。
家族中最小、最实惠的模型——新版 Claude Haiku——已在路线图上,将在未来几周内发布。
速度提升 30%,成本降低高达 30%
Anthropic 表示,新版 Sonnet 模型生成内容的速度比前代 Sonnet 5 快了超过 30%,同时每个任务的成本降低了高达 30%。这使得 Sonnet 5.5 成为公司迄今为止最快的 Sonnet 模型,用 Anthropic 的话说,它是"更快、更低成本的 Claude Opus 5.5 补充版本"。
Anthropic 认为该模型"最擅长处理范围明确的日常任务、修复 bug,以及创建精美的文档、幻灯片和电子表格"。早期测试者也指出它"能为用户界面增添光彩,并能遵循幻灯片模板创建只需最少编辑的演示文稿"。
与 Opus 5.5 一样,Sonnet 5.5 的写作表达也比 Anthropic 之前一代的模型更加清晰流畅。
多数基准测试接近 Opus 水平
Anthropic 表示,最大的提升体现在编程方面。在 Terminal-Bench 4.0(测试 agents 执行命令行任务的基准)上,Sonnet 5.5 得分为 70.6%,而 Sonnet 5 仅为 10.3%,领先于 Opus 5.5 的 66.4%。(基准维护者指出,Sonnet 5 有时会遇到超时和 token 限制问题,这有助于解释其低分。)
在 CursorBench(使用真实 Cursor 编码会话任务)上,Sonnet 5.5 与 Opus 5.5 相差约两分。在 Cognition's FrontierCode(检查代码变更是否可以无需人工编辑即可合并)上,Sonnet 5.5 在第二高 effort 设置下得分为 52.1%,相比之下 Opus 5.5 为 54.4%,OpenAI 的 GPT-6 Sol 为 49.3%。
在知识工作方面,Sonnet 5.5 在 Artificial Analysis 的 GDPval-AA 上得分为 1,844,该排名根据 44 个职业的真实世界任务对模型进行 Elo 评分。这仅比 Opus 5.5 落后两分,比 Sonnet 5 领先约 400 分。Sonnet 5.5 也超越了 GPT-6 Sol 的 1,487 分。
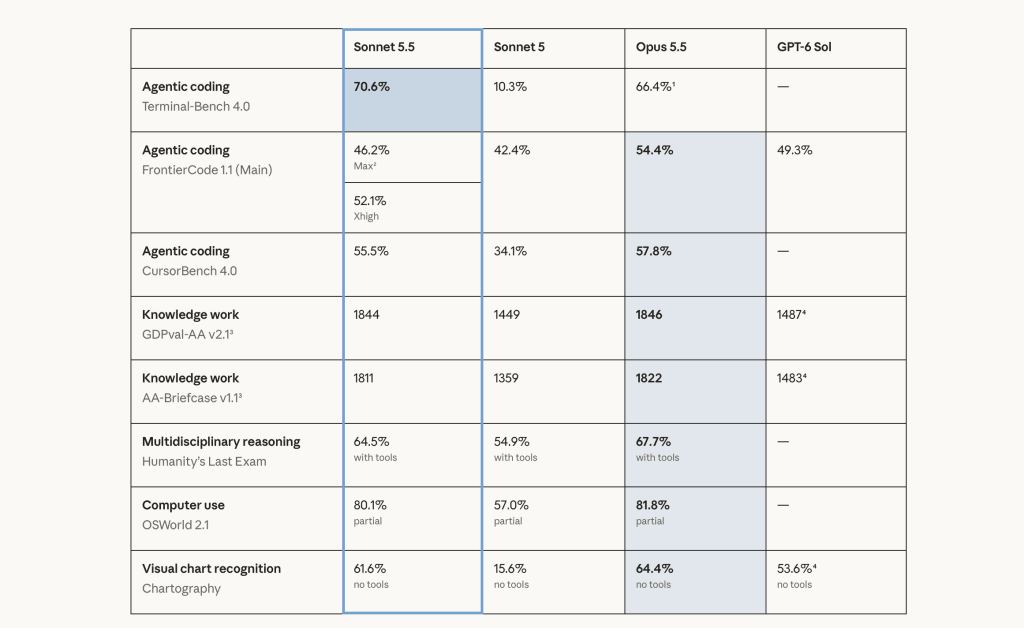
新模型在 computer use 和 Humanity's Last Exam 上也接近 Opus 5.5 的水平。在一次非正式的长时工作与图像理解测试中,Anthropic 表示,这是第一个仅凭截图就能超越 Pokémon Red 的 Sonnet 模型。
Anthropic 指出,在多个基准测试中,Sonnet 5.5 以低或中等 effort 运行时,每个任务的成本约为 Sonnet 5 最佳表现的十分之一。
尽管如此,公司表示 Opus 5.5 在需要持续判断的复杂、开放式工作方面仍然"明显更强"。
定价与可用性
虽然 Anthropic 下调了 Opus 5.5 的价格(降至每百万输入 token 4 美元、每百万输出 token 20 美元),OpenAI 同一天也将 GPT-6 Sol 和 Luna 模型的价格减半,但 Sonnet 5.5 的定价保持不变,仍为每百万输入 token 2 美元、每百万输出 token 10 美元。Cache 读取价格为每百万 token 0.20 美元。
这一定价与 OpenAI 次旗舰模型 Astra 相同。
不过,由于据该公司自己的测量,新模型使用的 token 要少得多,因此运行它的成本应该低于运行 Sonnet 5。
Sonnet 5.5 现已在 Claude Platform、Amazon Web Services、Google Cloud 和 Microsoft Azure 上可用。关闭 thinking 使用 Sonnet 的开发者,在迁移到 Sonnet 5.5 之前需要切换到新的 between_tools 设置。Opus 5.5 已完全拒绝关闭 thinking 的请求。
由于 Anthropic 认为 Sonnet 5.5 的网络安全能力与 Opus 5.5 相当,这是首款采用与最强大模型相同网络安全防护的 Sonnet 模型。
公司表示,常规 bug 修复不受影响,但高风险的网络安全请求将回退到 Sonnet 5。它也是第一个配备分类器的 Sonnet 模型,旨在防止攻击者提取其推理过程来训练他们自己的模型。