
8.0
热点
AI SCORE
技术实践2026-10-14 15:05
多步 Agent 提分,未必是规划有效
dev.to · AI#多智能体#状态传递#实验评估
Editor brief · 编辑速览
作者模拟 LangGraph 子图状态边界,发现规划内容未完整传入执行步骤,但三步流程仍优于单次调用。实验将提升归因于重新读取原始材料,并明确仅包含 12 个合成任务、每种条件运行一次。
LangGraph 的 subgraph 边界丢掉了计划,而效果提升来自重新阅读原始材料,不是计划本身。
我给一个本地运行的 8B 模型加了规划步骤,让它先规划,再执行实际任务。步骤之间的交接,则按照 LangGraph subgraph 自身 state schema 的实际行为来模拟:父步骤产出了一个字段,但子步骤的 schema 没有声明它,那么跨过边界后,这个字段就直接消失了。计划从来没有完整地到达下一步:每个任务中,真正跨过这道边界的,都只是 planner 实际输出中的一个 60 字符片段。我原以为这会损害效果。结果,三步流水线的准确率仍然明显超过了单次调用的基线。这两件事放在一起,才是这篇文章值得读的原因,因为第二件事,并不意味着它表面上看起来意味着的那件事。
本文写作使用了 AI 辅助,但每项论断都由我亲自核查事实并编辑。
先把验证条件摆出来。使用 Ollama 的 llama3.1:8b,本地运行,API 成本为零,temperature 为 0,seed 固定。测试包含 12 个合成的故障报告提取任务,每种条件各执行一次确定性运行——这是明确说明的实际局限,不是藏起来不说的局限。条件 A:每个任务调用一次。条件 B:用纯 Python 实现 planner → executor → reviewer 三步流水线,模拟 LangGraph subgraph 的 state-schema 边界,并没有实际运行 LangGraph 图,共调用 36 次。下文的每项论断,都能追溯到一个公开、可以重新运行的仓库:github.com/priyansh18/agent-handoff-loss-benchmark。
在解释之前,这次运行有四个结果值得先说清楚:
三步流水线的字段准确率为 91.7%,单次调用为 83.3%,代价是 token 用量增加到 4.4 倍,实际耗时增加到 5.7 倍。
12 个任务无一例外,planner 自己写的笔记都在 executor 看到之前,被从每份 368~584 个字符截断为 60 个字符。这是实实在在的 state-schema 不匹配,不是 prompt 有问题。
三个不同任务中的三个字段,从错误变成了正确。我专门把 executor 的中间答案和 reviewer 的最终答案分开记录,就是为了查明究竟是哪一步起了作用,而不是凭空假定:executor 只凭完整报告和提示中幸存的片段,在 reviewer 运行之前就已经达到 88.9%(32/36)。reviewer 在此基础上恰好又修正了一个字段。
这三处修正,没有一处能明确归因于 planner 的提示成功跨过边界、传递了有用信息。其中两处修正发生时,提示完全是套话,没有任何与任务有关的内容。第三处的提示确实包含一个有用的词,但那只是 planner 的句子断点恰好落在了那个位置,并不是流水线在设计上保护了这条信息。
这次运行以一个小规模实验复现的具体故障,是多 Agent LangGraph 交接中的信息丢失。Anthropic 在介绍自身多 Agent 系统工程实践的文章中,也指出了同一类问题:Agent 使用的 token 通常约为单轮聊天的 4 倍,完整的多 Agent 系统则约为 15 倍。其中一部分成本,花在了文章所说的“传话游戏”上:一个 Agent 的输出在传给下一个 Agent 的过程中,被不断总结,再总结。Anthropic 自己的解决办法,是让 subagent 把完整输出写入共享存储,而不是通过对话传递压缩后的摘要。我想先用数字看清这种失效模式,再相信对应的解决办法,而不只是写一段表示赞同的话。
在运行任何实验之前,我就写下了这个假设,让结果有机会真正推翻它:把一次提取调用拆成 planner → executor → reviewer 流水线,同时让 executor 的 state schema 比 planner 的输出范围更窄,会在交接时造成可测量的信息丢失;这种丢失会让准确率不超过单次调用基线,甚至更差,而不会带来提升。前半句成立了。后半句错了,而背后的原因值得好好琢磨。
测试包含 12 份简短、虚构的故障报告,作为测试样例编写,每份描述一个 bug:某次 feature-flag 发布耗尽了 Redis connection pool,过期的模型产物覆盖了缓存文件,密码重置链接被 URL 缩短服务截断,以及另外九个类似的案例。每份报告都为三个字段设置了标准答案所需的关键词:root_cause、affected_component、fix_action。只要模型答案包含对应字段所需关键词中的至少一个,该字段就算正确。评分器刻意采用这种机械规则,让评分可以复现,而不取决于我个人的判断。
条件 A 要求 llama3.1:8b 对每个任务调用一次,以 JSON 返回全部三个字段。条件 B 则对每个任务调用三次:
# The subgraph boundary, as code, not prose.
# The planner writes full notes; the executor only ever sees this:
focus_hint = plan_notes.split(".")[0][:60] if plan_notes else ""
这行代码是整个实验最关键的细节。它是纯 Python,不是一次 LangGraph StateGraph 调用。我有意这样写,是为了在不引入框架完整运行时的情况下,模拟 LangGraph 自身 subgraph 文档描述的行为:真正跨过父子边界的内容,由 subgraph 的 state schema 决定;父步骤产出的某个字段,如果子步骤的 schema 从未声明过,那么到了另一边,它就不存在了。没有异常,也没有警告。我故意把 schema 设计得很窄,就像一个赶工期的团队确实可能做的那样:先接好一个字段名,还没认真想清楚交接时究竟有哪些内容必须保留下来。
随后,executor 带着这个 60 字符的提示提取三个字段,reviewer 则拿到原始报告和 executor 的 JSON,可以修正答案。三次调用,三次答对的机会,每次都能看到同一份完整报告。
单次调用与三步流水线的对比:相同的 12 个任务、相同的模型、相同的机器。图片由作者根据本次运行的 summary.json 生成。
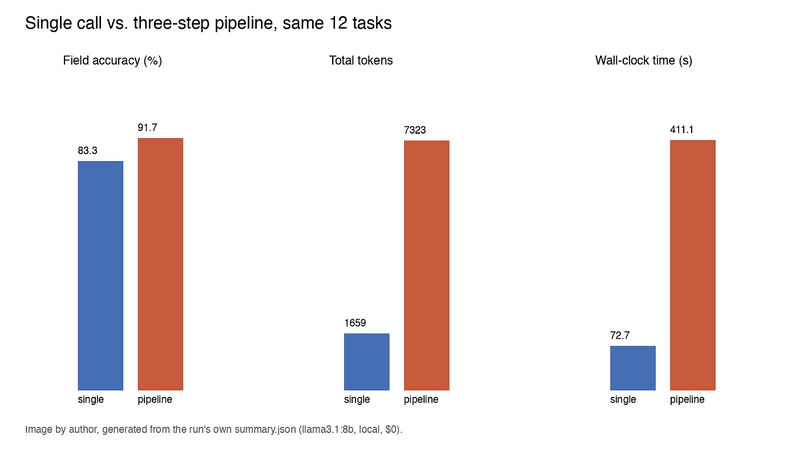
把数字并排来看:
字段准确率:单次调用为 30/36(83.3%),三步流水线为 33/36(91.7%)。
三个字段全部正确的任务数:7/12 对 9/12。
LLM 调用次数:12 对 36。
token 总量:1,659 对 7,323。
实际耗时:72.7s 对 411.1s。
还有一个上面对比没有展示的交接指标:12 个任务中,planner 的完整输出都在 368~584 个字符之间,而真正到达 executor 的 focus_hint 上限只有 60 个字符。下面展示其中一个任务的实际情况,使用的是日志中的原文,不是转述:
图片由作者直接根据本次运行的 raw_results.jsonl,通过程序生成。
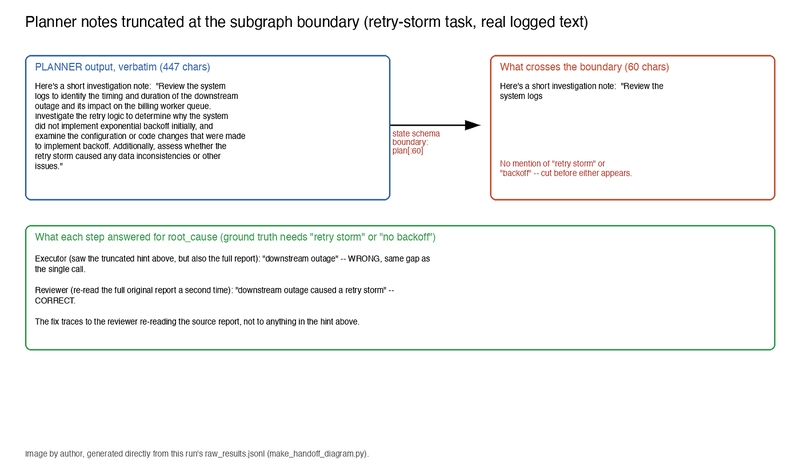
在 retry-storm 任务中,planner 的完整输出是:“下面是一份简短的排查笔记:‘检查系统日志,确认下游服务中断的发生时间、持续时长,以及它对计费 worker 队列的影响。调查重试逻辑,确定系统最初为什么没有实现 exponential backoff,并检查为实现 backoff 而进行的配置或代码变更。另外,评估 retry storm 是否造成了数据不一致或其他问题。’”executor 实际收到的却是:“Here's a short investigation note: 'Review the system logs”,只有 60 个字符,在“retry storm”或“backoff”出现之前就被截断了。
在两种条件之间,三个不同任务中的三个字段,从错误变成了正确。我专门把 executor 的中间答案和 reviewer 的最终答案分开记录,就是为了查明究竟是哪一步起了作用,而不是凭空假定。这三处错误,也并不是以同一种方式得到修正的。
在 feature-flag-leak 任务中,planner 的提示完全是套话:“Here's a short investigation note: Investigation Note”,60 个字符都是开场白,没有任何与任务有关的内容,是整次运行中最典型的无用提示。尽管提示没有传递任何信息,executor 在 reviewer 介入之前给出的答案,仍然是“由于复用共享缓存条目,导致 feature-flag targeting rule 泄漏”,答案正确。它是通过阅读完整的原始报告得出答案的:流水线中的每个步骤,除了 planner 提示中的内容,都会收到这份完整报告。
在 retry-storm 任务中,提示有一点泛泛的指导——“Review the system logs”——算不上纯粹的套话,但也不具体。executor 的答案仍然错误,和单次调用有同样的遗漏:只写了“下游服务中断”,没有提到 retry storm。reviewer 步骤再次拿到完整报告后,把答案修正为“下游服务中断引发了 retry storm”,通过评分。这是整次运行中唯一一处确实需要 reviewer 才能完成的修正,单靠 executor 自己阅读还不够。
第三处发生在 redis-pool 任务中,也是需要如实交代的一个复杂情况:单次调用漏掉了“redis”/“connection pool”,executor 却修正了它,而且这一次,60 字符提示里确实包含“Review the Redis connection pool confi”。planner 恰好一开头就写出了正确的关键词,然后才遇到截断。我无法排除提示在这里提供了帮助;如果说这个任务的提示也“毫无用处”,就是朝相反方向夸大结论。我能说的是:三处修正中,有两处发生时提示没有贡献任何信息;唯一一处提示可能提供帮助的情况,也只是句子断点恰好落在了某个位置,并非流水线的 schema 在设计上保证了这一点。
综合来看,诚实衡量 planner 这一步,它在本次运行中没有带来任何可靠收益。它唯一可能的贡献,取决于偶然的措辞,而不是架构本身。executor 自己阅读完整报告,即使不依赖提示,也已经达到 88.9%(32/36);这个数字直接来自保存的中间答案,不是推测。reviewer 在此基础上恰好又修正了一个字段,达到 33/36。如果我彻底去掉 planner 和 reviewer,直接把报告交给一次采用 executor prompt 的调用,我预计结果会接近 88.9%,而不是单次调用基线的 83.3%,因为 executor prompt 本身就比简单的单次调用 prompt 更强调结构化输出。我没有实际运行这个消融实验,所以这项具体比较仍然只是有依据的预期,不是测量结果;本节其余内容都有实测支撑。
有理论依据表明,在这里,重新阅读原始材料可能比交接内容更重要,这不只是我自己的一个案例。Stanford 的 Dat Tran 和 Douwe Kiela 在 2026 年 4 月发布了一篇预印本,《在相同思考 token 预算下,单 Agent LLM 在多跳推理中优于多 Agent 系统》。研究在三个模型家族上,将单 Agent 和多 Agent 配置的推理 token 预算保持一致,发现单 Agent 的表现始终能持平或超过多 Agent。他们的解释主要基于 Data Processing Inequality(数据处理不等式):一旦某个 Agent 把经过处理的上下文版本交给下一个 Agent,这一步中的信息量只可能减少或保持不变,不可能增加。我的 focus_hint 截断,就是这个不等式的一个具体、可测量的体现,并不是什么边缘情况。我的运行结果又提供了一个指向相同结论的数据点,而且机制直接呈现在日志中,不需要靠推断:提升是真实的,91.7% 确实超过 83.3%;但这主要是靠各个步骤重新阅读原始故障报告换来的,不是靠架构中的规划步骤。而多数多 Agent 文章,偏偏花了最多篇幅论证规划步骤的价值。
对这次运行的诚实解读,比“多 Agent 赢了”或“多 Agent 是个坑”都要克制。面对一个只有 12 个任务的本地实验,这两种说法都夸大了结论。它确实支持的是:某个步骤重新查看原始材料,而不是相信前一步对材料的摘要,能够发现真实的错误。这里有三个字段因此得到修正,代价是 token 用量达到 4.4 倍,延迟达到 5.7 倍。规划步骤通过一个过窄的 schema 交接,无法承载自己产出的内容,因此没有带来可靠收益;如果彻底去掉它,让流程直接从报告走向 executor,再到 reviewer,汇总表看起来也会几乎一样。
给任何流水线添加规划步骤之前,值得问的不是“更多结构会不会有帮助”,而是“具体有哪些信息必须从这一步保留到下一步,我的 state schema 是否真的承载了这些信息”。这是一个具体、可以检查的问题,不是凭感觉。添加 review 步骤之前,更该问的是 reviewer 能否再次拿到原始材料,还是只能看到前一步的输出。因为这里 reviewer 的优势,明确来自重新阅读报告,而不是孤立地审视 executor 的 JSON。
完整脚本、任务集、每个任务的原始输出,以及上面的图表,都直接来自本次运行:github.com/priyansh18/agent-handoff-loss-benchmark。所有内容都在本地通过 Ollama 运行,不需要任何 API key;任何机器只要拉取了同一个模型,就可以复现。不过,硬件或 Ollama 版本不同,具体数字仍可能略有变化,因为实际耗时和 token 数量并不是与硬件无关的指标。一个实际局限是:每种条件只执行了一次确定性运行,没有重复试验的结果分布。因此,只要有一个字段的对错发生变化,准确率就会向任一方向移动 1/36,也就是 2.8 个百分点。我陈述的是这次运行中发生了什么,而不是声称得到了一个很窄的置信区间。第二个局限是:基于关键词的评分器更奖励信息完整性,而不是精确性;这也部分解释了为什么另外三个任务在两种条件下都没有答对,具体见仓库中的 failure_examples/。我认为,对这类任务来说,这样评分还算合理,但它终究是一项主观取舍。我在这里明确说明,而不是放任数字显得比实际更漂亮。
如果你也搭建过 planner-executor-reviewer 流水线:你有没有检查过,规划步骤产出的内容,究竟有哪些真正保留到了交接之后?还是和我差一点做出的选择一样,直接相信它能传过去?
LangGraph subgraph 与 state-schema 文档:docs.langchain.com/oss/python/langgraph/use-subgraphs
Anthropic,《我们如何构建多 Agent 研究系统》:anthropic.com/engineering/multi-agent-research-system
Tran 和 Kiela,《在相同思考 token 预算下,单 Agent LLM 在多跳推理中优于多 Agent 系统》,2026 年 4 月:arxiv.org/abs/2604.02460
完整复现材料:github.com/priyansh18/agent-handoff-loss-benchmark。上面的每个数字都由 tasks.py 和 run_bench.py 生成;raw_results.jsonl 包含每个任务的完整输出,包括每一个被截断的 focus_hint,以及 executor 的中间答案;failure_examples/ 则逐一分析了每个从错误变为正确的任务,以及仍然错误的任务。
我的更多内容:notes.priyanshsinghal.com 上有这些文章所依据的路线图;我的 LinkedIn 地址是 linkedin.com/in/priyanshsinghal。
如需采取进一步措施,你可以考虑屏蔽此人和/或举报滥用行为。