
8.0
热点
AI SCORE
编程提效2026-10-14 17:33
Gemini 4 Argon 迁移需查参数兼容与计费
dev.to · AI#Gemini#API迁移#成本控制
Editor brief · 编辑速览
文中称 Gemini 4 Argon 已向付费 API 用户开放,部分旧参数会被静默忽略,摘录未列出具体参数。其输入、输出单价截至 11 月 30 日分别为每百万 token 2 美元和 10 美元,12 月起翻倍,思考 token 按输出计费且默认启用中等思考。
提示:程序不会崩溃。问题恰恰就在这里。
10 月 13 日,Google 向所有付费 Gemini API 用户开放了新旗舰模型 Gemini 4 Argon。模型 ID 是 gemini-4-argon,Vercel AI SDK 的 Google provider 也在当天加入了支持。
所以,这次升级看起来只需要改一行代码:替换模型字符串,上线,搞定。
但 Argon 不再遵循旧规则。有些你已经传了几个月的设置,现在会被忽略。应用不会抛异常,测试也不会失败。它只是悄悄停止按照你以为的方式运行。
而且,这次升级还附带了一个截止日期。
根据 Google 的定价页面,截至 11 月 30 日,Argon 每百万 input tokens 收费 2 美元,每百万 output tokens 收费 10 美元。从 12 月 1 日起,价格分别变为 4 美元和 20 美元。Batch 和 Flex 的价格是上述数字的一半,也会在同一天翻倍。
比标价更值得注意的,是下面两个细节:
Thinking 按 output 计费。定价表写得很明确:“输出价格(包含 thinking tokens)”。默认 thinking level 是 medium,因此每次调用都会进行一定程度的思考,即便只需要一个简短回答。
没有免费档。Google 的定价页面说明,Argon“无法在 Free tier 或 Google AI Pro plan 中使用”。
来看一个粗略的例子,数字仅用于说明,不是 benchmark。假设某个功能每月调用 10,000 次,每次包含 2,000 个 input tokens,以及 800 个 output tokens,后者包含 thinking。现在每月费用为 40 + 80 = 120 美元;从 12 月起,同样的流量就要花 240 美元。
所以,如果你这周正在测试 Argon,请按 12 月的价格计算预算。
Google 的开发者指南里有一小节“从先前模型迁移”。这一节很容易被跳过,但你最好仔细看看。
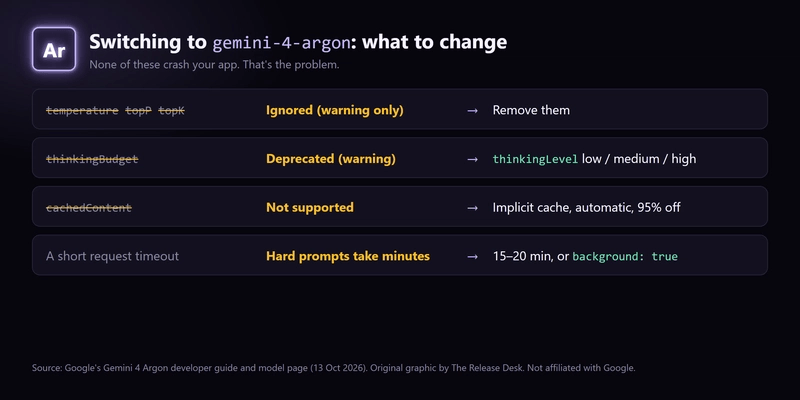
temperature、top_p 和 top_k 会被忽略。Google 的原话是:“gemini-4-argon 会忽略自定义采样值,并返回弃用警告。”注意,是警告,不是错误。请求仍然成功,而你精心调好的 temperature: 0.2,现在只是个摆设。
thinking_budget 已被弃用。Argon 改用 thinking_level,有三个取值:low、medium(默认值)和 high。Google 建议分类、路由和信息提取任务使用 low,多文件调试和架构工作使用 high。
显式上下文缓存取消了。如果你的代码会创建缓存并传入 cached_content,Argon 不支持这种做法。现在缓存是隐式的:它会自动生效,命中缓存的 input tokens 享受 95% 的折扣。
可以把它想成一辆新车,按下定速巡航按钮却没有反应。车依然能开,只是你已经无法用这个按钮控制车速了。
把 temperature 设为 0?会被忽略。
把 thinking budget 设为 2,048?已被弃用。
搭建了缓存层?现在不再支持。
如果你通过 Vercel AI SDK 调用 Gemini,典型的“修改前”代码是这样的:
import { generateText } from 'ai';
import { google } from '@ai-sdk/google';

const { text } = await generateText({
  model: google('gemini-2.5-pro'),
  temperature: 0.2,
  providerOptions: {
    google: { thinkingConfig: { thinkingBudget: 2048 } },
  },
  prompt,
});
Argon 版本则是:
const { text } = await generateText({
  model: google('gemini-4-argon'),
  providerOptions: {
    google: { thinkingConfig: { thinkingLevel: 'low' } },
  },
  prompt,
});
thinkingLevel 选项和 gemini-4-argon 模型 ID 都已包含在 @ai-sdk/google 4.0.95 中,该版本于 10 月 13 日发布。所以,先更新这个包。如果你在 providerOptions 中使用了 cachedContent,请将其移除。
还有一个小陷阱:SDK 的类型也允许 'minimal',因为较早的 Gemini 模型接受这个值。但 Argon 文档只列出了 low、medium 和 high,因此请只使用这三个值。
这件事不属于前面的设置变更,但它可能让生产环境出问题。
Google 的指南指出,复杂推理 prompt“可能需要几分钟”。它建议将 HTTP 客户端的超时时间设为至少 15 到 20 分钟,或者让请求在后台运行,也就是在 Interactions API 中设置 background: true。
典型的 serverless 请求处理函数并不是为等待 20 分钟而设计的。如果你打算在 API route 中使用 thinkingLevel: 'high',请先检查平台允许的函数最长运行时间。或者,把这项工作移到后台任务中,再轮询获取结果。AI SDK 的更新日志表示,使用 Interactions API 时,generateText 现在会持续轮询后台调用,直到调用完成。
Argon 是一个能力很强的模型,Google 也报告了它在自家代码库上取得的显著成果。但独立排名对于它是不是最好的模型存在分歧,因此,最可靠的检验是你自己的 prompt,而不是排行榜。
没有争议的是这份检查清单。如果你没检查这些事项就替换模型 ID,应用仍然会运行,只是运行方式已经和你想的不一样了。
编辑结论:趁着半价,现在可以试试 Argon,但预算要按 12 月 1 日的费率规划。替换模型 ID 前,移除 temperature/topP/topK,将 thinkingBudget 改为 thinkingLevel,移除显式缓存,并为 high thinking 延长超时时间。
来源:Gemini 4 Argon 开发者指南(Google AI Studio)· Gemini API 模型页面 · Gemini API 定价 · Google 的开发者公告 · npm 上的 @ai-sdk/google(4.0.95)· VentureBeat 关于独立排名的报道
如果需要采取进一步行动,你可以考虑屏蔽此人和/或举报滥用行为。