
8.0
热点
AI SCORE
技术实践2026-10-17 11:01
手写 HNSW,实测向量检索召回损失
dev.to · AI#向量检索#RAG#TypeScript
Editor brief · 编辑速览
用 TypeScript 实现简化 HNSW,在 5 万条随机向量上比较不同 efSearch 设置的 recall@10,并以暴力搜索作为基准。实验帮助理解 pgvector、Qdrant 中搜索参数如何影响召回率与速度。
本系列:AI in TypeScript——共 5 本书,从第一次调用 LLM 到将 Agent 部署到生产环境,五本书均已收录。
我的项目:Hermes IDE | GitHub——为使用 Claude Code 和其他 AI 编程工具交付软件的开发者打造的 IDE。
关于我:xgabriel.com | GitHub
pgvector 的 README 用一句话说清了这件事:添加近似索引,就是“用一部分召回率换取速度”;索引建好之后,查询结果就会与精确扫描有所不同。HNSW 默认的搜索设置 hnsw.ef_search 是 40。如果你的 RAG 应用运行在 Postgres 上,而团队里从来没人改过 hnsw.ef_search,那么,决定模型能读到哪些文本块的,就是 40 这个数字。
Qdrant 也有同样的调节参数,只是名字叫 hnsw_ef,通过每次请求传入。数据库不同,算法相同,取舍也相同。
你可以阅读有关这种取舍的介绍,也可以亲手构建索引,观察它如何发生。下面,你会用 TypeScript 写一个小型 HNSW,在 Node 中为 50,000 个随机向量建立索引,并以暴力搜索为基准,测量 efSearch 分别为 10、40、100 和 200 时的 recall@10。脚本的运行过程是确定性的,代码也足够短,可以一口气读完。它打印的每一个数字,都来自你自己的机器。
HNSW 源于 Malkov 和 Yashunin 在 2016 年发表的一篇论文,研究如何利用 Hierarchical Navigable Small World 图进行近似最近邻搜索。抛开证明,剩下三个核心思路。
分层。 每个向量都位于第 0 层。随机选出的一小部分向量还会出现在第 1 层,更少的向量出现在第 2 层,以此类推。论文用 floor(-ln(uniform) * mL) 随机生成每个元素所在的最高层,并建议取 mL = 1/ln(M),其中 M 是每个节点的连接数。这样得到的结构有点像跳表:顶部稀疏,适合大步跳转;底部密集,用来精确查找。
贪心下降。 查询从顶层的单个入口节点出发,不断走向距离更近的邻居,直到找不到更近的节点。然后下降一层,从当前位置重复这一过程。在论文的搜索算法中,上层使用 ef = 1:只保留一个候选节点,完全采用贪心策略。
在第 0 层进行束搜索。 到了最底层,搜索会维护一个列表,保存目前找到的 ef 个最佳节点,并不断扩展尚未扩展过的最近节点。当距离最近的待扩展候选节点,比列表中最差的节点还远时,搜索停止。这里的 ef 就是 efSearch。搜索束越宽,探索的图区域就越大,找到的真实近邻越多,距离计算次数也越多。
用一张图理解 HNSW:在稀疏的上层进行远距离跳转,在密集的底层展开较宽的搜索束。
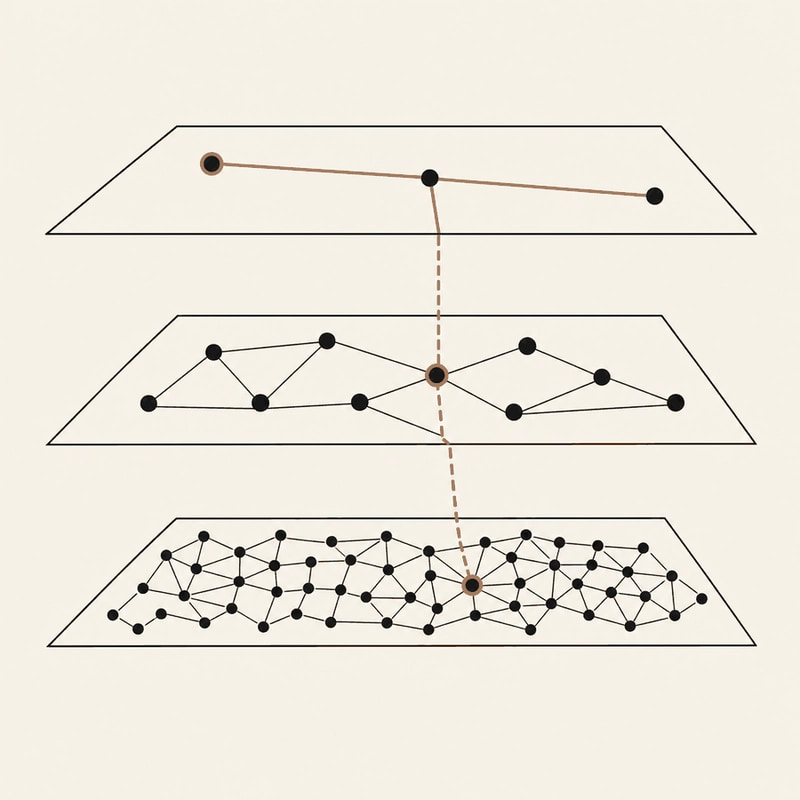
构建图时会复用同样的搜索过程。插入一个向量时,先用宽度为 efConstruction 的搜索束查找它的邻居,在它所在的每一层连接最多 M 个邻居,再裁剪那些连接数超限的邻居节点。论文建议第 0 层使用 2·M 条连接;这个版本也采用这一设置,其他层的连接数上限均为 M。
下面所有代码都放在同一个文件 hnsw.ts 中:按顺序追加各个代码块即可。Node 从 v22.18.0 和 v23.6.0 开始,可以通过剥离类型直接运行 .ts 文件,因此不需要构建步骤。代码避开了类型剥离不支持的 enum 和参数属性。
// hnsw.ts: run with `node hnsw.ts` (Node 22.18+)
type Vec = Float32Array;
type Hit = { id: number; d: number };

// mulberry32: tiny seeded PRNG, same data every run
function mulberry32(seed: number): () => number {
  let a = seed >>> 0;
  return () => {
    a = (a + 0x6d2b79f5) >>> 0;
    let t = a;
    t = Math.imul(t ^ (t >>> 15), t | 1);
    t ^= t + Math.imul(t ^ (t >>> 7), t | 61);
    return ((t ^ (t >>> 14)) >>> 0) / 4294967296;
  };
}

function randomUnit(dim: number, rand: () => number): Vec {
  const v = new Float32Array(dim);
  let norm = 0;
  for (let i = 0; i < dim; i++) {
    v[i] = rand() * 2 - 1;
    norm += v[i] * v[i];
  }
  norm = Math.sqrt(norm);
  for (let i = 0; i < dim; i++) v[i] /= norm;
  return v;
}
生成器使用固定种子,因此每台机器都会生成相同的 50,000 个向量,不同读者的运行结果也就具有可比性。接下来是距离函数和有序插入函数。
// squared L2; on unit vectors it ranks like cosine
function dist(a: Vec, b: Vec): number {
  let s = 0;
  for (let i = 0; i < a.length; i++) {
    const d = a[i] - b[i];
    s += d * d;
  }
  return s;
}

// keep `arr` sorted by distance, nearest first
function insertSorted(arr: Hit[], h: Hit): void {
  let lo = 0;
  let hi = arr.length;
  while (lo < hi) {
    const mid = (lo + hi) >> 1;
    if (arr[mid].d < h.d) lo = mid + 1;
    else hi = mid;
  }
  arr.splice(lo, 0, h);
}
向量已经归一化,因此欧氏距离的平方与余弦相似度给出的结果排序一致:对于单位向量,|a - b|² = 2 - 2·cos(a, b)。这里用有序数组代替了论文中的两个优先队列。它比堆慢,但当搜索束宽度只有几百时,这样写依然清晰、正确,而这两点在这里更重要。
暴力搜索就是标准答案。它计算每个向量的距离,并保留最近的 k 个。
function bruteForce(data: Vec[], q: Vec, k: number): number[] {
  const best: Hit[] = [];
  for (let id = 0; id < data.length; id++) {
    const d = dist(q, data[id]);
    if (best.length < k || d < best[best.length - 1].d) {
      insertSorted(best, { id, d });
      if (best.length > k) best.pop();
    }
  }
  return best.map((h) => h.id);
}
searchLayer 对应论文中的算法 2,selectNeighbors 对应邻居选择启发式算法,也就是去掉可选扩展的算法 4;insert 和 search 则分别遵循算法 1 和算法 5。
class HNSW {
  M: number;
  M0: number;
  efC: number;
  mL: number;
  rand: () => number;
  vecs: Vec[] = [];
  links: number[][][] = []; // links[node][layer] -> ids
  entry = -1;
  maxLayer = -1;

  constructor(M: number, efC: number, rand: () => number) {
    this.M = M;
    this.M0 = 2 * M; // layer 0 gets twice the links
    this.efC = efC;
    this.mL = 1 / Math.log(M);
    this.rand = rand;
  }

  // beam search on one layer, returns the ef best
  searchLayer(q: Vec, eps: number[], ef: number, lc: number) {
    const seen = new Set<number>(eps);
    const cand: Hit[] = [];
    const best: Hit[] = [];
    for (const id of eps) {
      const h = { id, d: dist(q, this.vecs[id]) };
      insertSorted(cand, h);
      insertSorted(best, h);
    }
    while (cand.length > 0) {
      const c = cand.shift()!;
      if (c.d > best[best.length - 1].d) break;
      for (const n of this.links[c.id][lc]) {
        if (seen.has(n)) continue;
        seen.add(n);
        const d = dist(q, this.vecs[n]);
        const worst = best[best.length - 1].d;
        if (best.length < ef || d < worst) {
          insertSorted(cand, { id: n, d });
          insertSorted(best, { id: n, d });
          if (best.length > ef) best.pop();
        }
      }
    }
    return best;
  }

  // keep a candidate only if it is closer to the base
  // than to every neighbor already kept
  selectNeighbors(cands: Hit[], m: number): number[] {
    const kept: Hit[] = [];
    for (const c of cands) {
      if (kept.length >= m) break;
      let ok = true;
      for (const k of kept) {
        if (dist(this.vecs[c.id], this.vecs[k.id]) < c.d) {
          ok = false;
          break;
        }
      }
      if (ok) kept.push(c);
    }
    return kept.map((h) => h.id);
  }

  shrink(n: number, lc: number, cap: number): void {
    const base = this.vecs[n];
    const hits = this.links[n][lc]
      .map((id) => ({ id, d: dist(base, this.vecs[id]) }))
      .sort((a, b) => a.d - b.d);
    this.links[n][lc] = this.selectNeighbors(hits, cap);
  }

  insert(v: Vec): void {
    const id = this.vecs.length;
    const level = Math.floor(-Math.log(1 - this.rand()) * this.mL);
    this.vecs.push(v);
    const layers: number[][] = [];
    for (let l = 0; l <= level; l++) layers.push([]);
    this.links.push(layers);
    if (this.entry < 0) {
      this.entry = id;
      this.maxLayer = level;
      return;
    }
    let ep = [this.entry];
    for (let lc = this.maxLayer; lc > level; lc--) {
      ep = [this.searchLayer(v, ep, 1, lc)[0].id];
    }
    for (let lc = Math.min(level, this.maxLayer); lc >= 0; lc--) {
      const found = this.searchLayer(v, ep, this.efC, lc);
      const nbrs = this.selectNeighbors(found, this.M);
      this.links[id][lc] = nbrs;
      const cap = lc === 0 ? this.M0 : this.M;
      for (const n of nbrs) {
        this.links[n][lc].push(id);
        if (this.links[n][lc].length > cap) {
          this.shrink(n, lc, cap);
        }
      }
      ep = found.map((h) => h.id);
    }
    if (level > this.maxLayer) {
      this.maxLayer = level;
      this.entry = id;
    }
  }

  search(q: Vec, k: number, ef: number): number[] {
    let ep = [this.entry];
    for (let lc = this.maxLayer; lc > 0; lc--) {
      ep = [this.searchLayer(q, ep, 1, lc)[0].id];
    }
    const found = this.searchLayer(q, ep, Math.max(ef, k), 0);
    return found.slice(0, k).map((h) => h.id);
  }
}
1 - this.rand() 可以避免计算 ln(0),因为生成器可能返回 0,却永远不会返回 1。search 还会确保搜索束宽度至少为 k,这与 hnswlib 的参数说明一致:ef“不能低于所查询的最近邻数量 k”。
邻居选择启发式算法,是这张图能够顺畅导航的关键。连接最近的 M 个点听起来很合理,但对于聚类数据,连接会局限在各自的簇内,搜索就会卡在簇的边界。论文的图 7 展示了这一点:简单规则在聚类数据上的召回率会停滞在较低水平,而启用候选扩展选项的启发式算法则不会。
把下面的代码追加到同一个文件。它使用 pgvector 的默认值 M = 16 和 efConstruction = 64 构建索引,通过暴力搜索计算精确答案,然后遍历不同的 efSearch 值。
const N = 50_000;
const DIM = 64;
const Q = 500;
const K = 10;

const rand = mulberry32(42);
const data: Vec[] = [];
for (let i = 0; i < N; i++) data.push(randomUnit(DIM, rand));
const queries: Vec[] = [];
for (let i = 0; i < Q; i++) queries.push(randomUnit(DIM, rand));

let t0 = performance.now();
const index = new HNSW(16, 64, rand); // pgvector defaults
for (const v of data) index.insert(v);
const buildS = (performance.now() - t0) / 1000;
console.log(`build: ${buildS.toFixed(1)} s`);
console.log(`top layer: ${index.maxLayer}`);

t0 = performance.now();
const truth = queries.map((q) => bruteForce(data, q, K));
const bfMs = (performance.now() - t0) / Q;
console.log(`brute force: ${bfMs.toFixed(2)} ms/query`);
拿到精确答案后,最后一个代码块会遍历不同的 efSearch 值,并用精确答案评估每种设置的结果。
for (const ef of [10, 40, 100, 200]) {
  const t = performance.now();
  const got = queries.map((q) => index.search(q, K, ef));
  const ms = (performance.now() - t) / Q;
  let hits = 0;
  got.forEach((ids, i) => {
    const want = new Set(truth[i]);
    for (const id of ids) if (want.has(id)) hits++;
  });
  const recall = hits / (Q * K);
  console.log(
    `efSearch=${ef}  recall@10=${recall.toFixed(3)}  ` +
      `${ms.toFixed(3)} ms/query`,
  );
}
用 node hnsw.ts 运行。构建索引是最慢的部分:要执行 50,000 次插入,每次都要用纯 JavaScript 进行一次束搜索,而且没有 SIMD。如果希望第一次运行快一些,可以把 N 降到 10,000。
Recall@10 表示真实的 10 个最近邻中,有多少比例被 HNSW 返回,再对 500 次查询取平均。计时只包住搜索调用,因此计算召回率的辅助操作不会混入每次查询的耗时。
efSearch 就像一个旋钮,让你在找到更多真实近邻和更快返回结果之间调节。
这里不贴结果表,因为值得信任的数字,只有你亲自运行后打印出来的那些。文档能预告的是变化方向。pgvector 表示,更高的 ef_search 会以速度为代价,带来“更好的召回率”;hnswlib 则表示,“更高的 ef 会让搜索更准确,但也更慢”。你自己的运行结果会告诉你,在你的硬件上差别究竟有多大,以及从 40 提高到 100 的收益,是否大于从 100 提高到 200。
随机向量是比较难的情况。均匀随机数据没有簇,其内在维度也接近标称维度。Elliott 和 Clark 在 2024 年的一篇论文中指出,HNSW 的召回率与数据的内在维度、插入顺序有关;Marqo 一篇讨论 HNSW 召回率的文章也提到,聚类数据“往往比均匀分布的数据产生更高的召回率”。真实的文本 embedding 具有结构,因此可以把随机数据上的召回率看作一个偏悲观的下限。试着分别设置 DIM = 16 和 DIM = 256,观察同样的 efSearch 能换来多么不同的召回率。第二种设置要配合更小的 N,因为每次距离计算的成本会变为原来的四倍。
暴力搜索那一行就是你的基线。对于 50,000 个向量,精确扫描的成本并不高;没有索引时,pgvector 做的正是这种扫描,召回率为 100%。随着 N 增大,HNSW 才开始体现价值,因为暴力搜索的成本随语料库规模线性增长,而根据论文,图搜索的成本大致呈对数增长。
过滤条件会让原本就窄的搜索束变得更窄。 pgvector 在索引扫描之后才应用 WHERE 过滤条件。README 明确说明了后果:“如果某个条件匹配 10% 的行,那么在使用 HNSW 和默认的 hnsw.ef_search = 40 时,平均只有 4 行符合条件。”也就是说,一个 top-10 查询最后只返回了 4 行。从 0.8.0 开始,pgvector 提供了迭代式索引扫描,会持续扫描,直到有足够多的行通过过滤条件。
在生产环境中调节这个旋钮。 在 Postgres 中,只需要改一个设置;如果需要,还可以让它只在当前事务中生效:
BEGIN;
SET LOCAL hnsw.ef_search = 100;
SELECT id FROM chunks ORDER BY embedding <=> $1 LIMIT 10;
COMMIT;
在 Qdrant 中,可以为每次搜索传入 "params": { "hnsw_ef": 128 }。其索引文档说明,ef 默认采用 ef_construct 的值,而 ef_construct 的开箱默认值是 100。这两个存储系统也都允许跳过索引,获取精确答案:pgvector 可以在事务内使用 SET LOCAL enable_indexscan = off,它的 README 也建议用这种方式监测召回率;Qdrant 则使用 "exact": true。这条精确搜索路径,就是你在真实数据上建立召回率测试的方法。取几百条真实查询,先获取一次精确的 top-10 结果,再与生产环境设置返回的结果进行比较。
真正的实现还会补上这个单文件版本没有处理的内容:删除与更新、并发插入、基于磁盘页的存储、量化向量,以及 SIMD 距离计算内核。论文还为邻居选择启发式算法提供了两个可选开关:扩展候选集合和保留被裁剪的连接,这个版本都没有开启。如果想看看为什么需要这套启发式算法,可以生成聚类向量来替代 randomUnit,把 selectNeighbors 换成直接截取最近的 M 个候选节点,然后在相同的 efSearch 下比较召回率。
每个 RAG 答案都始于一次检索,而这一步通常是近似搜索,召回率却往往没人记录。系列中的《AI That Reads》讲的就是这一层,使用 TypeScript,涵盖 embedding、向量搜索、分块,以及如何让回答以你自己的文档为依据。书中也会介绍应该养成哪些测量习惯,帮助你判断问题是否出在检索环节。
这是 AI in TypeScript 五本书中的第 2 本。整个系列从第一次调用 LLM 讲到将 Agent 部署到生产环境,五本书均已收录。
如需采取进一步措施,你可以考虑屏蔽此人和/或举报滥用行为。