
8.0
热点
AI SCORE
技术实践2026-10-10 22:03
用 TypeScript 拦住格式正确的错误数据
dev.to · AI#TypeScript#结构化输出#数据校验
Editor brief · 编辑速览
文章以模型生成发票为例,区分 JSON 语法、字段结构和业务语义三层验证。即使类型检查通过,应用仍需依据可信商品目录核对价格、引用唯一性,并重新计算总额。
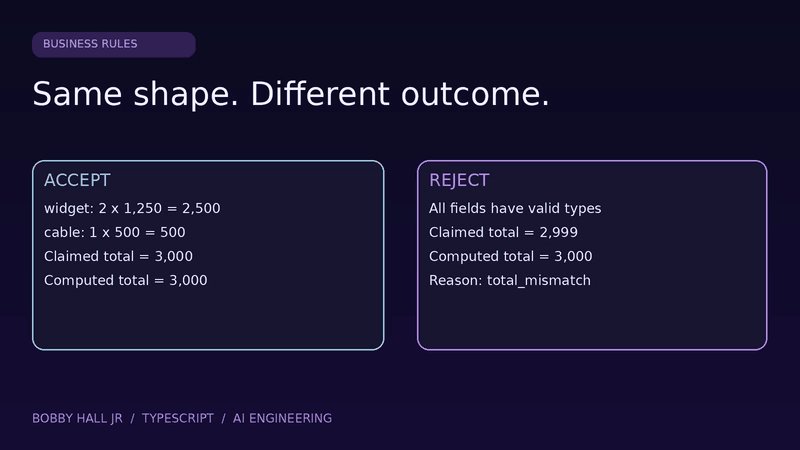
模型返回了一张发票。JSON 能正常解析,每个字段的类型也都正确,但总金额还是错的。
两个单价为 1,250 美分的 widget,加上一根 500 美分的 cable,总金额应该是 3,000 美分。模型却给出了 2,999。结构检查可能会放行这个响应,而你的应用就这样损失了一美分。
这就是今天要构建的边界:只有在应用检查过由它自己掌控的规则之后,才接受结构化数据。
能解析吗?有效的 JSON 只说明语法正确。
结构符合预期吗?允许出现的字段、类型、取值范围和集合大小,都属于结构约束。
它与可信的应用状态一致吗?商品是否属于目录、价格是否为当前价格、商品引用是否唯一,以及重新计算的总金额是否一致,都属于业务不变量。
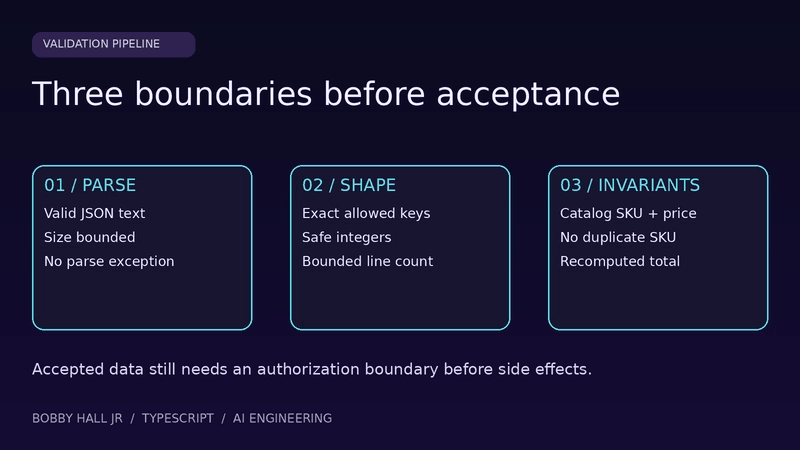
JSON Schema 可以描述数值约束,例如整数类型和最小值,也可以描述对象约束,例如必填属性和额外属性。这些约束很有用。但在这个发票示例中,常规的结构 schema 并不会同时获取你的当前商品目录,也不会计算数量乘以价格之后的总和。
把这些检查放在应用代码里。这里讨论的是本例要实现的边界,并不是说所有 schema 系统的表达能力都受到相同限制。
另外,JSON.parse(raw) as Invoice 不会执行任何运行时校验。TypeScript 会在编译时移除类型断言。应该从 unknown 开始,检查其中的数据,再构造经过校验的数据。
完整的可运行源码、测试样例、图示和确切输出,都放在 GitHub 上的 structured-output-invariants 仓库中。
不需要 API key,也不会调用模型。测试样例中的响应代替不可信的模型输出,让我们能够以确定性的方式测试这些接受规则。
运行前提:Node.js 22 或更高版本、npm,以及首次安装时可用的网络连接。本例已在 Node.js 22.20.0 和 TypeScript 5.9.3 上测试。
git clone https://github.com/bobbyhalljr/structured-output-invariants.git
cd structured-output-invariants
npm ci
npm test
可信的商品目录放在应用代码里:
const catalog = new Map([
  ["widget", 1250],
  ["cable", 500],
]);
模型不能通过在响应里填入一个数字,就重新定义价格。输入校验器要求币种为 USD,根对象和每个明细项的字段必须与规定完全一致,明细项数量为 1 到 100,商品数量必须是正的安全整数,以美分表示的金额必须是非负的安全整数。对于预期之外的字段,它会直接拒绝,避免这些字段悄悄流向未来的下游消费者,并被赋予某种含义。
我们还在解析之前,将输入长度限制为 10,000 个 JavaScript 字符串码元。这只是一个小型的本地防护措施,既不是字节数限制,也不是完整的网络资源策略。
结构检查通过后,每个明细项都要经过语义关卡:
if (seen.has(row.sku))
  return { ok: false, reason: "duplicate_sku" };
seen.add(row.sku);

const price = catalog.get(row.sku);
if (price === undefined)
  return { ok: false, reason: "unknown_sku" };
if (price !== row.unitCents)
  return { ok: false, reason: "price_mismatch" };

const subtotal = row.quantity * price;
if (!Number.isSafeInteger(subtotal) ||
    !Number.isSafeInteger(computed + subtotal))
  return { ok: false, reason: "arithmetic_overflow" };
computed += subtotal;
为什么除了检查输入,还要检查运算结果?因为两个安全整数参与运算,结果仍可能超出 JavaScript 的安全整数范围。这个本地示例会在接受结果之前,检查每一次乘法和每一次累加。
这个仅支持 USD 的示例使用整数美分表示金额。这样,常见的美分金额就不必参与浮点小数运算。但它并没有为所有货币或定价系统定义一种通用的金额格式。
最后一道边界写得很明确:
if (computed !== x.totalCents)
  return { ok: false, reason: "total_mismatch" };

return {
  ok: true,
  value: { currency: "USD", lines, totalCents: computed },
};
成功时,返回由已校验字段构造的新对象。失败时,返回取值范围受限的原因码。这里不会发起付款、发送邮件,也不会写入发票。
npm test 会先编译仓库中提交的 TypeScript,再运行测试用例。在 npm 的命令头信息之后,程序会打印:
valid: accepted
wrong total: total_mismatch
invented SKU: unknown_sku
changed price: price_mismatch
duplicate SKU: duplicate_sku
fractional quantity: line_shape
zero quantity: line_shape
string money: shape
wrong currency: shape
extra root key: shape
extra line key: line_shape
empty lines: shape
unsafe integer: shape
overflow: arithmetic_overflow
null: shape
too many lines: shape
malformed JSON: invalid_json
input limit: input_limit
Checks passed: 18/18
这些是本地测试样例检查,并不是 LLM 的准确率评分。如果任意一次接受结果或拒绝原因与预期不符,测试程序就会抛出异常。
最有价值的用例是总金额错误:对象仍然保留了预期的字段和类型,但语义关卡会拒绝它。虚构 SKU 和修改价格的用例则展示了另一种失败方式:模型输出即使内部自洽,也依然可能与可信状态相矛盾。
这是一篇发票数据教程,并不是生产级计费软件。它不支持税费、折扣、货币兑换、运费、退款,也不支持小数数量。拒绝重复 SKU 是有意做出的简化;真实发票可能允许同一商品分成多个独立明细项。
商品目录是静态的。在生产环境中,要让校验和写入使用同一个一致的目录版本,或将它们放进同一个事务,确保价格不会在检查与提交之间发生变化。读取目录时,要执行租户访问控制。记录策略版本和拒绝原因,但默认不要记录包含敏感信息的模型原始数据。
校验成功并不能证明客户有购买意愿、源文档真实可信、具备购买权限,或已经可以执行产生副作用的操作。要在执行边界增加授权和幂等性控制。
这里没有自动修复循环。如果你要求模型重试,就要限制重试次数,并再次运行同一个校验器。第二次响应仍然是不可信输入。
结构化输出帮助你读取响应。应用的不变量决定这个响应能否用于某项具体任务。
把可信事实放在模型返回的数据之外。重新计算派生值。让拒绝结果可见。然后,为产生副作用的操作单独设置授权边界。
这正是我在构建 Roster 时关注的边界:真正执行工作的 AI 员工,需要由应用掌控的接受规则来约束它们产生的数据。
如果需要采取进一步措施,你可以考虑屏蔽此人和/或举报滥用行为。