
8.0
热点
AI SCORE
编程提效2026-10-10 12:59
用小型本地模型压测桌面编程 Agent
dev.to · AI#编程智能体#本地模型#工具测评
Editor brief · 编辑速览
作者在 Debian、纯 CPU 和 Ollama 的 qwen3:1.7b 环境下,测试 PI-Desktop 的规划、目标及子代理模式。该社区项目仍处早期预览,作者明确将这套配置定位为压力测试,摘录未展示具体故障结论。
开源编程 Agent 引擎 Pi 于 10 月 1 日发布了 1.0。三天后,也就是 10 月 4 日,PI-Desktop 发布 v0.16.1,这是首个基于 Pi 1.0.0 构建的版本。PI-Desktop 为这个引擎提供了桌面 GUI:前端使用 Electron,底层是 Rust 编写的“host core”,Pi 的 Agent 包则运行在一个 Node sidecar 进程中。
先澄清一件事:PI-Desktop 是 vastsa 开发的社区项目,并非 Pi 团队的产品。它采用 LGPL-3.0 许可证,在 GitHub 上有约 6.4k 个 star,README 将 0.16.x 系列称为“Early Preview”(早期预览版)。还有几个项目也叫“pi-desktop”,所以查找时,请从这个项目的仓库和官方文档入手。
我不想写一份功能清单。我想知道,把它安装在一台普通 Linux 机器上,再运行三个让它区别于终端 Agent 的功能——Plan 模式、Goal 模式和 subagent——究竟会发生什么。
我的测试机器没有云端 API key。因此,所有测试都通过 Ollama 使用 qwen3:1.7b 运行,而且只用 CPU:Debian 13、8 个 vCPU,没有 GPU。这个模型处理 prompt 的速度约为 250 tokens/s,生成速度约为 8 tokens/s。
这是压力测试,并不是公平的性能基准测试。1.7B 模型几乎是这个应用可能遇到的最弱配置。有些问题出在模型上,我会明确指出。另一些问题与模型无关,这些发现更有价值。
测试项目是 lukeed/clsx v2.1.1:21 个文件,32 个测试全部通过。项目足够小,小模型也有机会完成任务。
Linux 版提供 AppImage、.deb 和 .rpm,要求 glibc 2.35+,也就是 Ubuntu 22.04+、Debian 12+ 或 Fedora 36+。我使用了 AppImage,但没有挂载,而是直接解包,这样就不需要 libfuse2:
wget https://github.com/vastsa/PI-Desktop/releases/download/v0.16.1/PI-Desktop-0.16.1-linux-x86_64.AppImage
chmod +x PI-Desktop-0.16.1-linux-x86_64.AppImage
./PI-Desktop-0.16.1-linux-x86_64.AppImage --appimage-extract
./squashfs-root/AppRun --no-sandbox
下载:164.8 MB,SHA-512 与 latest-linux.yml 中的值一致。
解包:约 3 秒,占用 414 MB 磁盘空间。根据 ldd 的检查,没有缺失的共享库。
首次启动:冷启动 1.56 秒出现窗口,热启动为 0.54 秒。
内存:Agent 尚未执行任何操作时,Electron、host-core 和 sidecar 进程的 RSS 合计约为 630 MB。
之所以需要 --no-sandbox,只是因为解包后的目录中,chrome-sandbox 没有设置 setuid。通过安装包安装应该不需要这个参数。
安装包内包含 Chromium 150、Rust 编写的 pi-desktop-host-core 二进制程序、Pi sidecar、内置的 models.dev 模型目录,其中收录了 8,344 个模型,以及两个内置插件:浏览器和文件管理器。
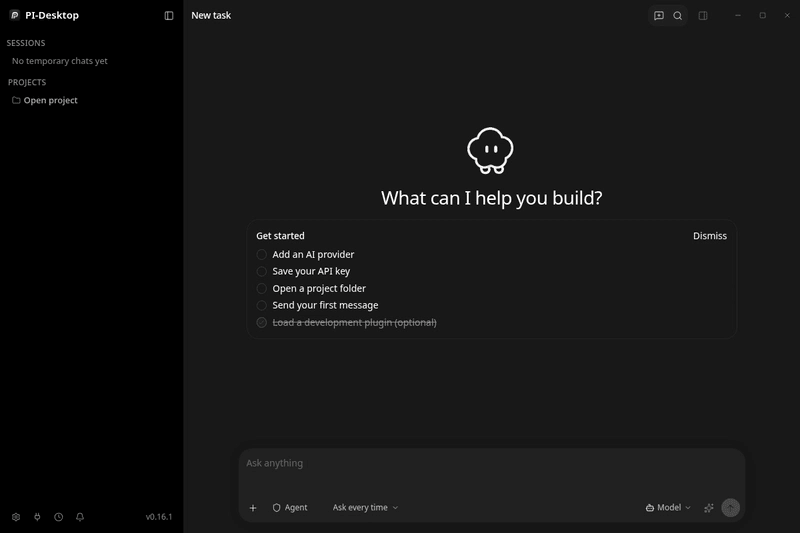
首屏很简洁,显示“What can I help you build?”(我能帮你构建什么?),并附有 Get started 入门清单。输入框里有三个与本次测试密切相关的选项:模式(Agent / Plan / Goal)、权限(Ask every time / accept edits / Auto)和模型。
0.16.1 没有专门的 Ollama 入口。本地模型需要通过 Settings → Agent → Models → Add provider → Custom endpoint 添加,这里接受“任何兼容 OpenAI 或 Anthropic 的 URL”。
Base URL:   http://127.0.0.1:11434/v1
API key:    ollama        (dummy)
API format: OpenAI Chat Completions
点击 Fetch list 后找到了模型,provider 显示“Connected · 1 model found”。provider 列表也很长:既有通过订阅账号登录的选项,如 Claude Pro/Max、ChatGPT、GitHub Copilot、SuperGrok/X Premium 等,也有约 30 家使用 API key 的服务商。
冒烟测试的 prompt 是“Reply with exactly: PI-Desktop smoke test OK”。测试成功了,但耗时 1 分 54 秒,也让我看到了第一个关键数字:
应用的 system prompt 加上工具 schema,总计约 4.1k tokens。Ollama 缓存了 4,717 个 prompt tokens 中的 4,098 个。
仅进行一轮对话后,输入框里的上下文环形指示器就显示 96%。当时我把 Ollama 的上下文设为 16k,而 UI 中这个自定义模型的上下文窗口显示为“— —”。
推理设置在我的 prompt 后追加了 /think,也就是 Qwen 的推理开关,模型又在回答里把它原样输出了出来。
第一个经验:添加本地模型后,打开模型的 Advanced 设置,手动设置 Context Window。如果上下文只有 16k,那么在你输入任何内容之前,Agent 运行框架就已经占掉了四分之一。
我把 clsx 文件夹作为项目打开,将模式切换为 Plan,权限设为“Ask every time”,然后要求它为嵌套数组和 falsy 值规划一个测试。

流程机制很扎实:
计划保存成了真实文件:.pi/plan/add-nested-array-falsy-values-tests-for-clsx-20261007-1108.md,大小为 315 字节。
界面出现了计划卡片,带有 Open plan、Reject 和 Approve (Ask) 按钮,File Manager 面板也随之打开,展示这份 markdown。
对话自动获得了一个合理的标题。
但计划内容就不行了。计划要求在 /work/clsx/tests 中添加测试文件,而这个路径根本不存在。运行日志显示“3 issues · 4 tools”:一次搜索失败,一次读取失败,第一次 SubmitPlan 失败,第二次才成功。应用显示“Processed for 5m 19s”,但从发送 prompt 到看到计划卡片,实际经过了约 17 分钟。上下文指示器停在 95%。
这主要是模型的问题。一个 1.7B 模型,四分之一的上下文被指令占据,很容易编造路径。但围绕它构建的工作流——独立的产物、明确的审批关卡——正是我希望交给更强模型使用的机制。
Goal 模式的设计是:先写入一个 .pi/goal/*.md 文件,记录目标结果和验收标准,等待批准,然后切换到 Agent 模式持续工作,直到能够报告自己验证了哪些标准。
我点击模式选项两次,切换到 Goal。随后发现,旁边的权限选项悄悄从“Ask every time”变成了“Auto”。我并没有动它。这个模式的职责就是自主朝着目标执行,因此权限恰恰是我最不希望它自行放宽的设置。
这次运行并不顺利:
第一次模型调用耗时 4 分 26 秒。
始终没有写出目标文件,也没有写出验收标准。
模型又跑去 /work/tests 里找东西了。
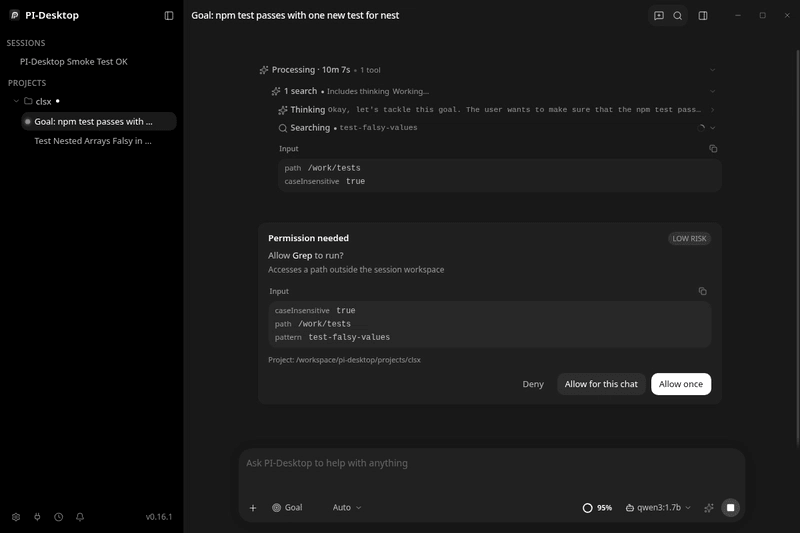
安全机制确实起了作用:即使在 Auto 下,对 /work/tests 执行 Grep 仍然被拦下,提示“Accesses a path outside the session workspace”,风险评级为 LOW RISK。我拒绝了这次操作。随后,模型试图对 /work/tests/new-test.js 执行 Edit,也失败了。约 12 分钟时,我终止了运行,没有任何内容得到验证,对话还被自动重命名成了中文:“新增嵌套假值测试用例”。
运行失败是模型的问题。权限自动切换和中文标题则发生在应用里,值得向维护者反馈。公平地说,文档确实注明,Plan 和 Goal 是“通过约定约束行为的模式,并非严格只读的安全配置”。即便如此,我还是会在每次切换模式后检查权限选项。
PI-Desktop 内置了五个 subagent,每个都有明确的工具集:
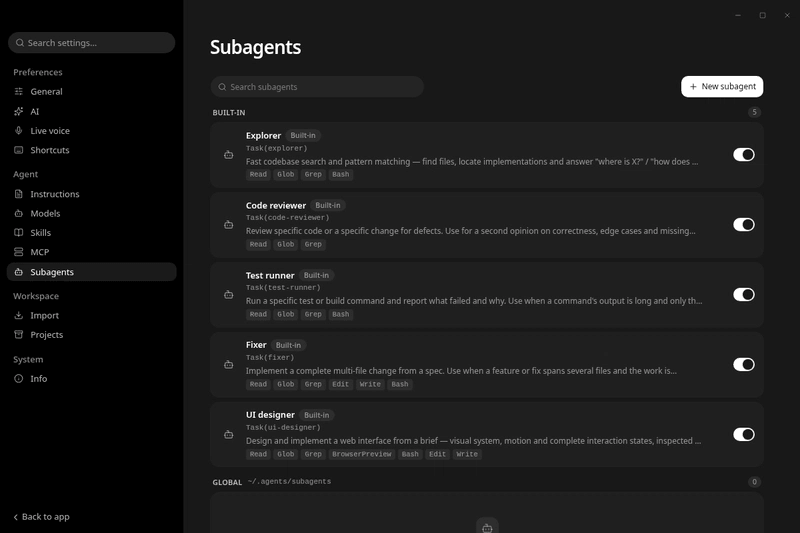
你可以在 ~/.agents/subagents/ 中添加自己的 markdown 文件,最多 16 个。任务委派通过 Task 工具完成,它在后台运行,并返回一个 delegation ID;配套工具还有 TaskWait、TaskList 和 TaskStop,每个会话最多同时运行 10 个委派任务。Subagent 只能在 Agent 模式下使用。
在 Agent 模式中,我提出了请求:“使用 test-runner subagent 运行 npm test,并报告结果。”
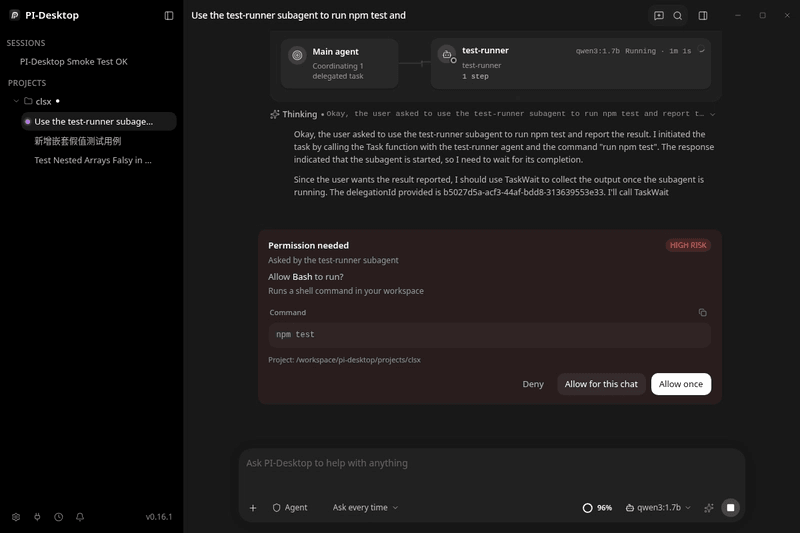
UI 绘制了一张小型委派关系图:Main agent → test-runner,并显示“Coordinating 1 delegated task”。
权限提示明确写着“Asked by the test-runner subagent”,展示了完整命令 npm test,并标记为 HIGH RISK。执行 shell 命令,确实应该提醒用户注意。
点击 Allow once 后,subagent 在 2 分 44 秒内完成任务,共 3 个步骤。整轮对话耗时 5 分 55 秒。
结果为退出码 0,32/32 个测试通过,与我自己在 shell 中运行 npm test 得到的结果一致。
Subagent 自己的对话记录在侧边面板中打开,并标记为只读,提示“Subagents are driven by the main agent”。对话也再次被重命名为中文:“npm测试成功”。
这次的经验是:给小模型一个范围有限、定义清楚的任务,运行框架就能带着它完成。让它规划开放式任务,它就撑不住了。
~/.pi-desktop/secrets/<sha>.bin    48 B   mode 644
~/.pi-desktop/secrets/.machine-key 32 B   mode 600
项目自己的存储规范解释了原因:当前随应用交付的后端是一个 AES-256-GCM 文件存储,使用机器密钥加密,而这份密钥由“host-core 生成一次,并保存在这些文件旁边”。至于操作系统 keychain 后端,“目前 host-core 和 Electron main 都没有实现,因此,以同一用户身份运行、能够读取数据目录的进程,也能解密这些 secret”。规范对此说得很坦诚,宣传文案却没有。如果你要存入真正的云端 key,请把 ~/.pi-desktop 文件夹当作敏感目录处理。
MCP Market:Settings → Agent → MCP 中有一个 Market 标签页,将内置目录与官方 MCP registry 合并展示。列表中有 Memory、Sequential Thinking、Filesystem、Playwright、Context7、Fetch、Git、Time、Serena 等,大多数标记为 Verified,每项都带有对应的 npx/uvx 命令。一些描述显示为中文。截至 v0.16.1,用户自行添加的 MCP server 所提供的工具需要审批。
会话导入:可以导入 Claude Code、Codex、OpenCode 和 Pi 的会话。
定时任务:支持每小时、每天或每周运行,但只有应用保持打开时才会执行。
根据 README,应用没有遥测,也不要求注册账号。
我没有测试这些情况,因此请把下面的内容视为预期,而不是测试结果。如果使用能力足够强的云端模型,并配上较大的上下文窗口,我预计:
4.1k tokens 的 system prompt 将不再构成明显负担。对于 128k+ 的上下文,它只是一个零头,而不是 25%。
Plan 模式会给出真实路径,因为更强的模型会在制定计划前实际读取仓库。
Goal 模式会写出验收标准,并在几分钟内逐项执行,而不是运行到 12 分钟后仍然停滞不前。
每轮对话的总耗时会从分钟级降到秒级。
我不认为会随之改变的是:权限选项自动切换为 Auto、关于 keychain 的措辞、自动生成的中文标题,以及窗口重绘 bug。这些都属于应用自身的问题。
PI-Desktop v0.16.1 几秒就能安装完成,不到两秒就能启动。它的 Plan、Goal 和 subagent 工作流经过了认真设计:独立的产物、审批关卡、清晰的风险标签,以及可见的委派关系图。即使使用在 CPU 上运行的 1.7B 模型,subagent 也完成了自己的任务。
同时,它显然还是一个早期预览版。切换到 Goal 时检查权限选项,暂时不要相信“OS keychain”的说法,并手动设置本地模型的上下文窗口。
如果你用前沿模型运行它,我很想知道 Goal 模式能否顺利完成任务。这是我接下来最想看到的测试。
本文最初发表于 Medium。
如果需要采取进一步措施,可以考虑屏蔽此人,或举报其滥用行为。