
8.0
热点
AI SCORE
编程提效2026-10-10 11:00
单台虚拟机搭建 Claude 多代理工作流
dev.to · AI#Claude Code#多代理#工作流
Editor brief · 编辑速览
作者通过 Telegram 向一个常驻 Claude Code 会话发送任务,再由其分派给八个专业会话执行。文章介绍 Azure 虚拟机上的运行架构、成本与故障经验,覆盖收件箱整理、研究和实验等工作。
过去一周,除了开会,我的大部分工作都通过同一个对话完成。我在 Telegram 上给一个 Claude Code session 发文字或语音消息,它再把工作交给另外八个 Claude session 中的一个,每个 session 都有自己的职责。到了晚上,实验已经完成测量,收件箱已经整理成任务清单,研究笔记也写好了,而我连终端都没打开过。
这听起来比实际情况井然有序。几乎每天,这套系统都会以新的方式出问题,而我对它的大部分认识,都来自这些故障。这篇文章会介绍 Agent 架构、运行成本,以及那些塑造了系统设计的故障,细节会充分到让你能照着搭建自己的版本。
所有东西都运行在一台 Azure VM 上,桌面始终保持登录状态,因为有些工作需要真正的浏览器。上面运行着三类进程:
claude --bg --name <role>),每个都有一份书面职责说明:内容、SEO、视频、收件箱分拣、负责 VM 本身的系统管理员,以及负责产品仓库的工程师。它们是独立进程,而不是 subagent,因此参谋长重启后,它们仍然可以继续运行。claude -p 任务,全程不需要对话。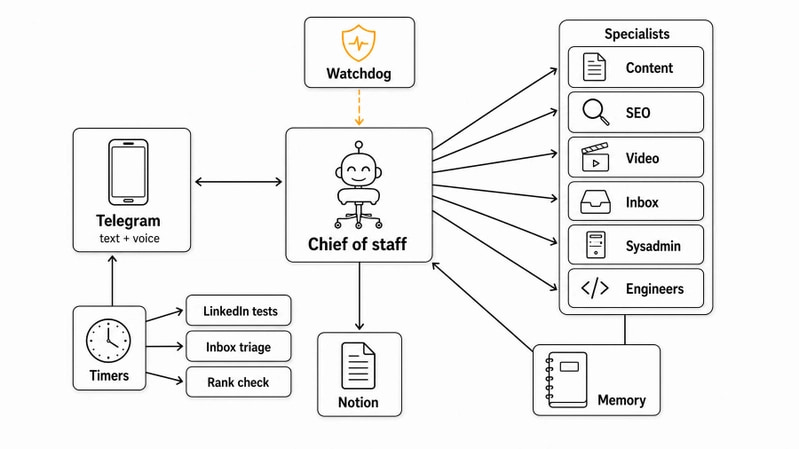
第一个版本允许参谋长顺手处理一些小任务。Claude Code 一次只能处理一个回合,所以它每花一分钟用 grep 搜索日志,我的下一条请求就得在队列里多等一分钟。
于是,这条规则变得非常严格:收到任何任务,它最多只做一次快速读取,判断该交给谁,然后把任务说明发给那位专家,结束自己的回合。如果没有合适的专家,它就启动一个新的。验证也要委派出去:有人声称“完成了”,就要求提供证据,或者让第二位专家检查。
还有一个我没预料到的好处:每位专家的上下文始终围绕自己的领域。内容 session 对内容实验台账了如指掌,却完全不知道数据库迁移的事。这样既能缩短它的回合,也能让错误更容易追溯。
我很少坐在 VM 的终端前,所以任何只出现在终端里的信息,都传不到我这里。Claude Code 的 channels 功能可以把 session 连接到 Telegram bot,这个 bot 就成了系统与我沟通的唯一渠道。
双向语音消息。 收到的语音消息由 Azure 上部署的 speech-to-text 服务转录,参谋长也能以 Telegram 原生语音气泡的形式回复,总成本大约每月一美元。这里有一个坑:Telegram 发来的是 .oga 文件,endpoint 会拒绝这个扩展名,必须先改名为 .ogg。
点一下就能做决定。 需要决策时,系统会发送一个 reply keyboard,把各个选项显示为 Telegram 中的按钮。Inline buttons 看起来更漂亮,但点击事件始终传不到 session,因为插件只转发消息,不转发 callback。
只用一个聊天,长内容放到别处。 每条消息都会注明所属项目,草稿、计划等长内容则放到 Notion 页面里,在聊天中附上链接。我曾短暂尝试过每个项目一个 topic,但对于一个人和一个助手来说,这种组织方式消耗的注意力比节省的还多。
Telegram 的每个 bot token 只允许有一个 poller。Claude Code 插件为了执行这一限制,会在新 poller 启动时杀掉已有的 poller。对于只有一个 session 的情况,这很合理;对于运行着九个 session 的机器,这就很危险了。头两天,Telegram 桥接服务以四种方式掉过线:
claude mcp list 会启动每个 MCP server 来检查状态,这就启动了第二个 poller。它杀掉正在运行的 poller,然后自己退出,最终一个 poller 都没剩下。Watchdog 是一个 systemd 定时器,每两分钟运行一次简短的 shell 脚本:每次正常检查消耗 30 到 40 毫秒的 CPU 时间,以及大约 5 MB 内存。它会检查 poller 是否存活、是否从插件目录运行,以及它的祖先进程是否是参谋长 session。最后这项检查来自第一种故障:连续三次检查,poller 都存活且健康,却属于错误的 session。“存在一个 poller”和“我的 session 拥有这个 poller”是两个不同的健康信号,只有后者才能告诉你,消息是否会传到你这里。
连续两次检查失败后,Watchdog 就会重启参谋长,并通过锁和冷却时间控制重启。重启本身也有一个坑:claude --bg --resume <session-id> 只有在不带任何其他 flag 时,才会原地唤醒那个 session。只要传入任何 flag,哪怕是最初使用的那些,你得到的都会是一个副本:新的 id,没有名称,也没有 Telegram channel。
每个循环都分两个阶段运行。第一阶段只用普通 bash,不调用模型:检查是否有到期任务,收集输入,如果没有事情要做就退出。只有完成这一步,runner 才会启动 claude -p,使用更便宜的模型,并把收集好的输入直接放进 prompt。
我们反复学到的教训是:凡是确定性的事情,都应该写进脚本,而不是写进模型指令。
sleep,所以等待逻辑要放在 helper 里。每个 session 都会读取一个共享的 Markdown 文件目录。每个文件保存一条事实,包含名称、一行描述和类型,再通过 [[name]] 链接成一个小型图谱。每条记忆占一行的索引,会在每个 session 启动时加载。
两条规则防止记忆逐渐失效:专家可以纠正自己领域内的事实,但必须说明;任何人删除记忆,都必须得到参谋长同意,因为一条看起来过时的记忆,往往是某条规则为何存在的唯一记录。薄弱环节是决策日志:五天内,它就增长到 188 KB,而且每次 session 启动都会重新读取。现在,它被拆成了一个简短的当前待处理队列和一个归档。
刚开始时,有一天 Anthropic dashboard 显示花费大约 195 美元,我却不知道原因。审计发现,88% 的支出都花在模型重新读取自身上下文上:48% 是 cache reads,40% 是 cache writes,输出占比不到 12%。参谋长每个回合都在重新读取大约 440,000 tokens,因为在 1M-token 窗口下,auto-compaction 从未触发。
真正有帮助的是控制上下文和回合数,而不是精巧的 prompt。换成标准窗口后,参谋长每回合的成本从大约 28 美分降到了 13 美分。它运行在 Claude Opus 5.5 上,我又手动把它的上下文窗口限制为 256,000 tokens,让 auto-compaction 提前触发,从而降低每回合成本,保持对话响应及时。专家也运行在 Claude Opus 5.5 上,定时任务则使用 Claude Sonnet 5.5,每回合只花几美分,没有任何任务使用 Fable。另外,每个任务都要一次性提供完整说明,因为在我们测量过的因素中,成本与回合数的关联最紧密。即便如此,它仍然不便宜:清闲时每天大约花 30 美元,集中构建时每天大约花 200 美元。
这套系统中的大多数 bug 都是悄无声息地失败:日志干干净净,exit code 为 0,但什么也没发生。
过时的 checkout。 定时器运行的是各个仓库主 checkout 中的脚本,而专家在独立的 git worktree 中工作。有一天,五个修复已经推送,却整整五个小时都没有运行,因为没人对主 checkout 执行 fast-forward。现在,每份报告都会明确说明主 checkout 与远端一致。
读起来没问题的规则。 一个循环上线前,我们拿真实数据模拟了它第一天的每一次定时器触发,发现了四个 bug,其中一个是这个循环永远无法获取的锁。它们在纸面上都看不出问题,运行时却都会以 0 退出。
只是在确认,而没有真正测试的检查。 用 grep 在日志中搜索你预期会出现的行,只是在确认自己的预期,并没有测试代码。
算不上测试的测试。 有一次 dry run 给我发来了真实通知,因为被 stub 掉的只有模型调用。现在,runner 都有一个开关,可以关闭所有旁路输出渠道。
这些做法背后是同一个习惯:规则没有在真实状态下运行过,我们就不信任它;结果没有落到磁盘上,我们就不信任报告。
市面上有不错的现成选择:xAI 的 Grok Bot、Meta 的 Muse、OpenAI 的 Codex、Anthropic 的 Claude Cowork,以及它们各自的开源替代方案。但每一个都在某些方面限制了我。
我想要的是一套完全围绕我的工作方式搭建的系统。自己构建,可以让我吸收各个工具最好的部分,也能在需要时随时调整配置,而不必更换服务商。
这还不是最终版本,我很期待接下来会给自己的个人助手加入什么。
如果你也搭建了自己的助手,第一件事会把它接到哪里?
本文最初发表于 nulltensor.com。
如需采取进一步措施,可以考虑屏蔽此人和/或举报滥用行为。