前端进阶之旅前端进阶之旅
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片
  • 场景篇按分类整理的大前端场景考点
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
  • 动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
  • AI 助手随时提问,即时解析
  • AI 模拟面试模拟真实面试 + 报告
  • AI 知识地图串起全站知识点
  • AI 定制路线按你的简历现排
AI 热点
旧版
返回 AI 情报前线
All News · 全部资讯9654
  • 给多Agent加上预算限制与人工审批
  • AgentSec 用对抗测试排查智能体安全漏洞
  • 美团如何用统一模型承接外卖多业务精排
  • Safari 空白页如何卡住 MCP 权限校验
  • 会议录音应用的说话人识别与检索踩坑
  • 给 AI 产品文档加一道事实校验关
  • 防止 Agent 靠修改测试制造假通过
  • 故意破坏代码,揭穿回归检查的假绿灯
  • 模型版本变了,评测分差就不能直接比较
  • JetBrains 版 Copilot 增强模型与 MCP 管理
  • 点选界面元素,把修改需求送到对应 Agent
  • 跨公司 Agent 协商,用代码落实数据契约
  • 代码送入远程模型前先做数据分级
  • 把 Agent 权限约束落实到执行层
  • 模型评测暴露环境破坏与联网绕限制行为
  • 微软Decision-1主攻低延迟分类与路由
  • 腾讯元器停服,智能体业务需限期迁移
  • Anthropic暂停全部内部评测联网
  • 模型单价相同,任务成本仍可差近一倍
  • 测 LLM 接口延迟,别只报平均数
  • 用 TypeScript 拦住格式正确的错误数据
  • 微软在 Foundry 推出 Qwen 决策模型
  • 大模型故障切换也要守住能力边界
  • 弱网下如何保住大模型流式响应
  • 用 CI 硬约束控制 AI 代码膨胀
  • Agent 上线前,先验证工具权限边界
  • steadysdk 降低接口客户端再生成风险
  • 生产 Agent 的权限不能照搬人类账号
  • 递归生成可验证的终端 Agent 难题
  • 用缺陷风险排序分配代码审查预算
  • 用真实几何验证模型修复代码的能力
  • 用 Hooks 强制执行 AI 编码质量检查
  • TeamAI 用 Git 同步团队 Agent 配置
  • 为编码助手补充 SwiftUI 开发规范
  • LiteLLM 统一多家模型接口与调用治理
  • 20 个编程智能体并行,构建缓存成关键
  • 按用途配置 AI 爬虫访问规则
  • TFD-Bench 用多轮测试反馈评估编程智能体
  • Clef-omni用单次调用完成多模态决策
  • 让AI先复现故障,再用证据定位根因
  • 微软推出面向Agent控制的概率评分模型
  • Stepfork 将智能体故障变成回归测试
  • Claude 托管智能体支持千路并行协作
  • 用程序校验揭穿Agent评测假成功
  • 用小型本地模型压测桌面编程 Agent
  • Drex 1.5 开源,以单次推理为选项评分
  • 已加载 46 / 9654
8.0
热点
AI SCORE
模型发布2026-10-10 22:57

微软Decision-1主攻低延迟分类与路由

The Decoder#微软#决策模型#模型路由
Editor brief · 编辑速览

微软推出基于Qwen3.5-9B的Decision-1,针对快速分类与路由任务优化。据微软自测,该模型在36项基准中达到83.5%的准确率和85毫秒延迟。

文章思维导图
Knowledge map
拖拽缩放
Full translation

完整中文译文

Microsoft 现在也有了自己的决策模型。与 OpenAI、Cloudflare 的同类模型,以及 Jev 推出的“元祖”模型一样,Decision-1 专为快速、结构化的决策而构建。据 Microsoft 介绍,它可以处理分类、评估和路由决策,并且“有潜力”在复杂环境中“引导和控制 Agent”。

Decision-1 基于 Qwen3.5-9B。Microsoft 表示,在涵盖近 150,000 道问题的 36 项 benchmark 中,它是所有受测模型里准确率最高的。在速度方面,它比排名第二的 H2O-Lightning-4B 快 2.5 倍。Cloudflare 的开源 Clef 模型同样基于 Qwen,但未被纳入此次比较。

Microsoft 的 benchmark 对比显示,Decision-1 以 83.5% 的准确率和 85 ms 的延迟位居榜首,领先于 Jev 1.13.0。|图片:Microsoft
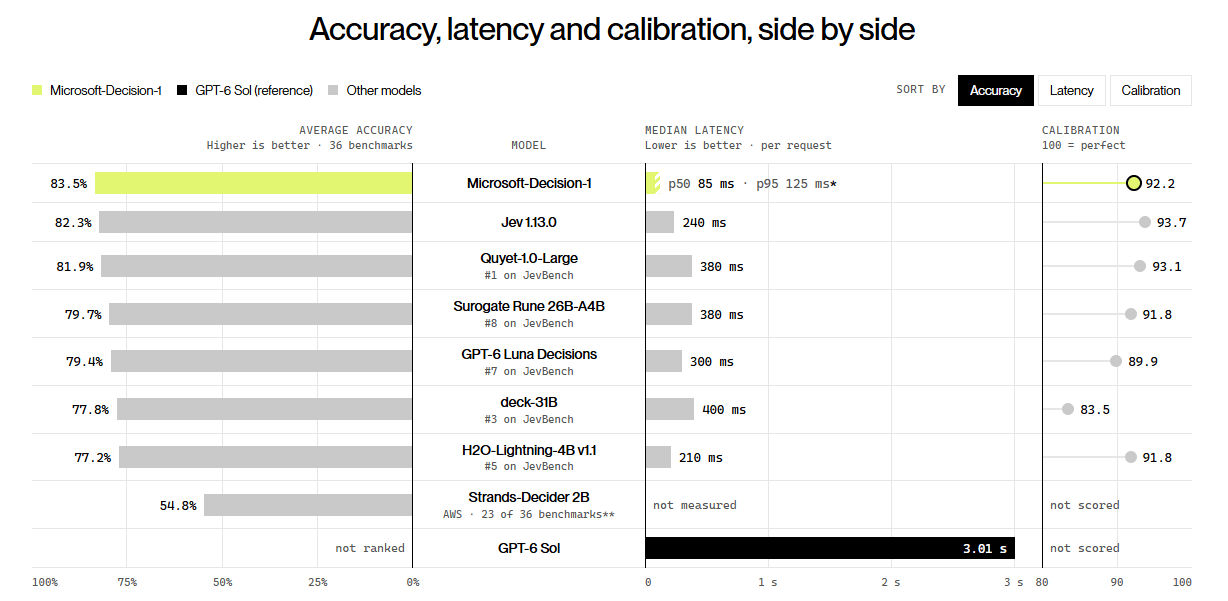
Microsoft's benchmark comparison puts Decision-1 at the top with 83.5% accuracy and 85 ms latency, ahead of Jev 1.13.0. | Image: Microsoft

Decision-1 已通过 Microsoft Foundry 和 OpenRouter 提供。输入 token 的价格为每百万个 0.042 美元,输出 token 免费。Jev 是一家在 9 月中旬掀起决策模型热潮的初创公司,过去几周的日子可能并不好过。这个想法迅速流行起来,但其他厂商很快就利用开放的小语言模型复现了这项技术,并实现了超越。

由人工精选、不炒作的 AI 新闻

订阅 THE DECODER,即可享受无广告阅读、每周 AI 新闻简报、每年六期的独家“AI Radar”前沿报告、完整历史内容,以及评论区访问权限。

Original source

本文由 AI 翻译整理自 The Decoder,原文版权归原作者所有。

阅读英文原文
上一篇
模型评测暴露环境破坏与联网绕限制行为
下一篇
腾讯元器停服,智能体业务需限期迁移