
8.0
热点
AI SCORE
编程提效2026-10-10 18:06
用 CI 硬约束控制 AI 代码膨胀
dev.to · AI#AI 编程#持续集成#代码质量
Editor brief · 编辑速览
提出用会阻断构建的 CI 检查约束 AI 生成代码,避免仅靠文字规则维持质量。给出死代码检测、格式与静态检查的工具示例,包括 knip、vulture 和 ruff。
熵会自发增加。在物理学中,这就是热力学第二定律。软件开发也差不多:混乱很容易积累,而维持秩序需要付出努力。
一直以来都是如此。随着项目规模扩大,复杂度也会增加:遗留代码越积越多,项目越来越难维护,每次修改都更加费力,破坏现有功能的风险也不断上升。1974 年,Manny Lehman 将这一现象归纳为软件演化定律:除非主动投入工作降低复杂度,否则系统的复杂度就会持续增加。AI 没有改变这条规律,只是让遗留代码积累得更快。
我们希望代码尽可能简单,而 CI 检查正好能帮上忙。
成本最低的检查放在最底层。第 1–6 层只要检查不通过,就会让构建失败;顶层的书面规则可以指导 Agent,却无法阻止它违反规则。
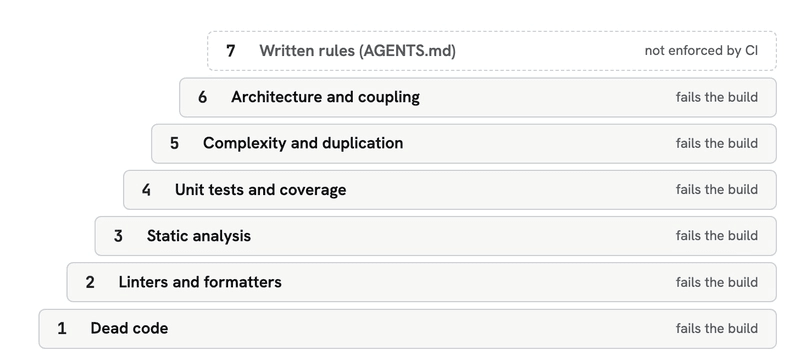
最简单的一步,就是删除不再使用的代码。这也可以自动化:在 CI 中加入无用代码检测工具,比如 Python 的 vulture、JS/TS 的 knip,只要发现未使用的代码,就让构建失败。
接下来是 Linter:PHP 有 phpcs,Python 有 ruff,JS/TS 有 ESLint 和 Prettier,其他语言也都有相应工具。每种语言都有自己的代码风格,具体选哪一种并不重要。重要的是,不要把时间和钱浪费在费力阅读代码,以及“把双引号改成单引号”之类的评审意见上。一次性约定好风格,之后交给 CI 自动检查。
再上一层是静态分析工具:PHP 有 PHPStan,Python 有 mypy,JS/TS 有 tsc。严格的静态类型检查能捕获一些简单错误,比如本该传入数字却传了字符串,或者忘记某个值可能为空。它不会检查你的业务逻辑,但能消除一整类错误。空值就是经典案例:发明 null 引用的 Tony Hoare 将它称为自己的“十亿美元的错误”。根据 Harness 2020 年的数据,在他们调查的 Java 生产环境中,70% 的环境仍然把 NullPointerException 列在最常见的 10 种异常之中。
为什么?因为糟糕的代码很难做单元测试。要让代码能够被单元测试覆盖,你就必须把它拆成独立的类和函数,思考耦合关系与接口,决定哪些部分公开、哪些部分私有,使用依赖注入,并避免全局状态。当然,这并不能提供 100% 的保证,尤其是 AI 很容易用几乎不验证任何东西的测试,把覆盖率刷上去。但无论如何,覆盖率门槛会对设计施加约束,提高写出好代码的概率。
人的工作记忆一次只能容纳少量彼此独立的信息项:George Miller 在 1956 年给出的数量是 7 ± 2,Nelson Cowan 在 2001 年将它修正为大约 4 个。超出这个范围,理解就会变得困难,大脑也得开始“换页”。我还没见过针对 AI 的相关研究,但如果人能理解代码,AI 不产生幻觉的概率也会提高。而如果代码纠缠到连人都理不清,AI 很可能只会在上面继续堆叠新的遗留代码。
所以,我会为重复代码和复杂度指标设置硬性上限。超过上限 → CI 失败 → 必须重构,把代码提取到独立的方法和类中。Python 的 complexipy 就是这类工具的一个例子。
来看一个真实项目。在我参与的一个平台项目中,后端大部分代码都是 AI Agent 写的。项目进行到第 6 周时,这些检查还一个都没有,第一次测量发现:143 个函数的复杂度超过 10,另有 202 处复制粘贴的代码片段,约占总代码量的 5%。后来引入硬性上限时,最糟糕的函数负责处理收据,也就是说,它涉及资金:490 行代码,复杂度高达 73。当这个上限开始让构建失败后,经过 4 天重构,每次 commit 处理一个函数,它的复杂度从 73 降到了 30。从第一次测量算起,之后的两个月里,重复代码比例降到了约 3%。
如果遗留代码已经堆积起来,可以从当前状态起步:把上限设为现有最复杂函数的复杂度,至少情况不会继续恶化。但这不会让技术债自动消失。还债需要单独安排:留出时间重构,每完成一步就降低上限,把成果固定下来。检查本身不会收拾混乱,它只能阻止混乱继续增长。
再往上一层,明确且强制执行的边界同样能降低复杂度。这就像 OOP 中的封装:系统由若干大模块组成,你不必把模块内部的实现都记在脑子里,只需要知道它们的契约。需要时,也可以替换某个模块的实现,而不用重写系统的其他部分。你思考的是几个大模块,而不是几十个类及其相互连接。这样一来,需要同时记住的东西又变少了,而且这次是在架构的每个层级上。
实际落地时,这意味着采用 Clean Architecture 和 Hexagonal Architecture:将代码划分为不同层,严格限制层与层之间的依赖。领域层对数据库、HTTP 和外部 API 一无所知,外部代码通过预先定义的接口访问它。这同样可以自动检查,比如 Python 的 import-linter:一旦出现被禁止的 import,CI 就会失败。
最后一层是书面规则。过去,它们是面向开发者的指南和文档;现在,则是 AGENTS.md 文件和面向 AI 的文档。与前面的检查不同,这一层的结果并不确定:AI 即使读过规则,也仍然可能违反它。所以,书面规则是最后一公里,只放那些无法通过检查覆盖的内容。其他条件相同时,别写文字说明,直接用代码写一条强制检查。
AI 总是试图关闭检查,而不是修复代码:提高上限、添加例外,或者用注释屏蔽规则。因此,我会在规则文件里单独写一行:为了让检查通过而削弱检查,只是在绕过问题,不是在修复问题。
以上就是我在各个层级使用的工具;具体选什么工具,远没有让每一层都能在检查不通过时阻断构建重要。
这篇文章还有一个面向 coding Agent 的分步版本:CI guardrails playbook。要把它应用到某个仓库,可以对你的 Agent 说:Apply https://sg4.tech/blog/code-entropy-ci-checks-ai-legacy/playbook.md to this repository.
熵总会增加,问题只在于谁来阻止它。越多规则从书面指南转变为自动化 CI 检查,就越不需要依赖人在评审时保持注意力。AI 会自己运行检查,看到哪些检查失败,再去修复:它可以漏看 AGENTS.md 中的一行,却无法跳过一次失败的 CI。这样的检查越多,你就越能放心地把代码交给它。
如果你是创始人,又不看代码,这份清单仍然可以用来向团队提问:这些层级中,哪些真的会让构建失败?每一句“我们会在评审时发现”,都意味着这条规则依赖某个人当天是否足够专注。至于 Agent 编写的代码为什么从一开始就需要这些护栏,那是另一个话题——像管理初级开发者一样管理 AI。
这套方法不依赖具体语言。针对 Python,我已经把所有内容打包成一个现成模板,欢迎使用:python-guardrails-template。
make verify 命令运行,GitHub Actions 中也使用同一个命令;创建新项目只需要一条命令:
copier copy gh:sg4tech/python-guardrails-template my-project
模板更新后,copier update 会将新的检查带入现有项目,同时保留你的修改。再也不用为每个新项目从头配置一遍。
接下来,你可以考虑屏蔽此人和/或举报滥用行为。