
8.0
热点
AI SCORE
模型发布2026-09-22 02:30
xAI Grok 4.6 登陆 Amazon Bedrock
AWS ML Blog#xAI#Grok#AWS
Editor brief · 编辑速览
xAI 的 Grok 4.6 已在 AWS Bedrock 上线,支持 50 万 token 上下文窗口和四级推理强度,适用于长时 Agent 和代码任务。
今天,我们宣布 xAI 的 Grok 4.6 已登陆 Amazon Bedrock,将一款面向长时间运行的 AI 智能体、编码和知识工作的前沿模型纳入 Bedrock 模型目录。Grok 4.6 于 2026 年 8 月 18 日在 Bedrock 上线。它提供 500K token 的上下文窗口,并支持在四个级别上配置推理努力(reasoning effort):低(low)、中(medium)、高(high)和超高(xhigh)。
这是 xAI 在 Amazon Bedrock 上的第二个模型。当 Grok 4.3 正式发布时,xAI 作为模型提供商加入了 Amazon Bedrock,并通过 Bedrock Mantle(Amazon Bedrock 中兼容 OpenAI 的推理引擎)访问该模型。Grok 4.6 大大扩展了覆盖范围:可通过 bedrock-mantle 和 bedrock-runtime 两个端点访问,并支持 Converse API 以及 Chat Completions 和 Responses。
本文涵盖 xAI 声称 Grok 4.6 的设计目标、在 Amazon Bedrock 上的打包方式,以及如何发送你的第一个请求。
本节的能力和训练细节来自 xAI 的发布公告Introducing Grok 4.6。
Grok 4.6 在 Grok 4.5 的基础上进行了针对性升级,重点关注长时间运行的 AI 智能体以及更具挑战性的交互和视觉工作。xAI 将该模型描述为能够在复杂任务中持续跟进多个步骤,无论是研究某个主题、分析信息、在代码库中工作,还是将一个想法转化为成熟的应用程序或工作成果。
在训练方面,xAI 报告称进行了比 Grok 4.5 更长的补充训练运行,使用精心筛选的模型生成数据进行推理和高级技术概念学习、高质量工程数据,以及改进的优化器和训练配方。随后使用 Grok 4.5 重新生成了跨推理努力、AI 智能体测试工具(agent harnesses)以及 STEM、软件工程和知识工作等领域的监督微调轨迹,并使用基于模型的检查过滤掉了有问题的轨迹。该模型随后在一系列广泛的 AI 智能体强化学习任务上进行了训练,涵盖知识工作、一般编码以及特定领域环境(如内核优化、Web 开发和计算机辅助设计)。
xAI 特别提到的两个行为值得所有构建 AI 智能体的开发者注意。在更长的执行轨迹上,模型开始表现出更多的自测和验证行为,在继续下一步之前检查自己的工作。它还能在视觉和交互项目上产生更强力的第一版本,在一次传递中建立应用程序的结构和视觉语言,团队发现当通往好结果的最快路径是从一个实质性的起点开始然后迭代时,这种能力非常有用。
在安全方面,xAI 表示 Grok 4.6 的护栏已根据模型的能力进行了改进和校准,并有据称是有史以来最广泛的部署前能力和护栏校准测试套件,以及部署后和第三方测试支撑。该公司将其安全栈定位为在漏洞修补、加速工程设计周期和增强 AI 研究等合法用例领域中最大化实用性和安全性。
xAI 报告称,Grok 4.6 在多个 AI 智能体编码和知识工作基准测试中达到了前沿智能水平。以下是 2026 年 8 月 12 日发布时公布的 Grok 4.6 High 数值:
来源:xAI,内容详见 https://x.ai/news/grok-4-6。
其中几项评估来自 Artificial Analysis,因此了解它们测量的内容有所帮助。根据 Artificial Analysis 的说明,Artificial Analysis Intelligence Index v4.1.1 是一个综合指标,纳入了九项评估:GDPval-AA v2、τ³-Banking、Terminal-Bench v2.1、SciCode、Humanity's Last Exam、GPQA Diamond、CritPt、AA-Omniscience 和 AA-LCR。这些涵盖了 AI 智能体工具使用、推理和知识、知识可靠性、长上下文推理,以及在电子表格和文档上的定量分析。AA-Briefcase 是其 AI 智能体知识工作基准,其中 AA-Briefcase Elo 聚合了 rubric 通过率、分析质量 Elo 和呈现 Elo,分数越高越好。
Artificial Analysis 还跟踪成本和延迟以及智能水平。其每任务成本指标是每个 Intelligence Index 任务的加权平均成本,由输入、缓存命中、缓存写入、推理和回答 token 价格计算得出,如果你正在评估推理密集型的 AI 智能体工作负载(其中推理 token 是一笔真实可见的费用),这是一个有用的视角。
有几个 Bedrock 能力是针对此模型新增的,而非从之前的 Grok 版本继承而来。
bedrock-runtime 端点。 Grok 4.6 除了 bedrock-mantle 之外还在 bedrock-runtime 上提供服务,因此你可以使用 AWS SDK 和标准 Bedrock 控制平面来访问它,而不仅仅是通过 OpenAI 兼容客户端。
Converse API,包括流式响应。 converse 和 converse_stream 均可用。这是 runtime 支持的实际回报:跨模型统一的消息格式,通过通常的 Converse 事件(messageStart、contentBlockDelta、contentBlockStop、messageStop、metadata)进行流式传输,无需手写 server-sent events(SSE)解析。
超高级(xhigh)推理努力级别。 努力级别分为低、中、高、超高,在需要更深层次推理的问题上扩展了范围上限。在 Converse 上,通过 additionalModelRequestFields={"reasoning_effort": "xhigh"} 来设置,而非 reasoning 参数。
跨区域推理。 在 bedrock-runtime 上,你通过两个推理配置文件之一路由,而非固定到单个区域。us.xai.grok-4.6 在你有数据驻留要求时将流量保留在美国地理范围内,而 global.xai.grok-4.6 在全球范围内路由,以获得最广泛的容量池。Global 版本也更便宜,每百万输入 token 2.00 美元对比 2.20 美元,因此如果没有驻留限制,它通常是更好的默认选择。
Amazon Bedrock Guardrails。 Grok 4.6 现在支持在其 API 上的 bedrock-runtime 护栏,为你提供内容过滤器、拒绝话题、个人身份信息(PII)脱敏和词汇策略。你通过请求中的护栏 ID 和版本附加护栏,策略会针对提示和模型的响应进行评估。对于 AI 智能体工作负载来说这很重要,因为它为可能在多个步骤中无人值守运行的模型设置了一致的策略边界。
调用日志记录。 启用模型调用日志记录后,Grok 4.6 调用会被捕获为完整的 Amazon CloudWatch 记录:请求体、响应体、token 计数(包括推理 token)以及使用的推理配置文件。对于需要查看模型实际被问了什么的 AI 智能体运行审计很有用。
提示缓存。 缓存的输入按标准输入费率的大约四分之一计费,这对于每个回合都重新发送大型系统提示或文档的 AI 智能体来说很重要。缓存适用于重复的前缀,因此将稳定内容保持在请求的前面,并在 usage 块中读取缓存的 token 计数以确认折扣已生效,然后才能将其纳入成本模型。
工具调用、结构化输出、图像输入、响应流式传输和加密推理内容也可使用,但这些是自 Grok 4.3 发布以来就有的功能,在那篇文章中有介绍。
Grok 4.6 接受文本和图像输入并返回文本。不支持音频、语音、视频和 embedding 模态,也不生成图像。该模型可通过两个端点访问,使用的模型 ID 因端点而异:
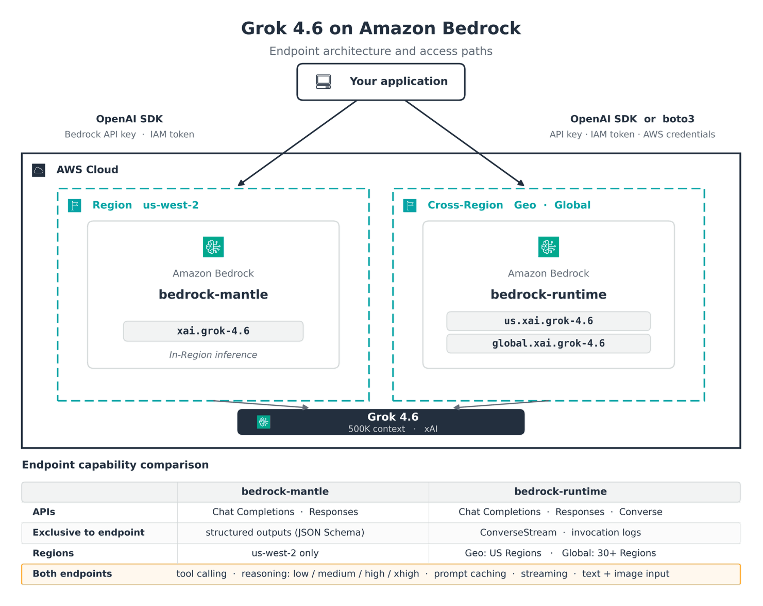
在 API 方面,Grok 4.6 支持 Responses API、Chat Completions API 和 Converse API。不支持 Invoke API。
功能支持因端点而异,这是最有可能影响你集成选择的细节:
在 bedrock-mantle 上,支持的功能包括客户端工具调用、推理、结构化输出、提示缓存、响应流式传输、项目和滥用检测。
在 bedrock-runtime 上,支持的功能包括推理、提示缓存、响应流式传输、调用日志和项目(仅默认项目)。该端点不支持结构化输出、服务端工具使用、智能提示路由、token 计数和应用程序推理配置文件。
工具调用在两个端点上都能工作。模型返回结构化的函数请求,你的代码执行它,然后将结果传回。在 bedrock-runtime 上,你可以通过 Converse 的 toolConfig 或 OpenAI 兼容的 tools 参数来驱动这个循环,因此依赖函数调用的 AI 智能体并不局限于 bedrock-mantle。
如果你的应用依赖 JSON Schema 结构化输出,那应该选择 bedrock-mantle。如果你需要 Converse API 或调用日志,则应该选择 bedrock-runtime。
区域和推理选项
可用性因端点而异。在 bedrock-mantle 上,Grok 4.6 可在美国西部(俄勒冈)(us-west-2)进行区域内推理。在 bedrock-runtime 上,不提供区域内推理。相反,你需要通过跨区域推理配置文件来调用模型。地理跨区域推理可从美国区域(us-east-1、us-east-2、us-west-1 和 us-west-2)使用,全球跨区域推理可从涵盖美国、加拿大、欧洲、亚太地区、中东、非洲和南美洲的更长列表中使用。地理跨区域在地理区域内跨区域路由,同时遵守数据驻留规定,全球跨区域在无驻留限制时可在全球任何地方路由。完整列表涉及超过 30 个区域,因此在固定某个区域之前,请查看模型卡片和按模型列出的区域可用性页面。
这是相对于 Grok 4.3 发布时的一个形态变化,正如 Grok 4.3 文章中所述,该模型仅使用区域内推理,未提供地理和全球跨区域推理。
服务层级和定价
Grok 4.6 支持三个服务层级。Standard 为按 token 付费,无承诺,通过设置 "service_tier": "default" 或省略该字段来选择。Priority 以溢价提供更快、优先的处理("service_tier": "priority")。Flex 以更低成本访问非时间敏感的工作("service_tier": "flex")。各层级的按 token 定价请参阅 Amazon Bedrock 定价页面。
其他两个层级以 Standard 费率为倍数定价:Priority 为 1.75 倍,即溢价 75%;Flex 为 0.5 倍,即折扣 50%。因此,在 Standard 区域内每百万输入 token 花费 $2.20 的相同工作负载,在 Priority 上运行需 $3.85,在 Flex 上运行需 $1.10,这使得层级选择成为比区域选择更大的成本杠杆。
供参考,xAI 列出的 Grok 4.6 定价为每百万输入 token $2 起,每百万输出 token $6 起,快速变体价格为两倍。请始终在 Amazon Bedrock 定价页面上确认当前费率,因为价格和层级可能会发生变化。
发送你的第一个请求
在首次调用之前,请在 Bedrock 控制台中确认该模型在你计划使用的区域中可用。Grok 4.6 通过推理配置文件而非裸模型 ID 的按需吞吐量来提供服务,这就是为什么在 bedrock-runtime 上的请求使用 us.xai.grok-4.6 或 global.xai.grok-4.6 来命名。
Grok 4.6 使用 OpenAI 兼容 API,因此设置 base URL 后,OpenAI SDK 可用于任一端点。安装 SDK,如果你计划使用 Converse API,还要安装 boto3:
pip install openai
pip install boto3
从 Amazon Bedrock 控制台生成长期的 Amazon Bedrock API 密钥用于探索,然后设置你的环境。对于 bedrock-mantle:
export OPENAI_API_KEY="<provide your Bedrock API key>"
export OPENAI_BASE_URL="https://bedrock-mantle.us-west-2.api.aws/openai/v1"
对于 bedrock-runtime:
export OPENAI_API_KEY="<provide your Bedrock API key>"
export OPENAI_BASE_URL="https://bedrock-runtime.us-east-1.amazonaws.com/openai/v1"
在 bedrock-mantle 上使用 Chat Completions API 的第一个请求:
from openai import OpenAI

client = OpenAI()

response = client.chat.completions.create(
    model="xai.grok-4.6",
    messages=[
        {"role": "user", "content": "Can you explain the features of Amazon Bedrock?"}
    ],
)
print(response)
在 bedrock-runtime 上的区别在于模型名称:你传递一个跨区域推理配置文件,而不是裸模型 ID。这个示例还切换到 Responses API 来展示该形态:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="us.xai.grok-4.6",
    input="Can you explain the features of Amazon Bedrock?",
)
print(response)
以及通过 boto3 的 Converse API。因为推理是活跃的,第一个内容块包含推理内容,答案位于后面的块中,所以需要搜索块中的文本而不是索引 content[0]:
import boto3

client = boto3.client("bedrock-runtime", region_name="us-east-1")

response = client.converse(
    modelId="us.xai.grok-4.6",
    messages=[
        {"role": "user", "content": [{"text": "Can you explain the features of Amazon Bedrock?"}]}
    ],
    inferenceConfig={"maxTokens": 2048},
)

blocks = response["output"]["message"]["content"]
text = next(b["text"] for b in blocks if "text" in b)
print(text)
在 Converse 上,你通过 additionalModelRequestFields 而不是 reasoning 参数来设置 effort 级别:
response = client.converse(
    modelId="us.xai.grok-4.6",
    messages=[{"role": "user", "content": [{"text": "What is 17*23? Number only."}]}],
    inferenceConfig={"maxTokens": 3000},
    additionalModelRequestFields={"reasoning_effort": "xhigh"},
)
三个操作注意事项。第一,在 bedrock-runtime 上,Grok 4.6 不适用于区域内推理,因此请求必须使用 us.xai.grok-4.6 或 global.xai.grok-4.6 来命名。
第二,bedrock:InvokeModel 针对三个资源进行评估:你账户的默认项目、你指定的推理配置文件,以及底层基础模型。基础模型 ARN 在各区域间使用通配符,因为跨区域配置文件会路由到调用区域之外。OpenAI 兼容端点上的 Bearer 令牌认证还需要 bedrock:CallWithBearerToken,boto3 和 Converse 不需要此权限:
{
    "Version": "2012-10-17",
    "Statement": [
        {
            "Effect": "Allow",
            "Action": "bedrock:InvokeModel",
            "Resource": [
                "arn:aws:bedrock:{region}:{account-id}:project/default",
                "arn:aws:bedrock:{region}:{account-id}:inference-profile/us.xai.grok-4.6",
                "arn:aws:bedrock:*::foundation-model/xai.grok-4.6"
            ]
        },
        {
            "Effect": "Allow",
            "Action": "bedrock:CallWithBearerToken",
            "Resource": "*"
        }
    ]
}
列出你计划调用的每个推理配置文件。配置文件各自独立作用域,因此命名 us.xai.grok-4.6 的策略不会覆盖 global.xai.grok-4.6。
第三,两种认证机制覆盖不同的代码路径。OPENAI_API_KEY 中的 Amazon Bedrock API 密钥作为 bearer 令牌传递,并对两个端点上的 OpenAI 兼容调用进行身份验证。boto3 Converse 示例改为使用 SigV4 签名,利用你环境中、普通配置文件或角色的常规 AWS 凭证。如果你打算将 Converse 与 OpenAI 兼容 API 一起使用,请同时配置两者。
将长期 API 密钥视为仅用于探索的凭证。对于生产环境,Grok 4.3 发布文章建议使用 aws-bedrock-token-generator 包从你的 IAM 凭证生成短期 bearer 令牌,因为它们会自动过期并将访问权限绑定到你的 IAM 身份,此处同样适用该指导。
使用推理 effort
推理在 Grok 4.6 上默认处于活跃状态,你通过 reasoning 参数配置模型投入多少推理精力,选项为 low(默认)、medium、high 或 xhigh。xhigh 级别是相对于 Grok 4.3 发布文章文档中的新增内容,当时的级别是 none、low、medium 和 high。
推理内容经过加密加密。你可以通过在 Responses API 请求中传递 include: ["reasoning.encrypted_content"] 来获取推理内容返回,然后在后续轮次中将这些内容发送回去,为模型提供其自身之前的推理作为多轮对话的上下文。Chat Completions API 不返回推理 token。
加密推理是 Responses API 的功能,因此此示例使用 OpenAI 客户端而不是上面 Converse 示例中的 boto3 客户端:
from openai import OpenAI

client = OpenAI()  # OPENAI_BASE_URL 指向 bedrock-runtime 端点

response = client.responses.create(
    model="us.xai.grok-4.6",
    reasoning={"effort": "high"},
    include=["reasoning.encrypted_content"],
    input="Explain quantum entanglement simply.",
)
print(response.output_text)
因为推理默认开启且 effort 按请求设置,effort 级别是真实的成本和延迟控制。将短提取和分类调用运行在 low 级别,将 high 或 xhigh 保留用于规划步骤和长智能体轨迹,因为在这些场景中早期错误会叠加。用你自己的工作负载对不同 effort 级别进行基准测试,是找出更高推理何时停止获得其 token 成本收益的最快方法。
Amazon Bedrock 上的 Grok 4.6 提供了一个由 xAI 构建的模型,专为长时间运行的智能体和雄心勃勃的交互式工作而设计,拥有 50 万 token 的上下文窗口、四种推理强度级别、图像输入、提示缓存,并可在 OpenAI 兼容的 bedrock-mantle 端点和具有 Converse API 及跨区域推理支持的 bedrock-runtime 端点之间自由选择。
在开始构建之前,请查阅 Grok 4.6 模型卡片了解当前的区域列表、功能矩阵和参数详情,并查看 Amazon Bedrock 价格页面以获取 token 费率。如果你为探索目的生成了一个长期 Amazon Bedrock API 密钥,请在使用完毕后从 Amazon Bedrock 控制台中删除它。一个不再需要的长期凭证只会扩大你账户的暴露面。
Amazon Bedrock Grok 4.6 模型卡片:https://docs.aws.amazon.com/bedrock/latest/userguide/model-card-xai-grok-4-6.html
Amazon Bedrock 中的 xAI 模型:https://docs.aws.amazon.com/bedrock/latest/userguide/model-cards-xai.html
xAI,Grok 4.6 发布:https://x.ai/news/grok-4-6
Artificial Analysis,模型对比与基准测试方法:https://artificialanalysis.ai/models
AWS,在 Amazon Bedrock 上引入 Grok(Grok 4.3):https://aws.amazon.com/blogs/machine-learning/introducing-grok-on-amazon-bedrock/