
8.0
热点
AI SCORE
编程提效2026-09-22 04:53
Agent 诊断结果上线前如何验证:分离决策与执行
dev.to · AI#AI Agent#可靠性#工程实践
Editor brief · 编辑速览
文章建议让 Agent 在生产环境行动前必须解释为何是这个诊断而非其他,区分根因置信度与行动安全性。
当团队准备将 Agent 引入 on-call 工作流时,真正的难题是判断何时该让 Agent 在生产环境里直接执行操作、何时只让它提供建议。一个根因结论只有在能够验证 Agent 排除了哪些可能性之后,才值得被信任。Causely 的因果模型现在将这些推理过程直接暴露给 Agent:针对某个症状考虑了哪些替代诊断、排除了哪些证据、以及如果不处理该故障会扩散到什么范围。
最近一个 r/kubernetes 帖子将修复 Agent 分成了两个部分:一个 LLM 提出操作建议(如扩容、回滚、封锁、排空),另一个独立的确定性层在执行前对照实际集群状态否决任何不安全的操作。这个设计假设"提出建议"和"决定执行"是两件不同的事。
最高赞回复并没有质疑这个架构,而是指出了真正的gap:相信原因是一回事,相信执行是安全的又是另一回事,两者经常被混为一谈。建议的修复方案是:强制 Agent 在提交操作建议前,解释"为什么是这个诊断",而不是其他。这样一来,审查者(人或者策略引擎)拿到的是可供核查的内容,而不仅仅是一个接受或拒绝的建议。同一帖子里的另一位工程师更进一步:一个 veto 需要有记忆能力。按 namespace 设置爆炸半径预算、冷却时间,以及一条规则——如果预期效果没有出现就停止并通知人工。还有,veto 必须自行检查真实集群状态,而不是相信 Agent 报告的那个状态。
各地的 Platform 团队都遇到了同一个挑战:Agent 的诊断能力要到什么程度,才足以让它在生产环境中自主行动?
提出操作的 Agent 和解释诊断结论的 Agent 是两件不同的事。只有后者才在任何人触碰生产环境之前是可核查的。信心分是一个断言。症状的多种可能解释以及每种解释背后的因果链,才是审查者(人或者自动化系统)可以检验的东西。
这和帖子里第二位工程师描述的问题是一样的:相信 Agent 自我报告的 veto 是"第二意见",不是"核查"。能看清模型考虑过并否决了哪些选项、并且知道胜出诊断的爆炸半径有多大的 veto,才有真正可以校验的东西。
在理解因果关系时,大多数熟悉这个领域的人通常不会问"X 为什么发生?"他们更倾向于问"为什么是 X 而不是 Y"——这是可解释 AI 研究中关于对比解释的一个发现:解释只有在相对于某个没有发生的替代选项时才是令人满意的,即使那个替代选项从未被明确说出来。2025 年对这个问题的形式化直接将其框架为"为什么是 P 而不是 Q",并把计算两者之间的差异作为真正的解释任务,而不是事后补救。
Causely 的 MCP server 现在暴露了两个专门为这个问题设计的工具。get_potential_diagnoses 告诉你什么可以解释一个给定的症状,而不仅仅是因果模型选中的那个,并展示每个候选诊断背后的因果链。get_signal_potential_diagnoses 从反方向运行同样的问题:给定一个观察到的信号,什么可以解释它,每个候选诊断与该信号之间有什么因果链?两者都依赖产生主诊断的同一个因果模型:同一套推理,只是可见了,而不是被压缩成单一答案。
举一个常见的事故:结账服务的延迟升高和超时,它是多层下游节点,问题根源来自一个共享数据库连接池。一个仅基于 LLM 的 Agent 只会从症状出发追踪。它查询遥测数据,从结账服务往回追溯,在沿途发现了一个相邻服务的 CPU spike。它诊断 CPU spike 是原因,然后重启了该服务。仪表盘好转了。Agent 宣布事故已解决。
真正的原因——共享数据库连接池的连接耗尽——在上游那个层面没有直接信号,所以 Agent 始终看不到它。重启只是通过清除 CPU spike 争取了时间,并没有解决根本问题。当连接数再次达到上限时,事故再次爆发,Agent 重复这个循环。
Claude 解释为什么是这个诊断以及考虑了哪些替代方案但被排除的示例。
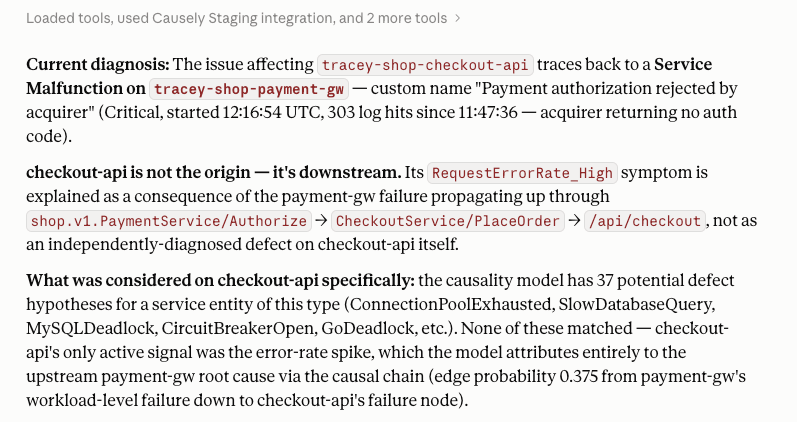
对原始症状调用 get_signal_potential_diagnoses 会将连接耗尽诊断和 CPU spike 替代方案同时浮出水面,每个都附有因果链,显示它能解释什么、不能解释什么。CPU spike 无法解释下游超时模式;连接耗尽则可以。这种对比才是让诊断在修复 Agent 执行前可被审查的关键,而不仅仅是最终答案。
Claude 将该诊断的因果链可视化的示例
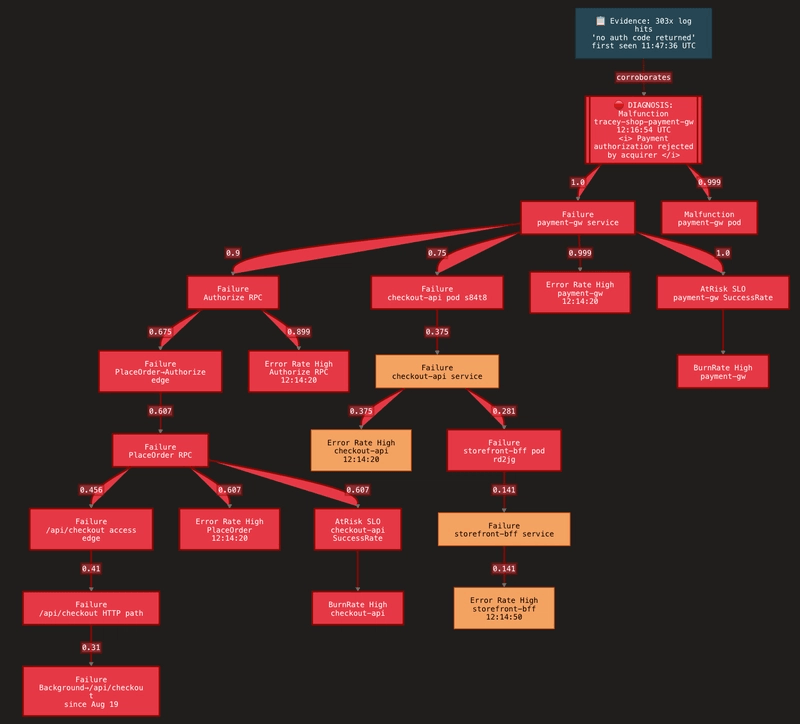
爆炸半径小且已被充分理解的诊断,和爆炸半径大且充满不确定性的诊断,是不同的风险决策——即使模型对两者的信心程度相同。rank_entities 和 get_diagnosis_observable_signals 揭示在采取任何行动之前,故障会影响哪些实体,以及预期会在下游观察到哪些信号。
get_diagnosis_observable_signals 工具调用在 Claude Desktop 中的响应示例
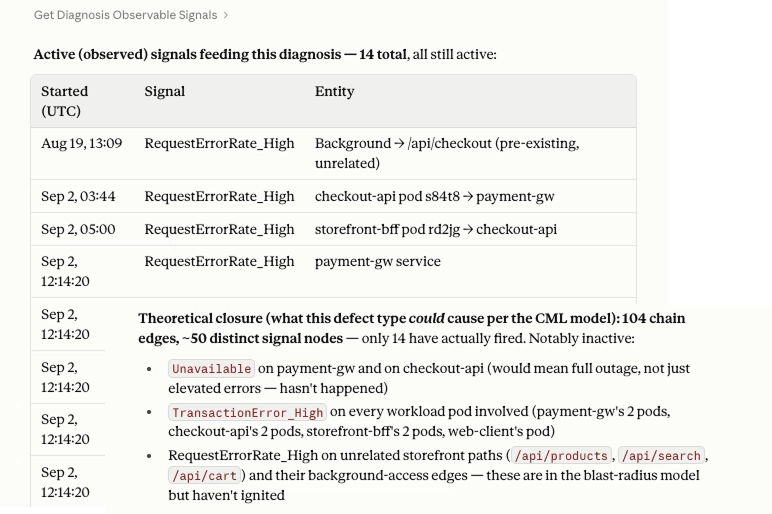
这就是上面 Kubernetes 帖子中 veto 想法的具体版本:爆炸半径预算只有在能先计算出爆炸半径时才有用。按依赖暴露度对实体排序,才是给策略引擎或者值班人员提供的一个可与预算对比的数字,而不是靠猜。
现有的工具在因果模型当前状态下回答"为什么是这个而不是那个"和"会扩散到什么程度"。下一层是前向模拟:"如果这个组件发生退化,什么会被破坏",在症状出现之前就问,而不是之后。这需要将故障模式建模为具有自身前置条件和爆炸半径的一等公民,而不是仅仅从观察到的异常向后推理。这是同一因果模型的自然延伸:问的是同样的问题,只是时间点提前了,而不是事后补救。
对比解释回答的是"为什么是这个原因而不是那个原因",而不是仅仅"为什么这件事发生了"。可解释 AI 的研究发现,人们总是相对于一个没有发生的替代选项来评估解释,即使那个替代选项没有被明确说出来。在根因分析中,这意味着要展示考虑了哪些诊断并将其排除,而不仅仅是列出被选中的那个。
安全 veto 检查的是所提议的操作对照实时系统状态是否安全可执行。对比诊断解释检查的是诊断背后的推理是否成立,以及哪些替代方案被排除了、以什么证据排除的。两者是互补的:如果有一个可以检查的诊断,veto 层会更有用,而不是一个赤裸裸的信心分。
用 get_potential_diagnoses 或 get_signal_potential_diagnoses 针对 Agent 正在推理的症状进行查询,看看什么可以解释它以及每个候选诊断背后的因果链。再配合 rank_entities 或 get_diagnosis_observable_signals 来了解主要诊断的爆炸半径,然后在批准任何修复操作之前完成核查。
不是。展示什么可以解释一个症状以及每个候选诊断背后的因果链,是让诊断变得可核查,而不是让它变得不确定。只报告最优答案的模型是在请求被信任。展示它还考虑了哪些选项以及每个选项被排除的原因的模型,是在接受审查。后者才是更强的声明。
延伸阅读《因果推理如何解决 LLM 在可观测性中的局限性》。
延伸阅读《超越爆炸半径》。
了解更多 Causely MCP 工具。