8.0
热点
AI SCORE
编程提效2026-09-22 03:23
AI编码导致CI成瓶颈?我们重新设计了CI流程
Hacker News#CI/CD#AI编程#DevOps
Editor brief · 编辑速览
AI辅助编程大幅增加CI负载,Linear团队分享如何改造CI pipeline以应对高频提交和大规模自动化测试。
今年早些时候,我在 Linear 里打开 Linear,发现我们的 CTO Tuomas 给我分配了一个 Issue,标题是"CI 成本过高"。与此同时,他还希望我让 CI 变得更快。
AI 编程 Agent 让代码交付速度呈指数级提升,但对这些变更的验证却没能跟上同样的速度。每个 PR 仍然需要通过 CI 流程,于是当开发加速时,CI 就成了瓶颈——推高了基础设施成本,也让开发者和 Agent 等待反馈的时间越来越长。
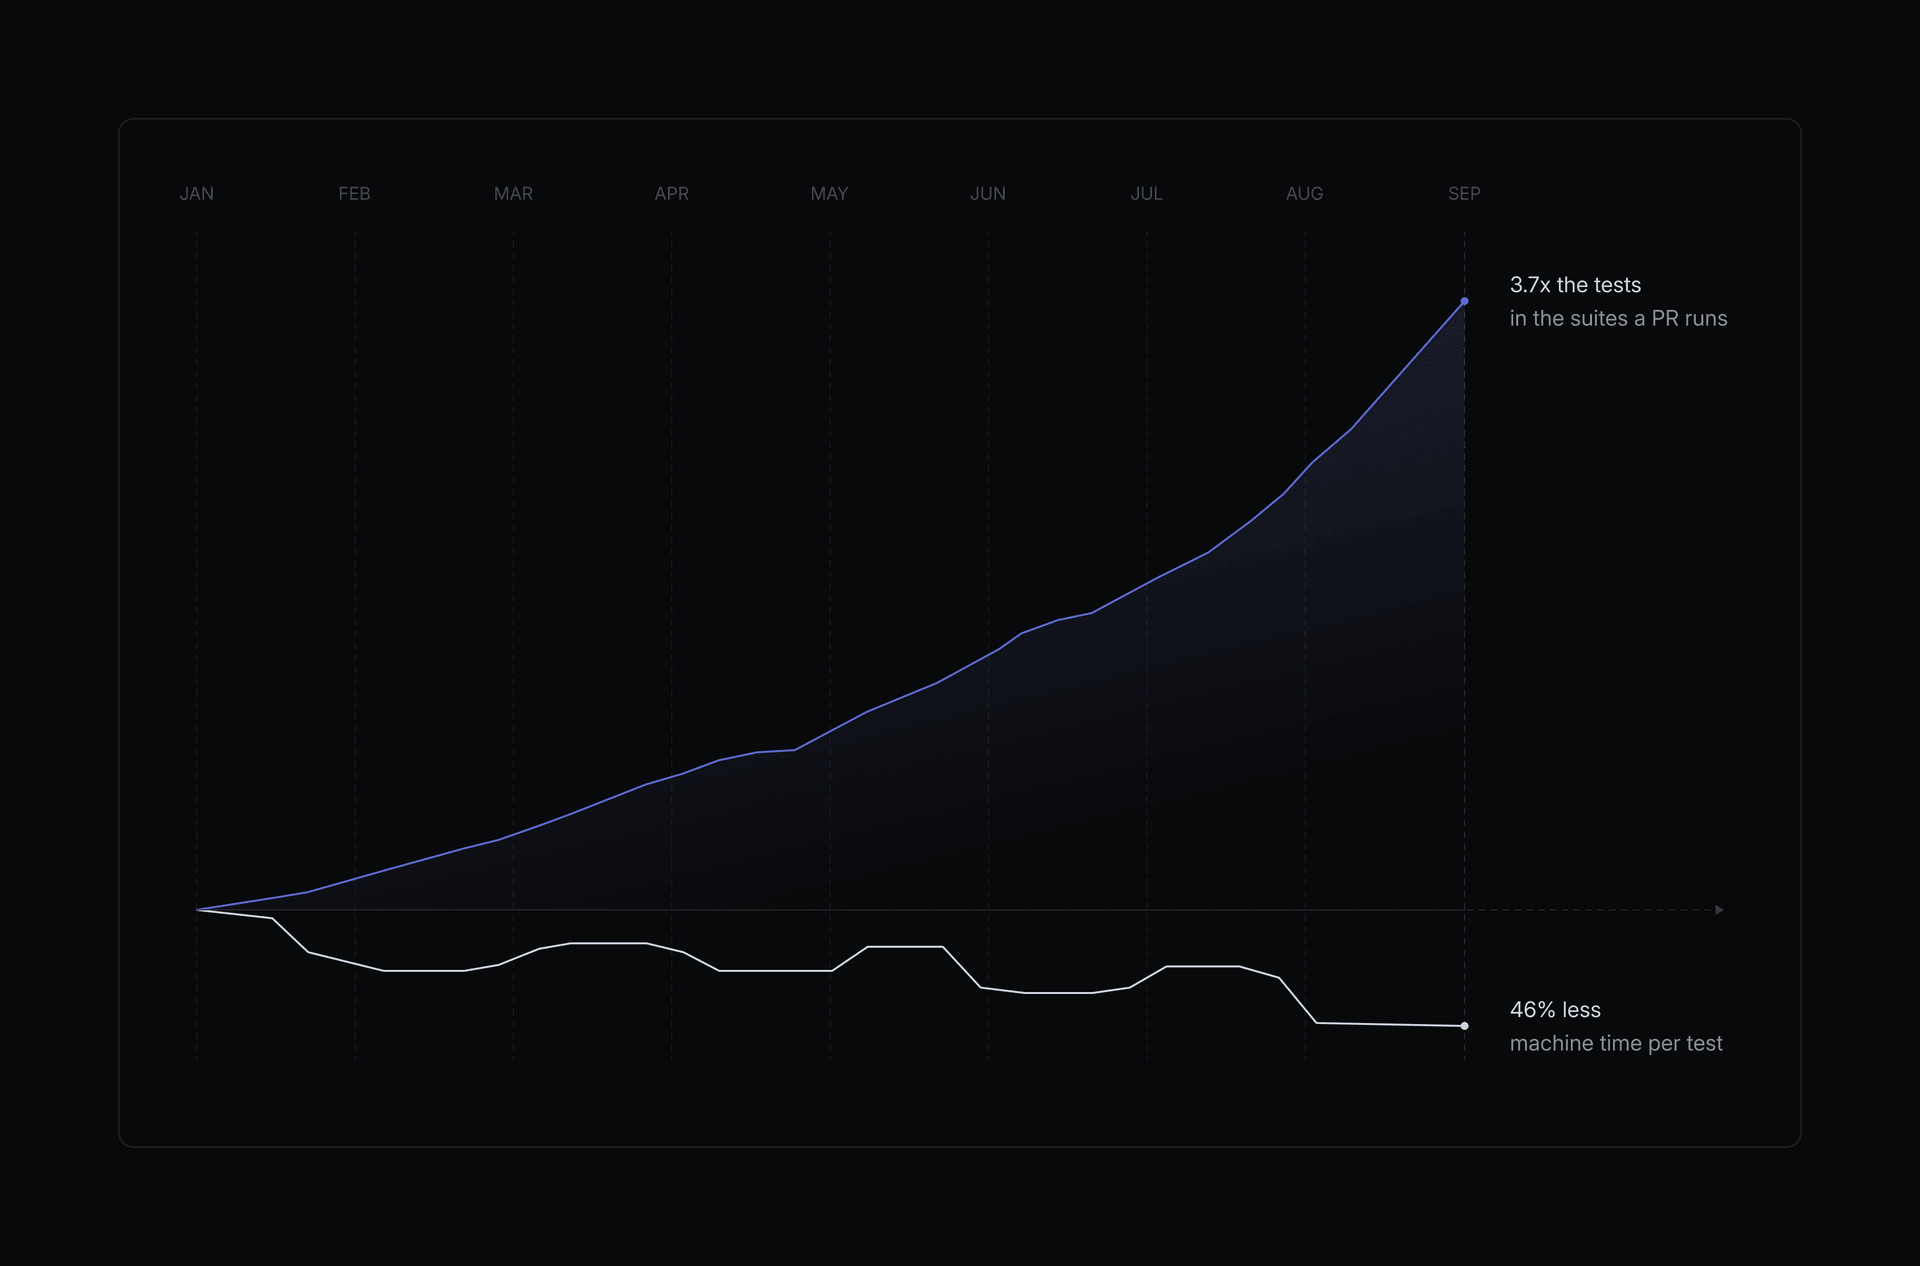
在 Linear 为了让 CI 更加高效而做的各种优化中,我们重点关注了两个指标:PR 在 CI 上等待的时间,以及消耗的 runner 时间。尽管今年年初以来我们的测试套件增加了近四倍,但 PR 的等待时间从超过 6 分钟降到了仅 5 分钟出头,而每个测试消耗的 runner 时间大致减少了一半。
这张图是测试套件性能相对于 1 月第一周的指数。白线追踪的是每个测试的机器时间,当添加测试分片时会飙升(分片缩短了等待时间但消耗了更多机器时间),在 checkout 卡顿问题期间也有波动。
总的来说,我们从四个方向改进了 CI:
升级基础设施和工具链
优化前置关键路径上的任务
减少重复的初始化工作
提升测试执行效率
Linear 的代码库以 TypeScript 为主,但其中许多优化方法适用于各种语言和工具链。
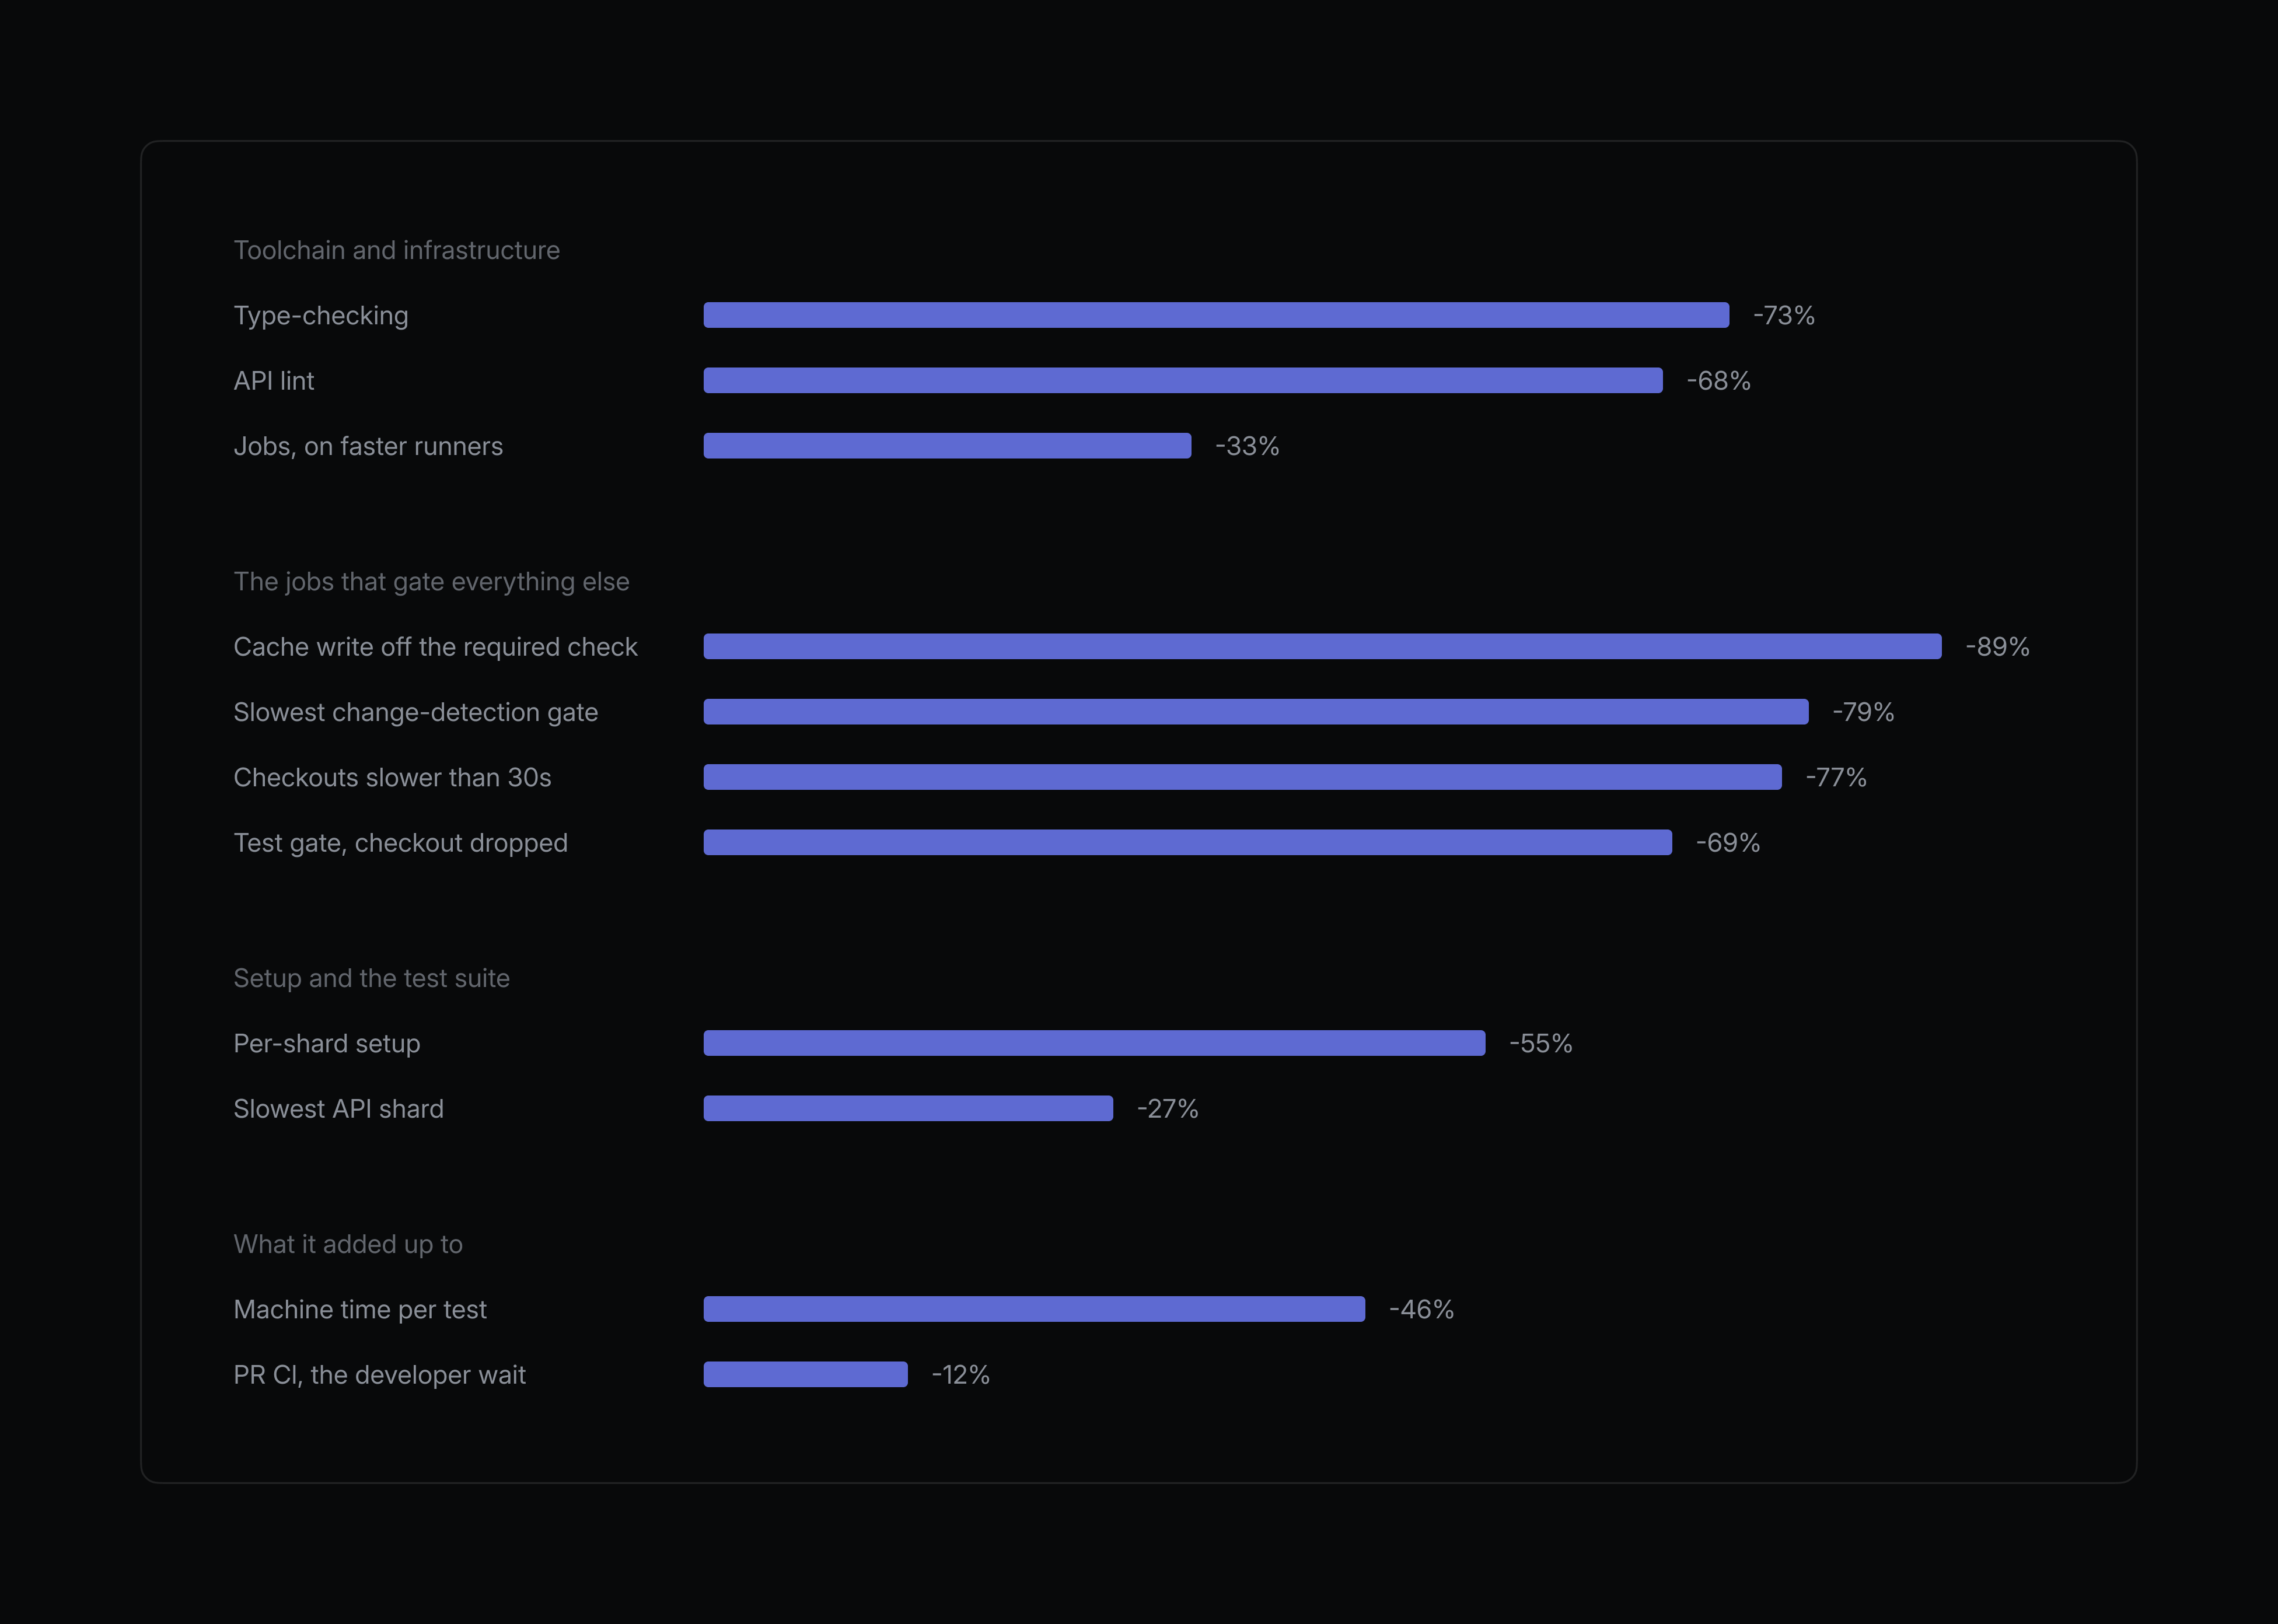
我们最早的一些收益几乎不需要对 CI 本身做任何优化。把工作负载从 GitHub Actions 迁移到第三方 runner,这些 runner 拥有更快的 CPU、更高性能的存储和更好的缓存基础设施,让我们在相同的流水线运行在更快的机器上。在切换前后两天的逐项对比中,作业平均快了 34%,像 tsc 这样的工作负载更是下降了 52%。
此外,更新工具链也带来了回报。切换到 tsgo(原生 TypeScript 编译器)后,tsc 检查的周中位数时间下降了 73%,幅度大到将类型检查完全移出了瓶颈位置。
linting 是另一个早期目标。我们有少量自定义 lint 规则依赖 TypeScript 类型信息——要么是强制某种约束,要么是应用某种 autofix。这意味着每次 lint 运行都要在评估这些规则之前构建完整的类型图,使得 linting 成为我们 CI 作业中内存消耗最大的任务之一。
我们用对抽象语法树的静态分析重写了这些规则,在不依赖类型信息的情况下识别函数风格的代码结构和 guard 模式。这让 ESLint 完全不再需要 TypeScript,API lint 时间减少了 68%,全仓库 lint 时间减少了 55%。内存占用也大幅下降。
移除对类型信息的依赖也让我们后来迁移到 Oxlint 变得容易许多,因为纯语法层面的规则迁移起来非常直接。Oxlint 本身进一步减少了 linting 所消耗的 CI runner 分钟数。
底层基础设施和各环节检查都跑得更快之后,我们拉远视角,把 CI 当作一个系统来看。这让我们注意到那些挡在所有事情前面的小任务。每次运行都会先检查一个 PR 修改了哪些路径,以及这些测试是否已经在相同输入下通过。我们在这些检查的作业级别设置门控,这样被跳过的任务永远不会占用 runner,但同时也让它们直接落在了关键路径上。八个 API 测试分片在它们完成之前一个都不能启动,所以即使是很小的延迟也会被不成比例地放大。
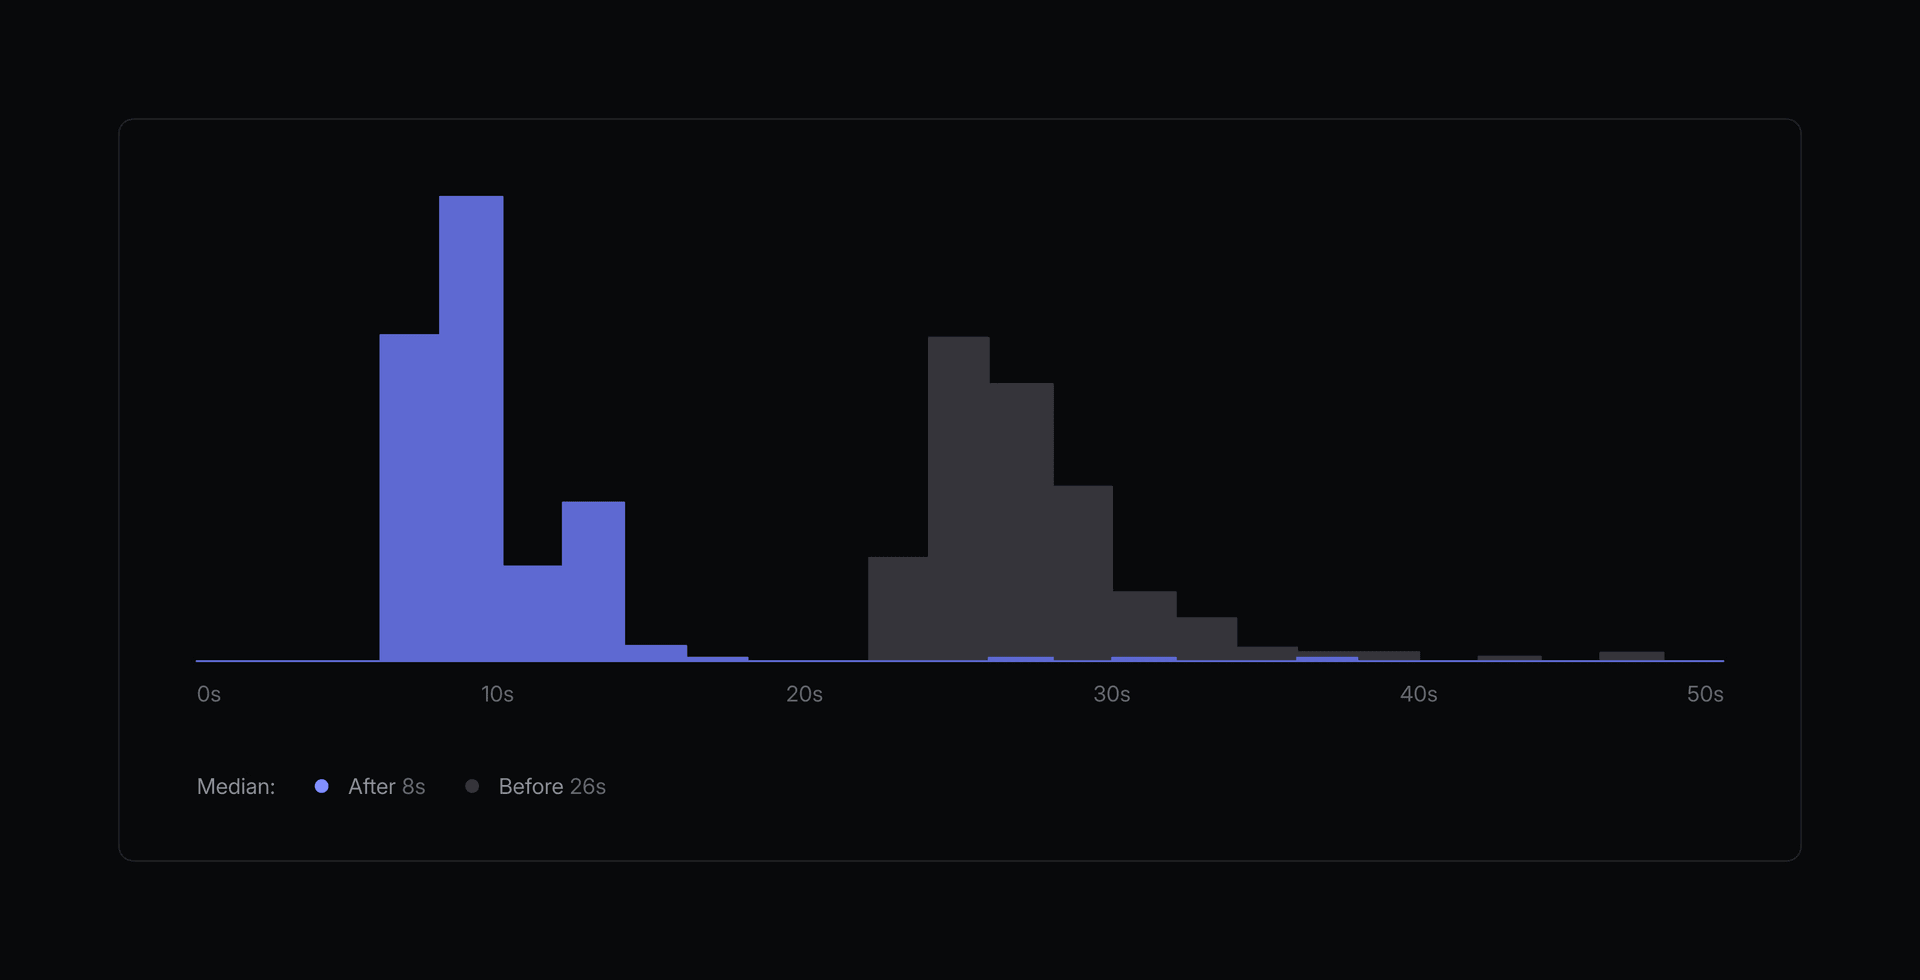
我们的多个工作流都以一个变更检测任务作为开头,它来决定后续运行什么——例如,它会检查 diff 中是否包含数据库迁移,然后输出一个信号用于调度相关的数据库 CI 检查。这些任务当时在 checkout 完整的工作树,尽管它们只需要其中很小的一部分。我们限制了 fetch 深度,把这些门控中最慢的从 94 秒降到了 20 秒;对于那些根本不需要工作树的作业则完全移除了 checkout,将这些任务的时间从 27 秒减少到了 7 秒。对于 commit push 和 merge-queue 事件(在这些场景下确实需要 diff 路径),我们发现使用稀疏的、blobless 的 checkout 并限制历史记录就够了,又节省了大约 11 秒。
变更检测任务的中位持续时间从 26 秒降到了 8 秒,P90 从 31 秒降到了 12 秒,最慢的一次运行从 138 秒降到了 37 秒。
在我们更换了底层 runner 基础设施之后,我们注意到作业中 checkout 时间(使用 actions/checkout)变长了,有时还会卡住。由于第三方 runner 位于 GitHub 网络之外,它们依赖直接 IP 链路来访问 GitHub。提供商追踪到这些卡顿源于该链路上的间歇性降级。我们的多个工作流都以 checkout 开头,所以一次卡住的 fetch 就可能延迟整个 CI 运行。
为了抵御网络不稳定的风险,我们将 actions/checkout 替换为自己编写的复合 action,它支持退避重试,并设置了 GIT_HTTP_LOW_SPEED_LIMIT 和 GIT_HTTP_LOW_SPEED_TIME,使卡住的连接在大约 30 秒后中止而不是无限挂起;同时使用 checkout cache,它在粘性磁盘上维护一个持久的 git mirror。其结果是,关键路径任务空闲等待 checkout 完成的情况大大减少。
并非关键路径上的每个作业都需要留在那里。我们当时是在合并前的最后一次检查中写入缓存标记,这意味着一个 PR 在其测试通过之后仍然可能卡在 merge queue 里。我们把这个写操作移到了一个在测试分片完成后才运行、但不阻挡任何后续步骤的作业中,这一改动为每个 API PR 和 merge-queue 条目在合并路径上节省了 42 秒。
综合来看,这些改动在缓存未命中时大约为 API PR 的必要检查节省了将近一分钟,同时也减少了 runner 的启动次数。
接下来我们把注意力转向每个作业都在重复的初始化成本——启动 runner、安装依赖包、配置构建依赖等。这种开销意味着一个只做了几秒钟有用工作的作业最终可能消耗整整几分钟的基础设施时间。以下是我们针对这个问题采取的几项措施:
我们的 API 测试分片每次运行都要用 apt 安装相同的 Postgres 客户端,花费 7 到 8 秒。我们把它移到了一个包含 Node 和该客户端的小型 CI 基础镜像中,这样每个分片就可以从一个已经准备好的环境启动。后来我们又在镜像中添加了所需的原生构建头文件,因为发现在初始化过程中下载它们偶尔会卡住,缩短了长尾时间。
Linear 的代码库是一个以 pnpm workspace 管理的 monorepo。我们的 API 测试工作流当时在安装整个 workspace,尽管它只需要 API 包及其依赖。将安装限制为 API 包后,pnpm install 从 44-73 秒降到了 16-18 秒。我们对 API 相邻的作业也应用了相同的模式,它们之前各自都在安装完整仓库并上传依赖缓存,而后续运行几乎永远无法命中。
我们还测试了缓存 node_modules 的效果,发现直接重建反而更快。缓存 key 依赖于一个频繁变化的 lockfile,而且即使命中缓存也需要大约 28 秒来恢复,相比之下一次过滤后的安装大约只需 7.5 秒。缓存不仅增加了保存时间还给结果带来了变异性,却没有给我们带来任何明显的好处。
这三项改动合计将每个分片的初始化时间减少了约 44%,从 110-140 秒降到了 67-73 秒。
测试分片的 p95 持续时间
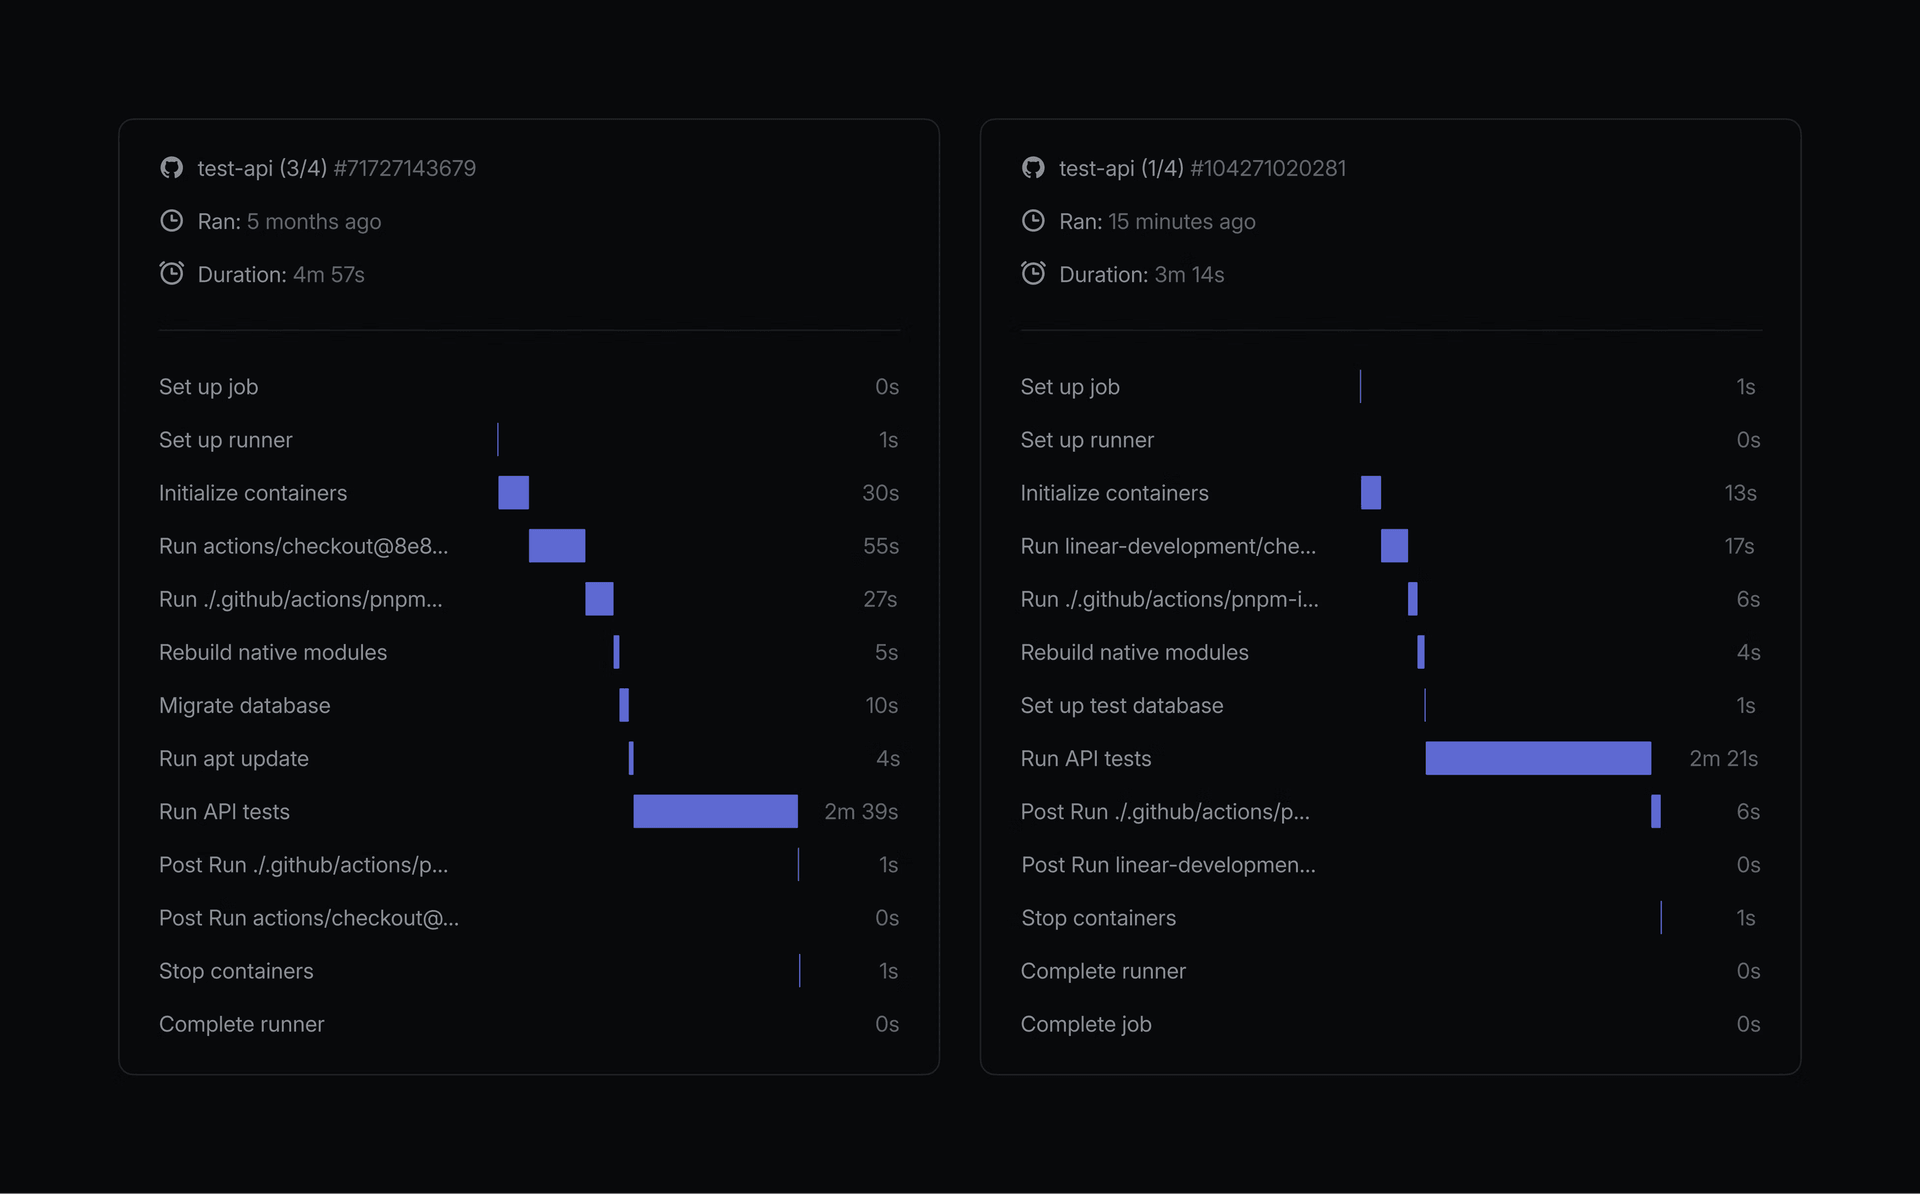
除此之外,还有一些其他形式的重复初始化工作我们可以完全避免。
有些初始化工作只在输入变化时才需要重复。例如,我们的 API 容器每次运行都在重放完整的数据库迁移历史,即使 PR 没有修改 schema。对于这些情况,我们切换为加载生成的 schema snapshot 和 bootstrap 文件,将每个容器的数据库初始化从大约 12 秒缩短到 1-2 秒。
有七个独立的检查各自都在启动一个 runner、checkout 仓库、安装依赖,然后只做了几秒钟的有用工作。我们把它们合并成了两个作业,然后在这两个作业内部并发运行这七个任务。这将我们支付相同初始化开销的次数从七次减少到了两次。根据 6 月的使用量计算,这一改动每月节省了大约 87,000 个 runner 分钟,相当于我们总 CI 用量的 11.8%。
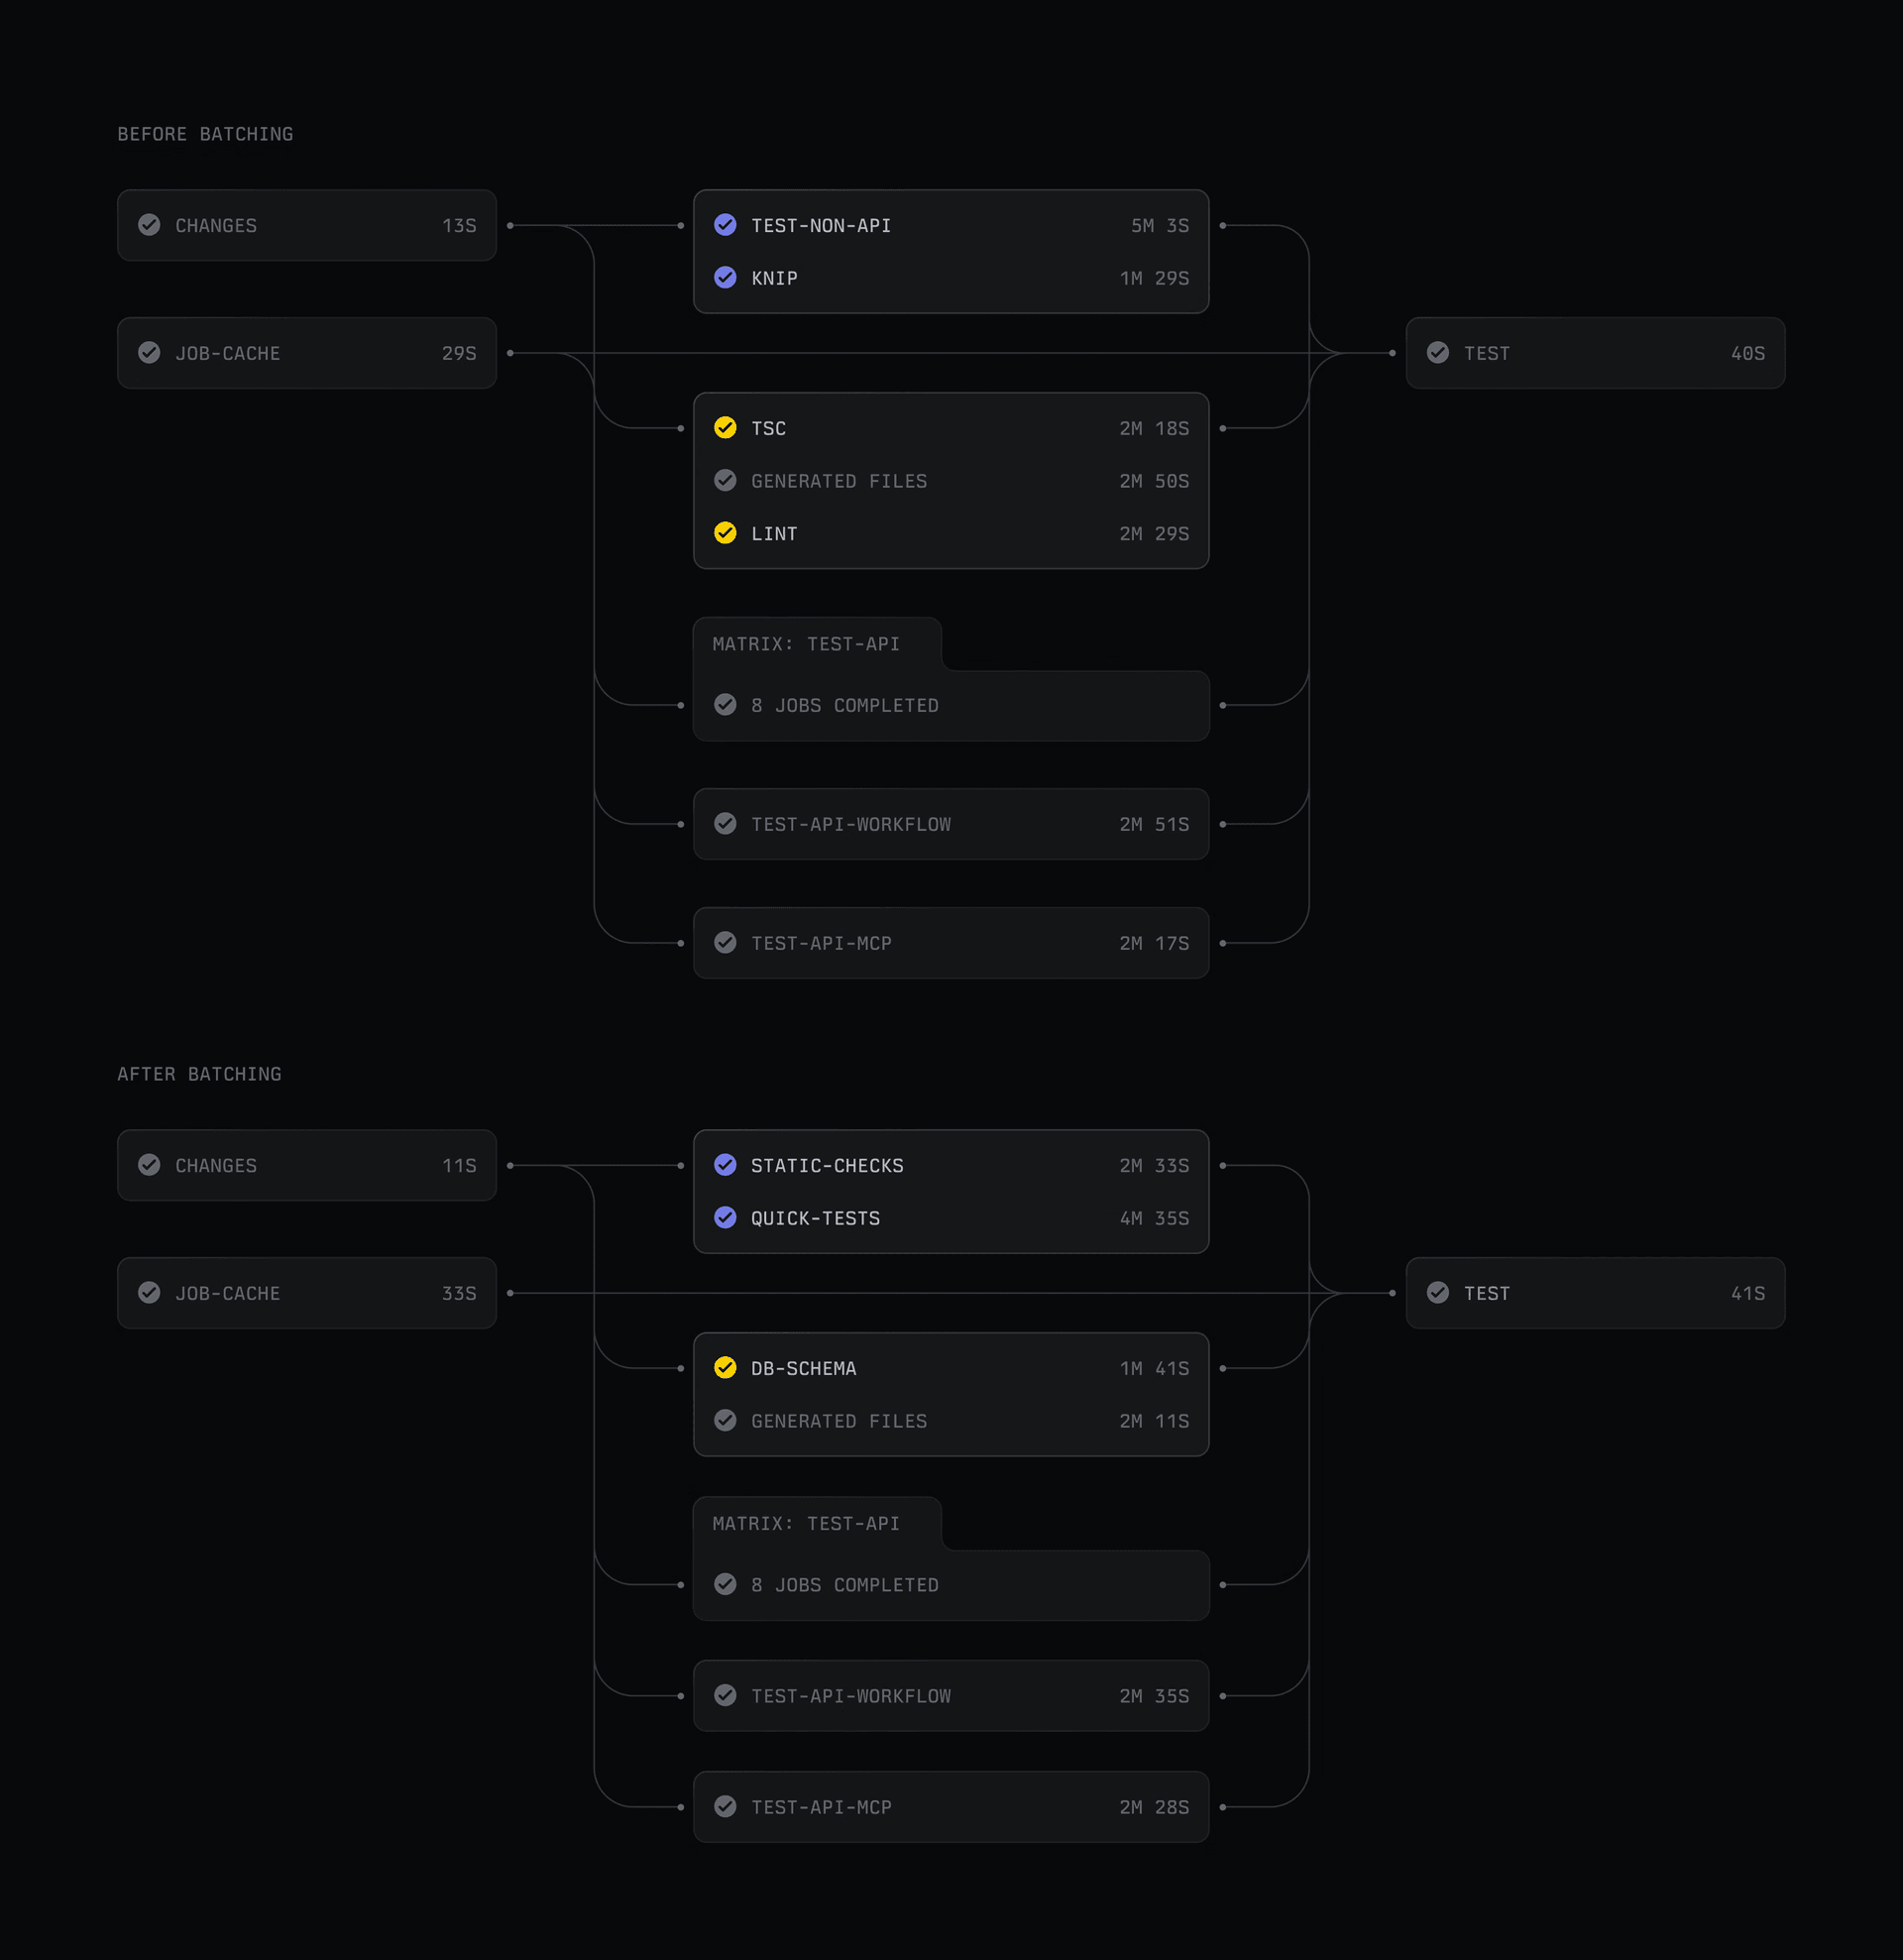
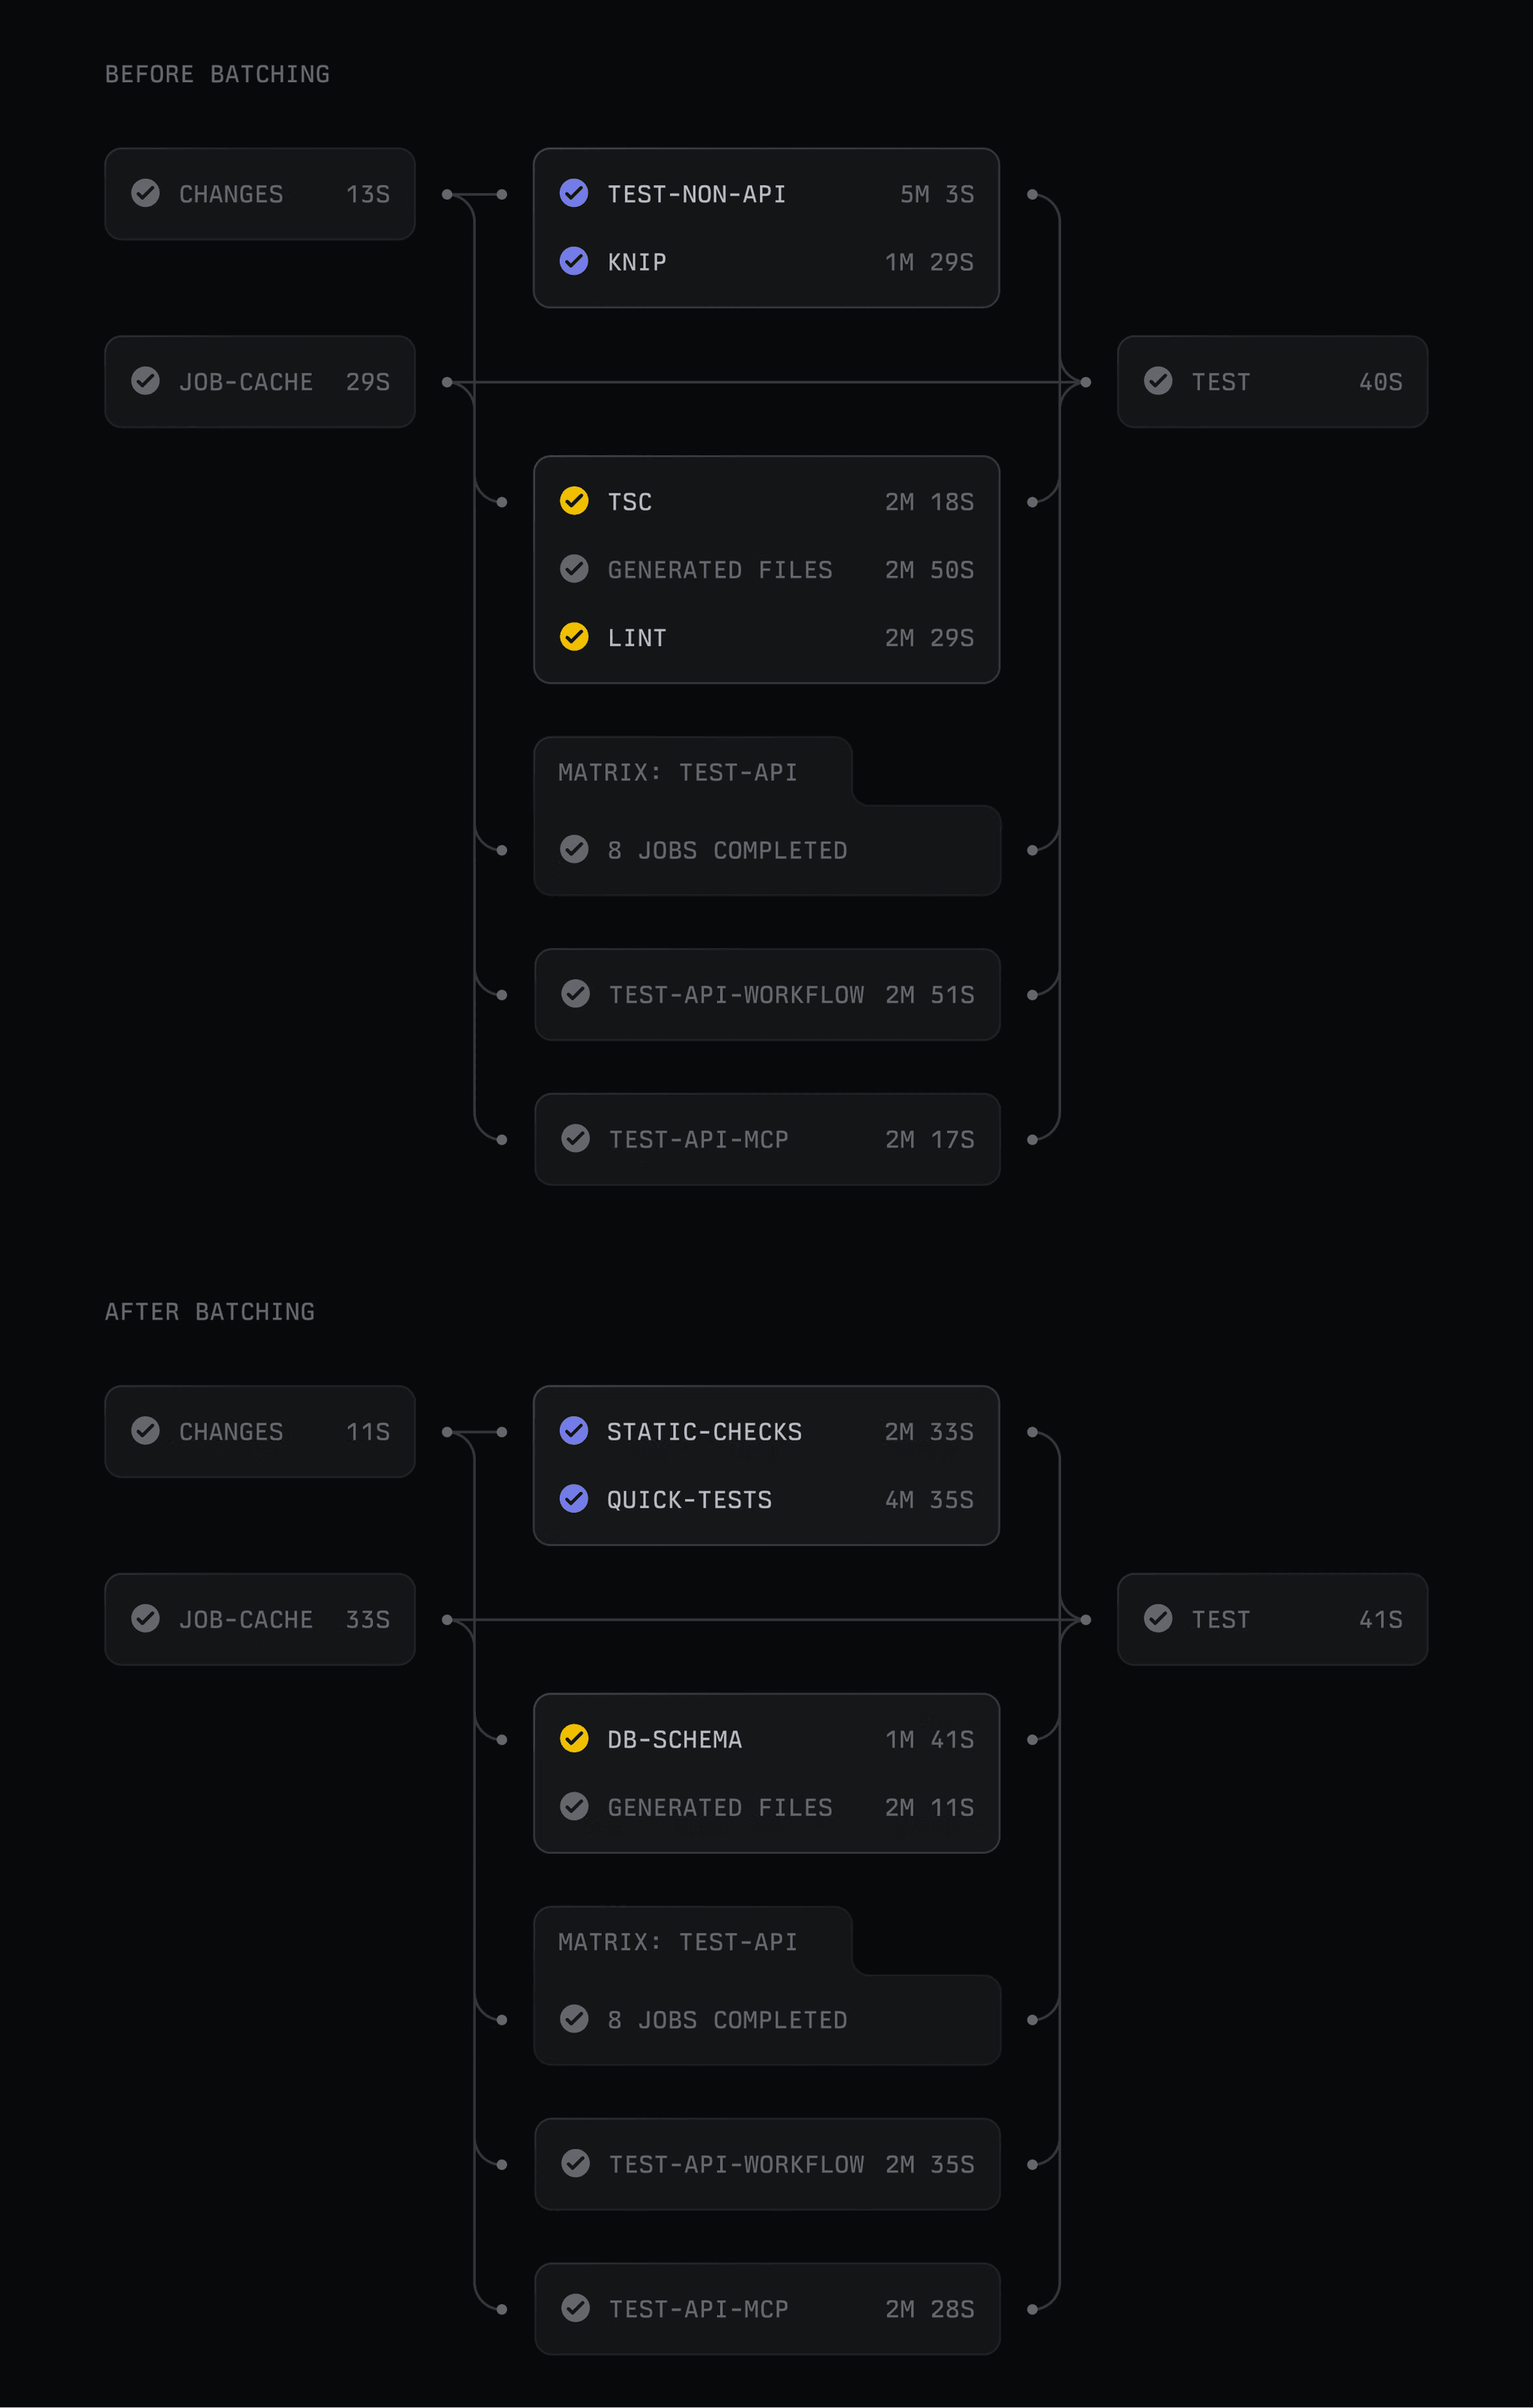
随着每个测试分片的固定成本降了下来,我们可以更加激进地对 API 套件做并行化了。它是我们工作流中规模最大、执行频率最高的部分之一,所以对它的改进对合并时间有超大的影响。
Vitest(我们用于 TypeScript 测试套件的测试运行器)是按文件而非按单个测试的持续时间来分配工作的。这意味着几个异常大的测试文件可能主导一个分片,实际上拖累整个套件的完成进度——即使其他分片早就跑完了。
我们将这些大文件拆分成更小、更聚焦的文件,同时保留了测试的结构,然后评估了不同的分片和 runner 配置。我们在今年早些时候已经从三个分片增加到了四个;迁移到八个分片后,关键作业在初始基准测试中快了约 19%,费用也降低了约 19%。一周之后,最慢的分片从 5.25 分钟降到了 4.33 分钟。
Vitest 通常会隔离每个测试文件,这对我们来说意味着每个测试分片都要重建 entity、GraphQL 和 decorator 图。我们引入了一个可选的 vitest 项目,配置为 isolate: false,允许安全的文件在每个 worker 内部共享一个模块注册表。
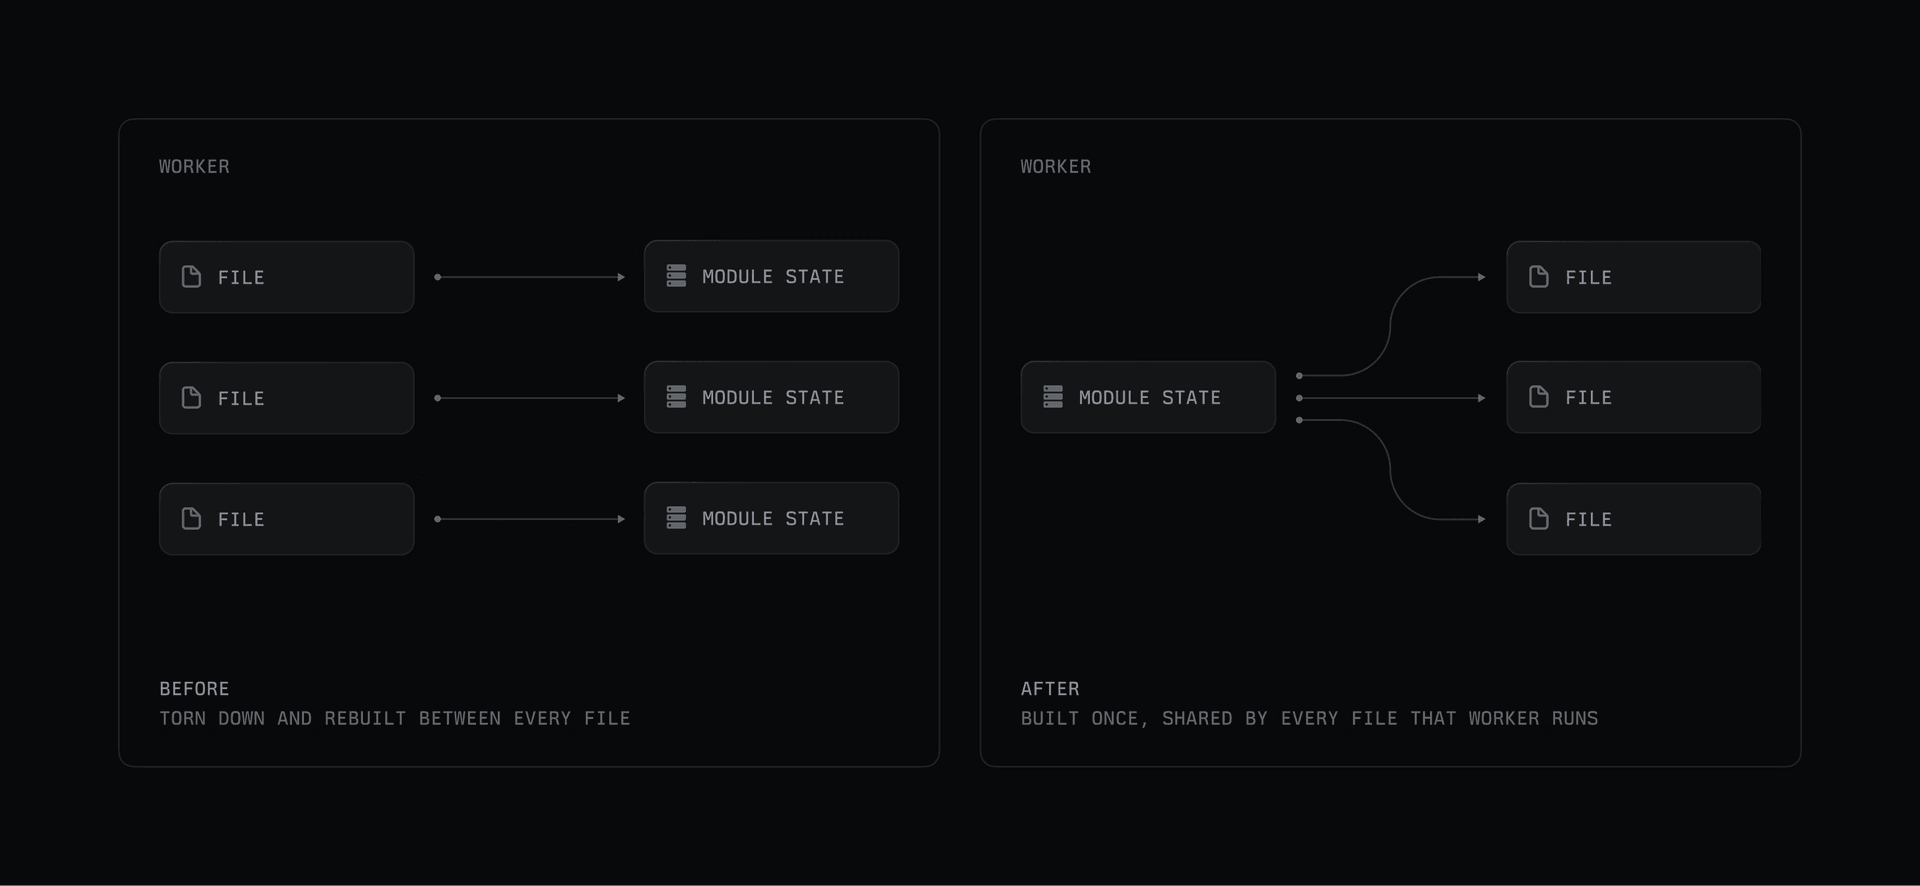
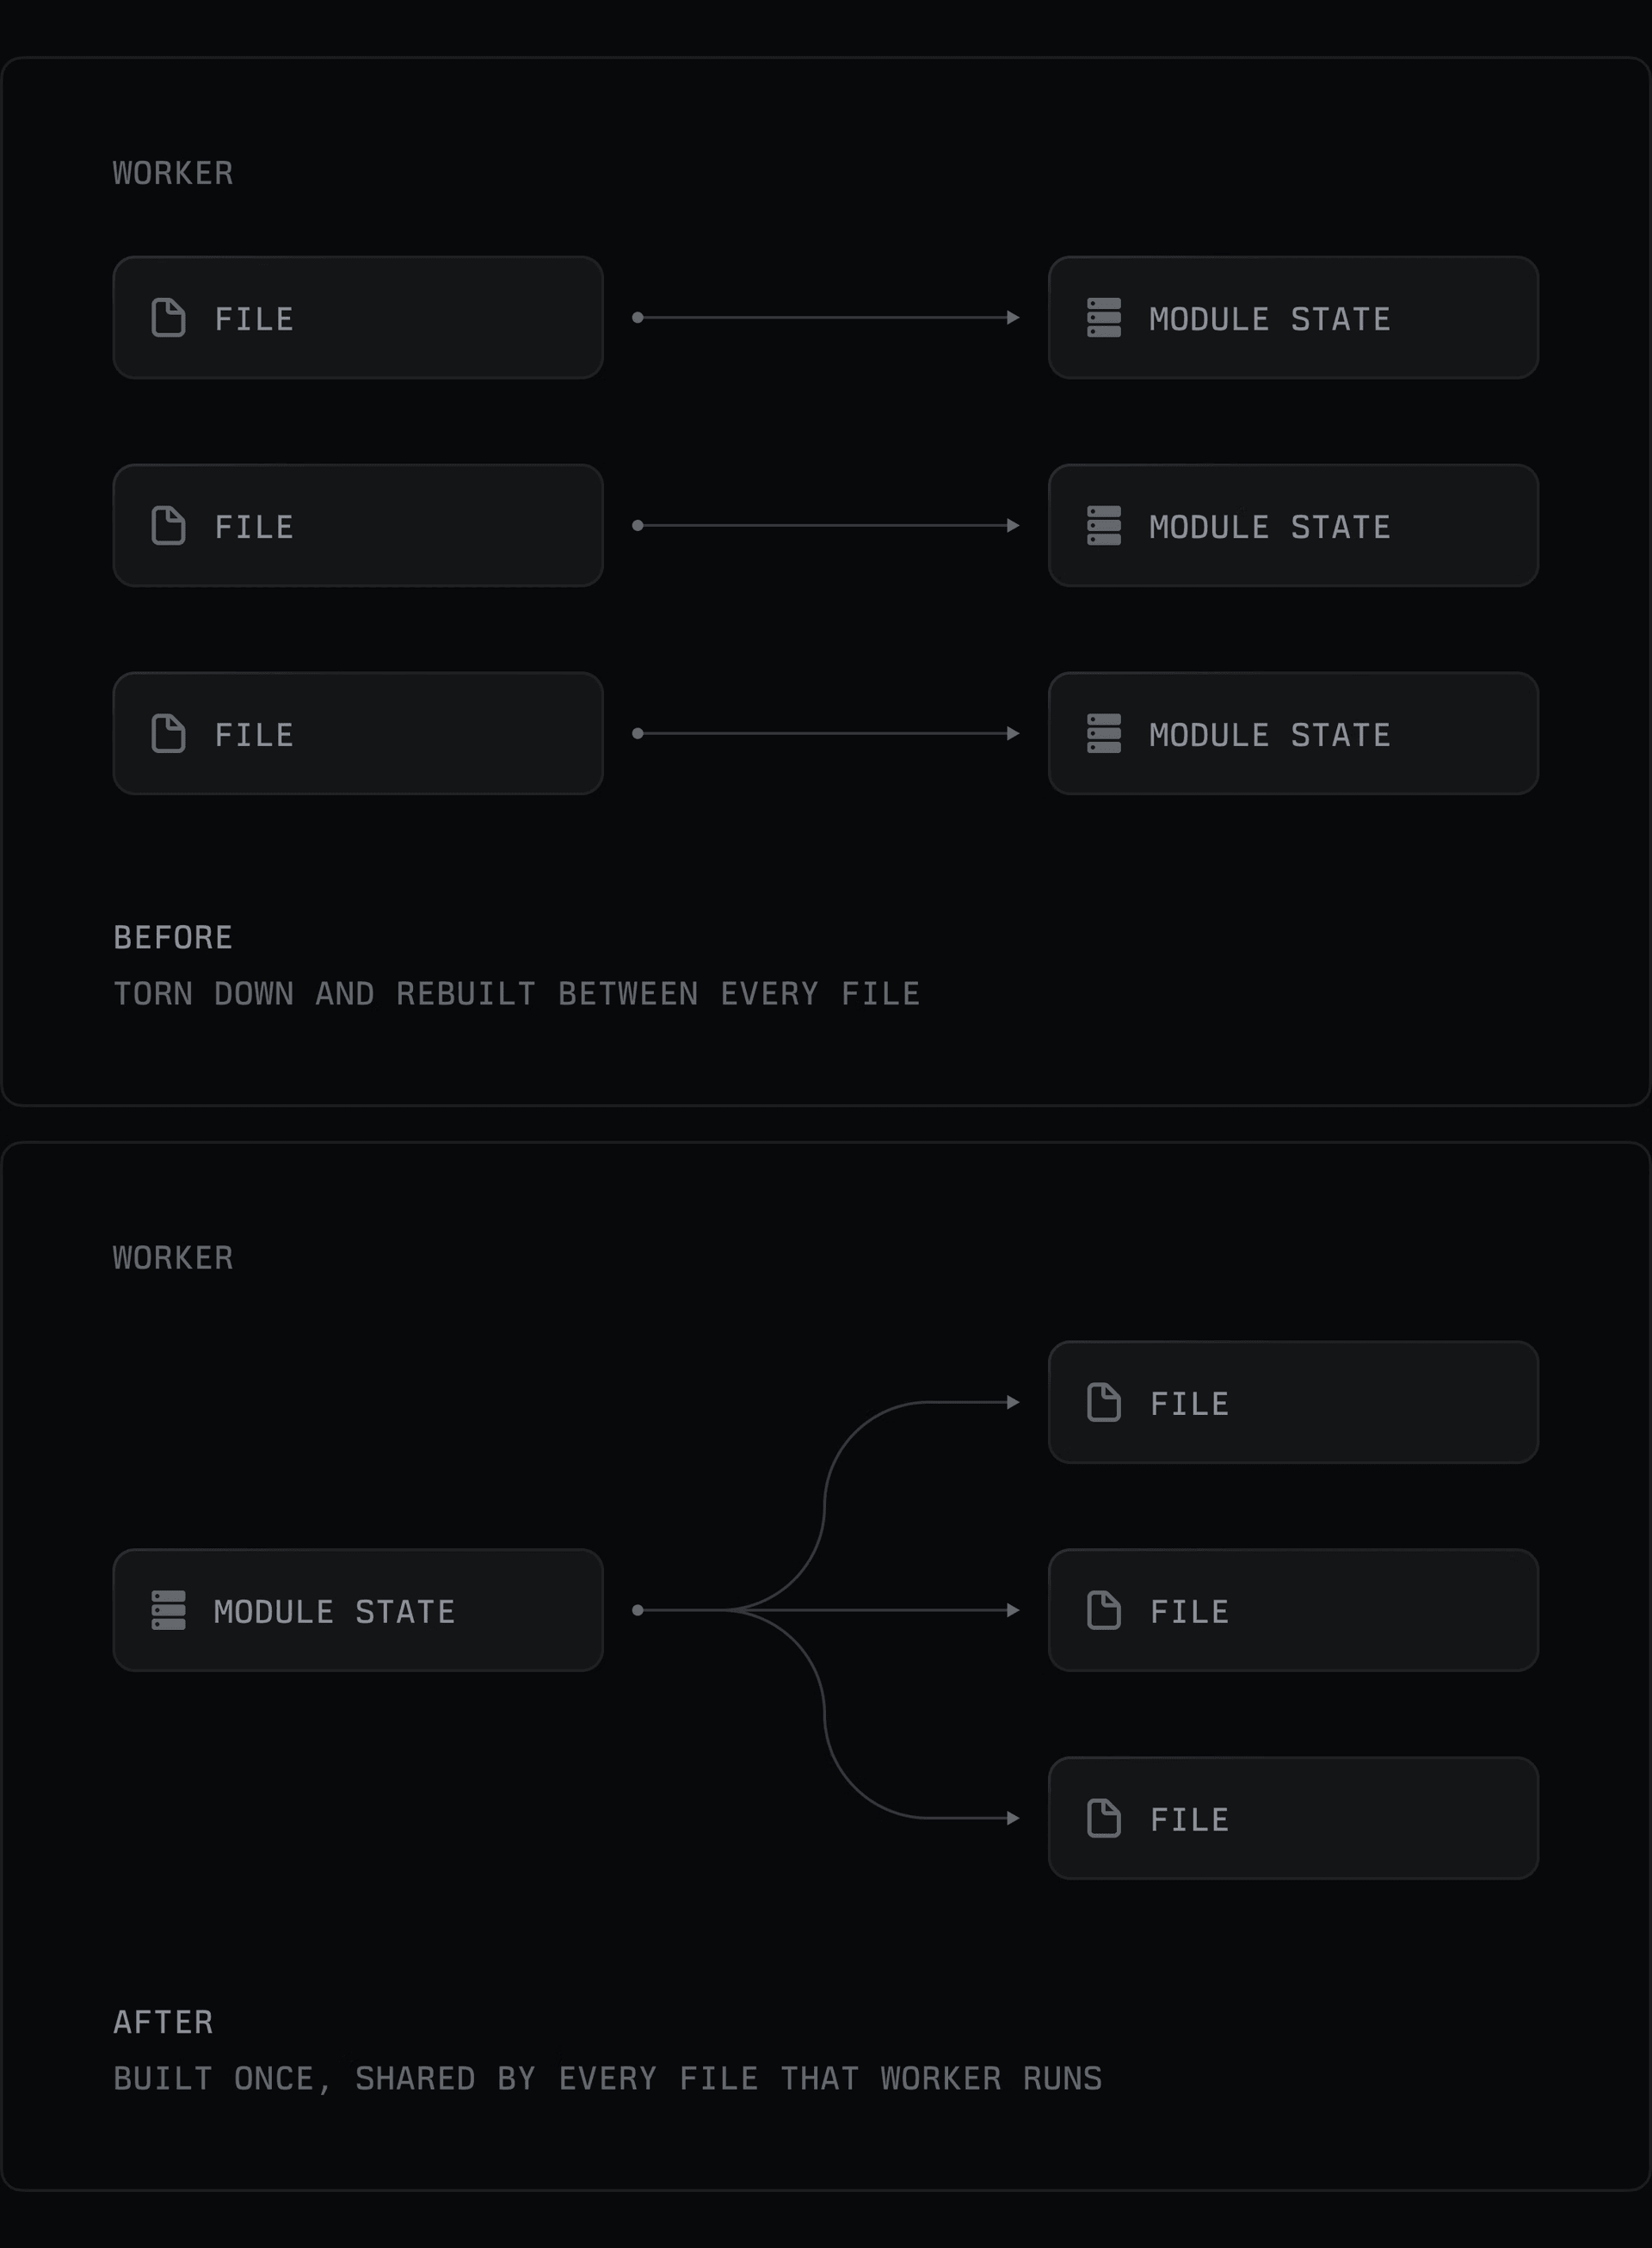
这是我们单项性能改进中幅度最大的一次,在我们当前的体量下每月节省了约 17%。最慢的分片从大约 300-379 秒降到了约 195 秒,而每次运行的 API 分片 runner 时间从大约 32.8 降到了 22 分钟。
同时这也是正确性风险最高的优化。我们通过在每个文件上添加可选的 opt-in 注释使符合条件的情况变得明确,并添加了共享状态所需的 teardown。有少量文件使用了 fake timer 或共享状态,我们无法安全地解开它们,所以将它们保留在隔离项目中。而且由于现在 Agent 编写了我们大部分的测试,我们也更新了各自的 Agent skills 来考虑这个性能优化选项,这样生成的测试默认也会遵循相同的约束。
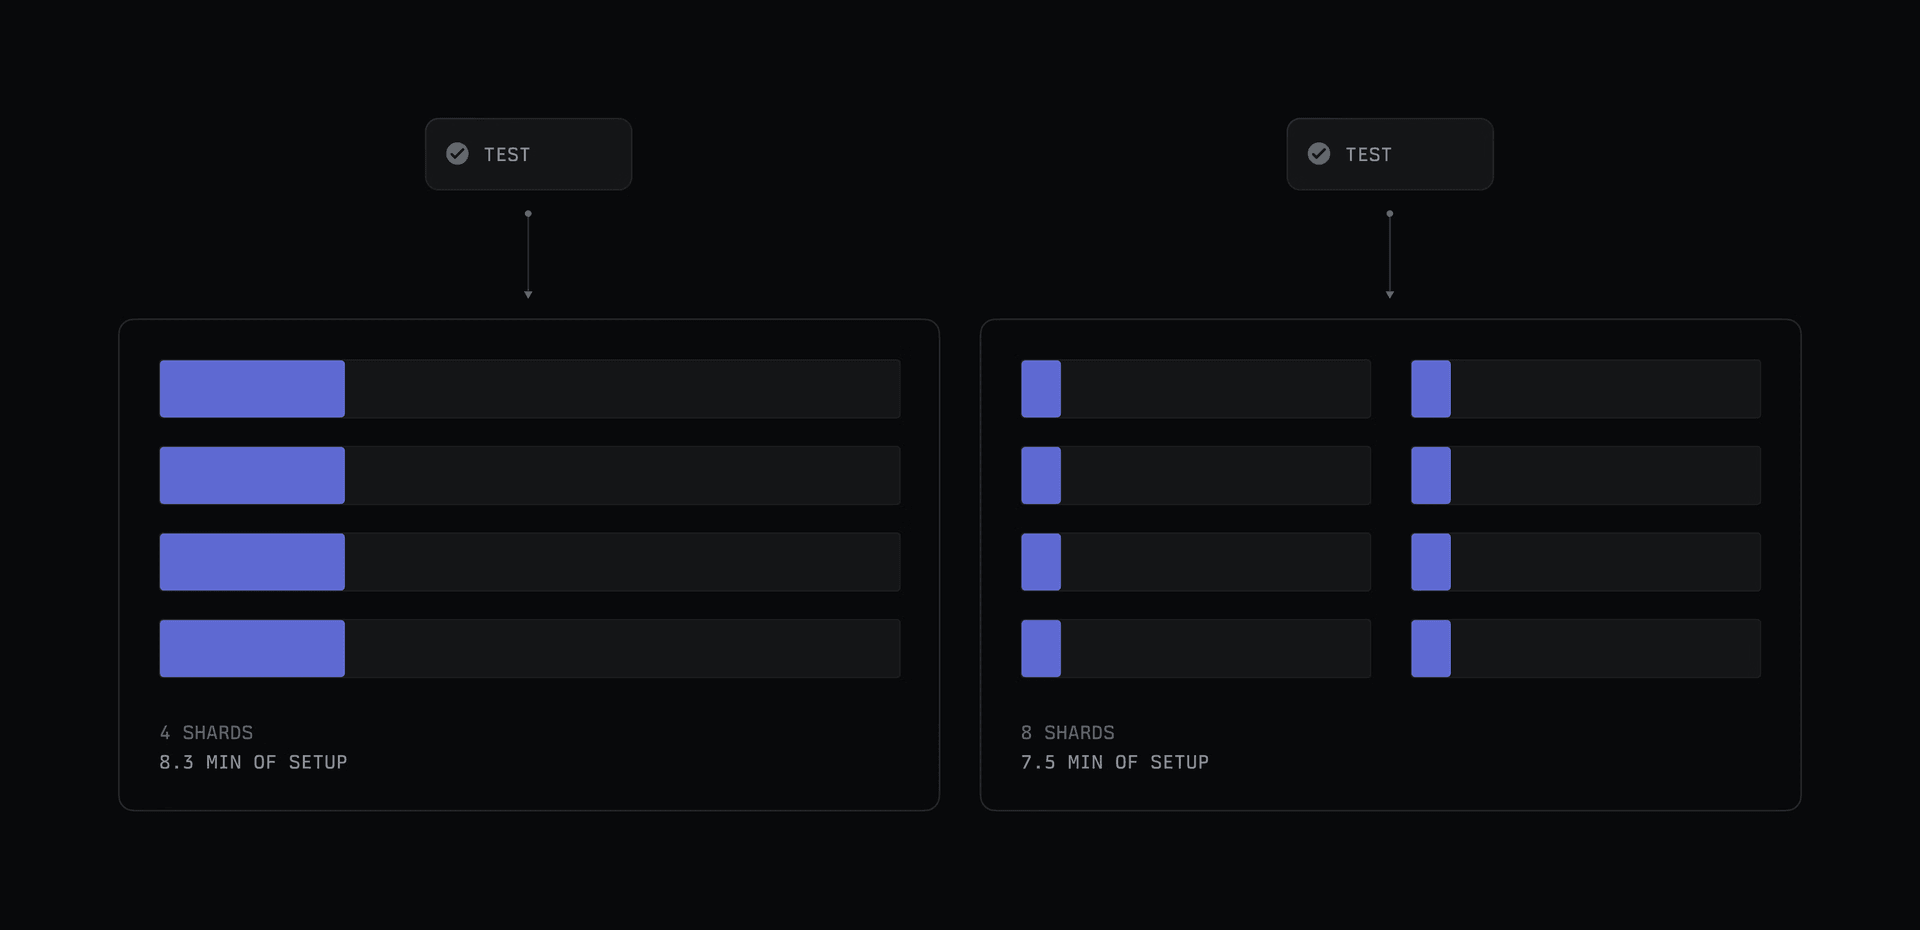
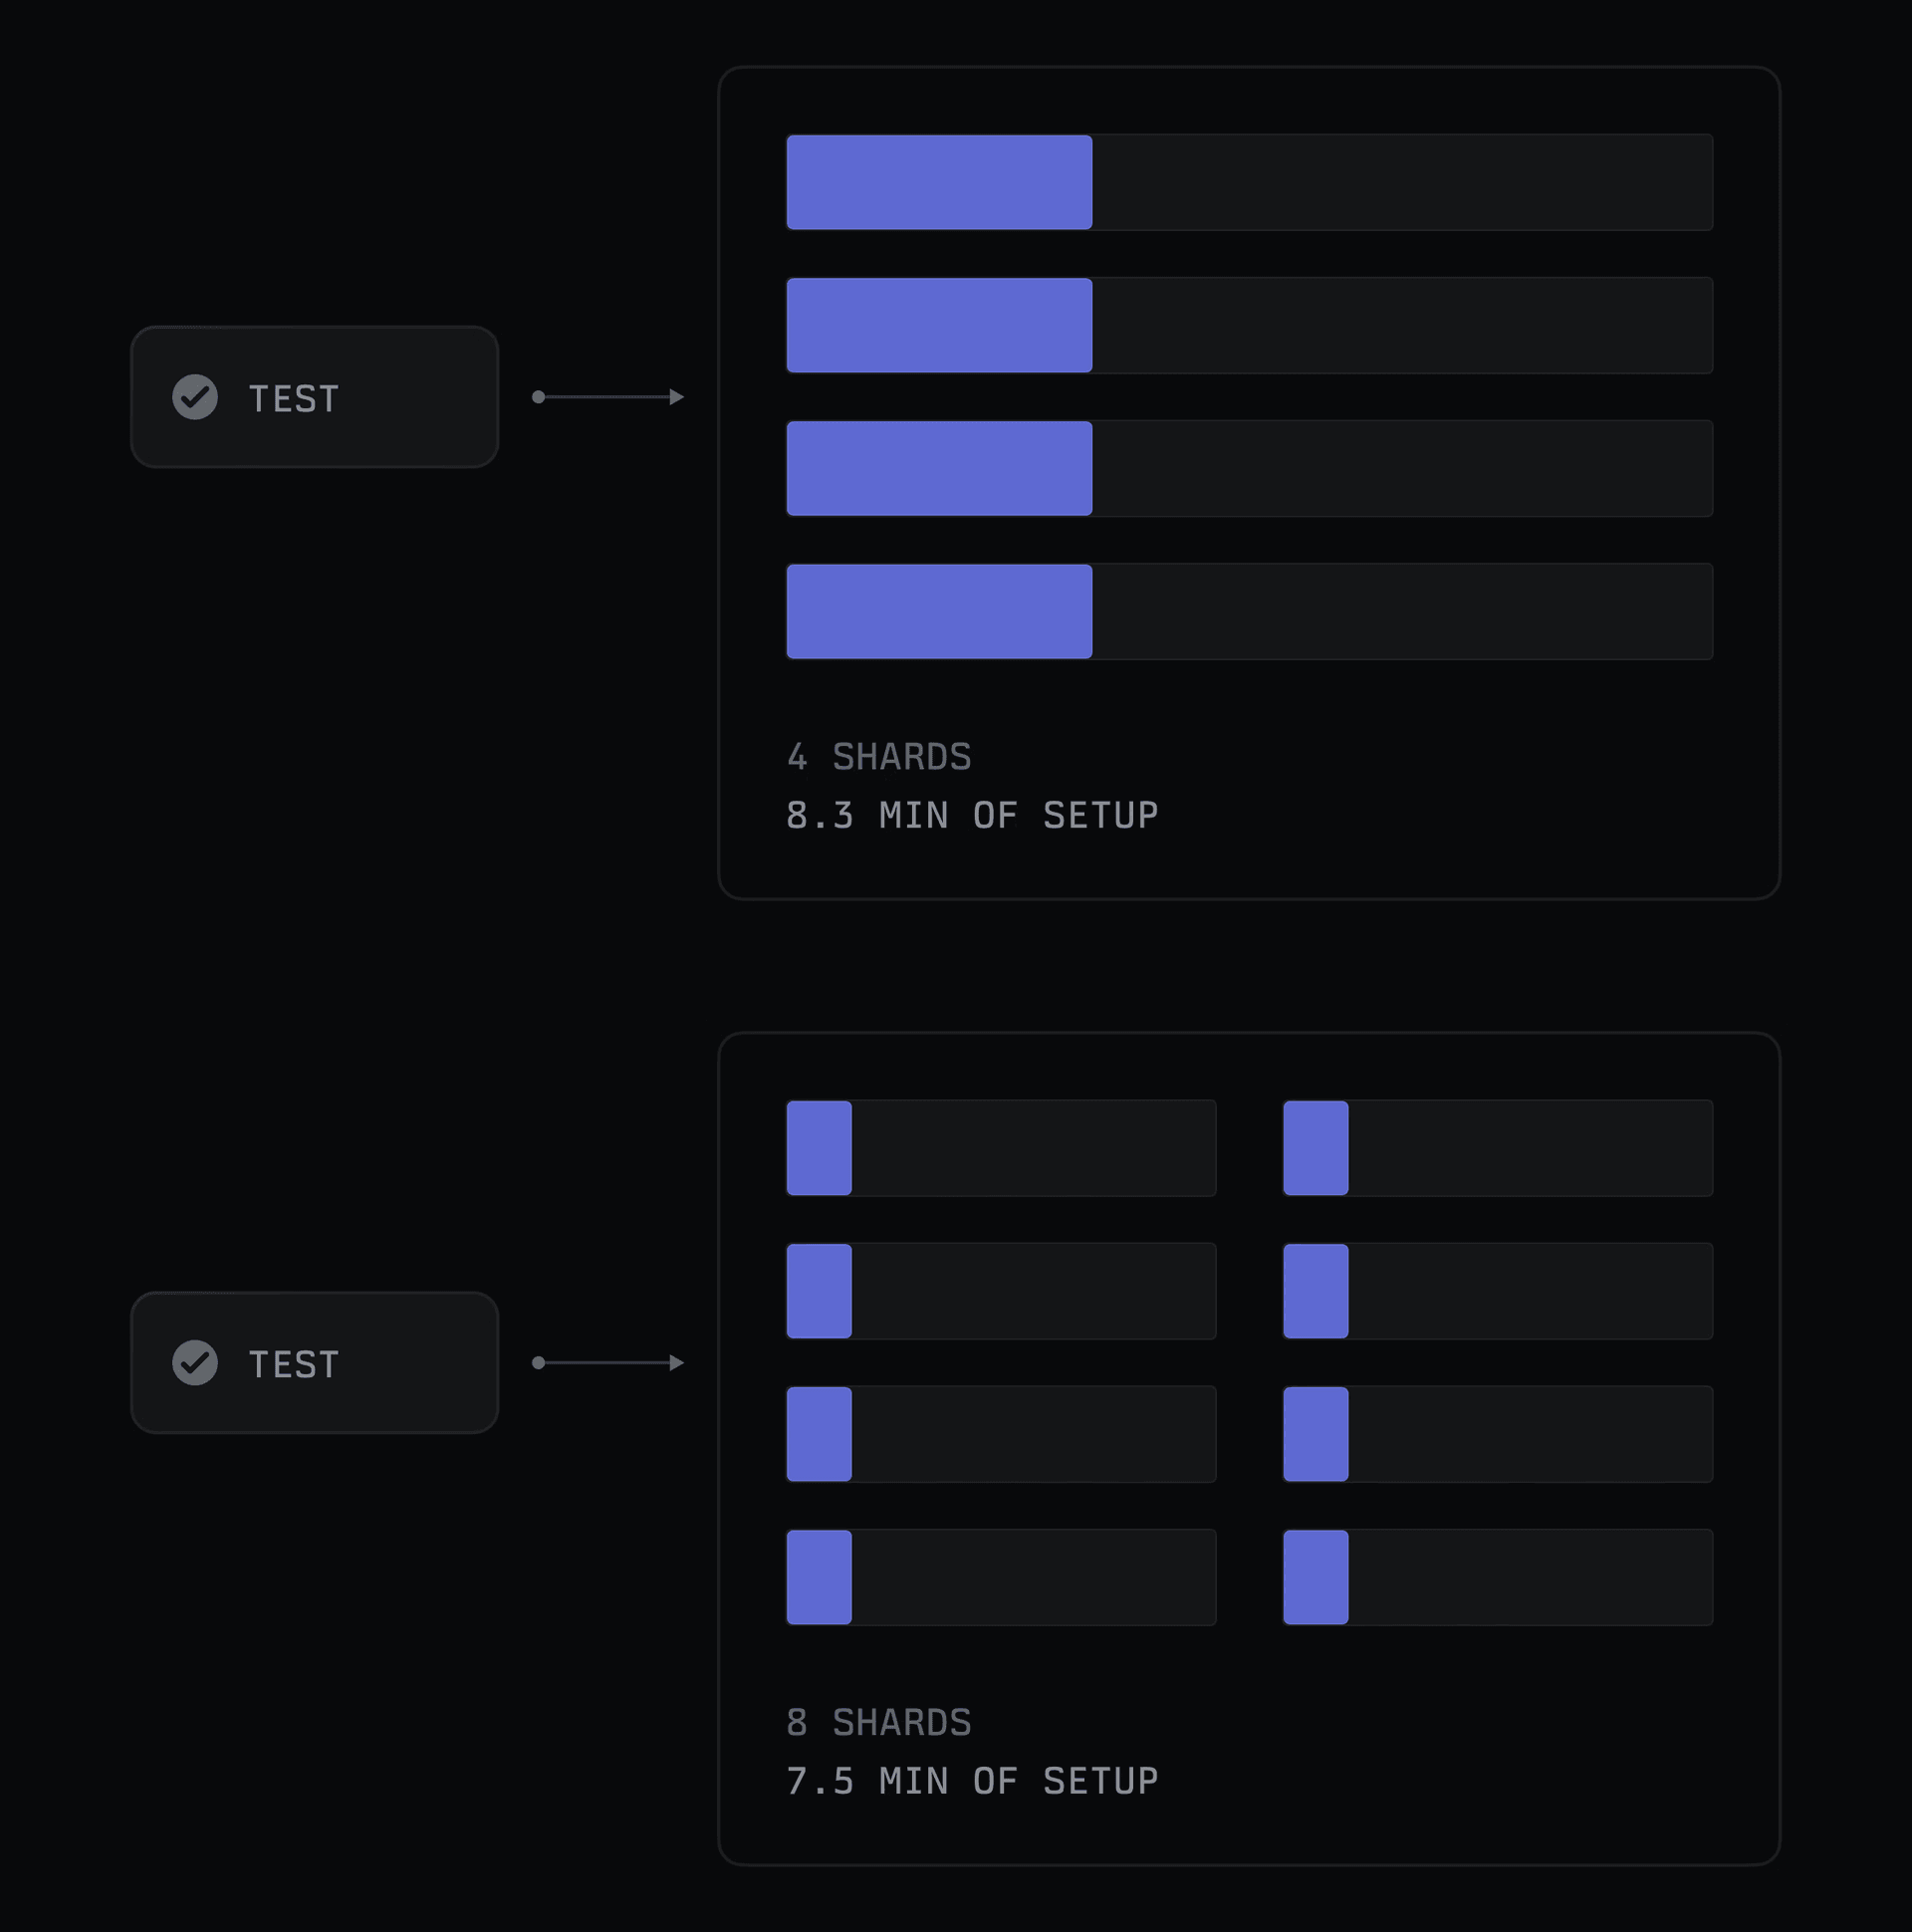
只有在每个分片的固定成本足够低的情况下,进一步分片才能带来收益——因为加倍分片数量也会让工作流的初始化时间翻倍。我们之前提到的初始化优化正是使八个分片变得可行的原因。如果每个分片需要 110-140 秒的初始化时间,八个分片光初始化就要花费 15-19 分钟的 runner 时间,比测试本身还长。现在初始化时间约为 40 秒,所以八个分片的总初始化时间比之前四个分片还少,同时将测试并行化的程度提高了一倍。
在初始化优化之前,测试作业使用 4 个分片并在初始化上花费 8.3 分钟。优化之后,我们可以运行 8 个分片而初始化时间仅需 7.5 分钟。
如果今年年初我们没有刻意努力改进 CI,当今的测试套件大约需要 11 分钟,是现在开发者等待时间的两倍。这项工作还没有结束。很显然,我们的代码库会继续增长;我们目前每周大约新增 2000 个测试。随着这种情况保持 CI 快速将是一项持续的工作,其中很大一部分将运用我们在这个过程中学到的方法来应对新的瓶颈。