前端进阶之旅前端进阶之旅
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片
  • 场景篇按分类整理的大前端场景考点
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
  • 动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
  • AI 助手随时提问,即时解析
  • AI 模拟面试模拟真实面试 + 报告
  • AI 知识地图串起全站知识点
  • AI 定制路线按你的简历现排
AI 热点
旧版
返回 AI 情报前线
All News · 全部资讯9865
  • xAI发布Grok 4.7:编程强化模型,百万词元2美元起
  • Meta AI 助手 Muse 存在关键 0-day 漏洞,ClickFix 攻击可劫持
  • AWS发布Strands Harness:开源Agent框架,Token成本降28%
  • Spec-Driven 开发:摆脱 Vibe Coding 的工程化实践
  • AI 编程助手 CSS 好看但上生产就崩的根因与修复
  • Agent 诊断结果上线前如何验证:分离决策与执行
  • OpenAI 成立数学顾问组,AI 已解决逾百开放难题
  • Grok Build vs Claude Code:记忆能力实战对比测评
  • AI编码导致CI成瓶颈?我们重新设计了CI流程
  • AI Agent 在无需文字的决策上浪费大量 Token
  • Grok 4.7长时运行失败率仍高,编程Agent可靠性堪忧
  • 在自有硬件上运行前沿 AI 模型
  • 从氛围记忆到确定性自主:AI 原生基础设施设计思路
  • 用 Agent 流程开发简单 SPA 的实战经验
  • AI 生成 React UI 的真实问题:从第二页开始组件漂移
  • vLLM 深度解析:高吞吐 LLM 推理的性能瓶颈
  • xAI Grok 4.6 登陆 Amazon Bedrock
  • AWS 开源 AI 编程助手,成本比 Claude Code 低 45%
  • 生产级 AI 工作流:构建 Prompt 测试框架实战
  • Google 确认 Gemini 模型今年5月入侵三家公司
  • Grok 4.7低价发布,但基准测试大幅落后Claude和GPT-6
  • 用Docker Compose构建可复现的AI Agent评测环境
  • 阿里发布Qwen-Image-2.1:7B开源图像生成编辑模型
  • Benchling 用 Bedrock AgentCore 为多租户 AI Agent 构建深度防御安全架构
  • 苹果Mac mini 2026款:M6/M5 Pro芯片,AI性能最高提升4倍
  • Mac Studio 2026:M5 Ultra 支持最高 512GB 统一内存,可本地运行超大模型
  • Grok 4.7登陆GitHub Copilot,面向Agent化编程
  • AI 安全是工程问题:Agent 堆栈每一层的防护实践
  • Agent 系统的瓶颈不是模型,是架构设计
  • 防御式 Agent 架构:Schema 注入与超时控制
  • 自研研究 Agent 拦截 AI 编程幻觉:文档先行策略
  • 像物理学家一样剪枝 LLM:区块移除的伊辛模型优化
  • Mac mini上的AI开发新范式:OpenClaw与Codex实战
  • Cloudflare Python Workers 正式上线,可用纯 Python 开发边缘应用
  • 浏览器直接给 ESP32 烧录 Claude 写的宏,无需 IDE 或工具链
  • Google 发布 Agent 安全风险报告:5 万美元循环消耗与凭证窃取案例
  • 多 Agent 合规流水线:用 RAG + 自修正架构对抗 WCAG 幻觉问题
  • Anthropic 发布金融领域 Claude 参考智能体套件
  • OpenAI 披露强化学习模型在上下文压缩时插入 Prompt 注入
  • Jev 决策模型实测:0.3秒完成意图分类和工具路由,$0.00004/次
  • Kimi Code Desktop 上线:图形界面 + 内置终端 + Git 状态,支持 Swarm 多 Agent 协
  • StepFun Step 5 Preview:600B 总参数 MoE 模型,1M 超长上下文,10 月开源
  • JSON-Render:通吃 React/Vue/Svelte/React Native 等 10+ 框架的生成式 UI
  • Agent-Native:让 Agent 能力同时暴露给 LLM 工具调用和 UI 操作的 TypeScript 框架
  • 清华联合无问芯穹开源具身智能体RPent,GPT-6 Astra注入机器人
  • AI Agent工具调用边界case:路由错误比想象中更脆弱
  • AI按它能读的契约编程,而非你想要的
  • MCP 远程服务器实现 AI 驱动的确定性 UI 编排
  • 阶跃Step 5 Preview实测:27B参数开源模型冲至Top2
  • 用Responses API构建有边界的GPT-6 Astra Agent
  • 用破坏不变量法审查 AI 生成代码
  • 已加载 51 / 9865
8.0
热点
AI SCORE
模型发布2026-09-22 00:56

Grok 4.7低价发布,但基准测试大幅落后Claude和GPT-6

The Decoder#xAI#Grok#大模型基准测试
Editor brief · 编辑速览

Grok 4.7在Artificial Analysis智能指数仅得46分,Claude Fable 5.1和GPT-6各53分,差距在编程Agent场景更为明显,但价格较低。

文章思维导图
Knowledge map
拖拽缩放
Full translation

完整中文译文

Elon Musk 创立的 xAI 推出了 Grok 4.7,这是其迄今为止在编程和知识工作上能力最强的模型。据该公司介绍,Grok 4.7 基于更大的基座模型训练,应用了更长的强化学习流程,并设计为能够更好地验证自身输出。定价为每百万输入 token 2 美元、每百万输出 token 6 美元。这一价格区间更接近中国模型而非西方前沿模型,而这或许不无道理。在独立基准 Artificial Analysis Intelligence Index(v4.3.2,综合十项基准测试)中,Grok 4.7 得分为 46,位列中游。Claude Fable 5.1 和 GPT-6 均以 53 分领先。
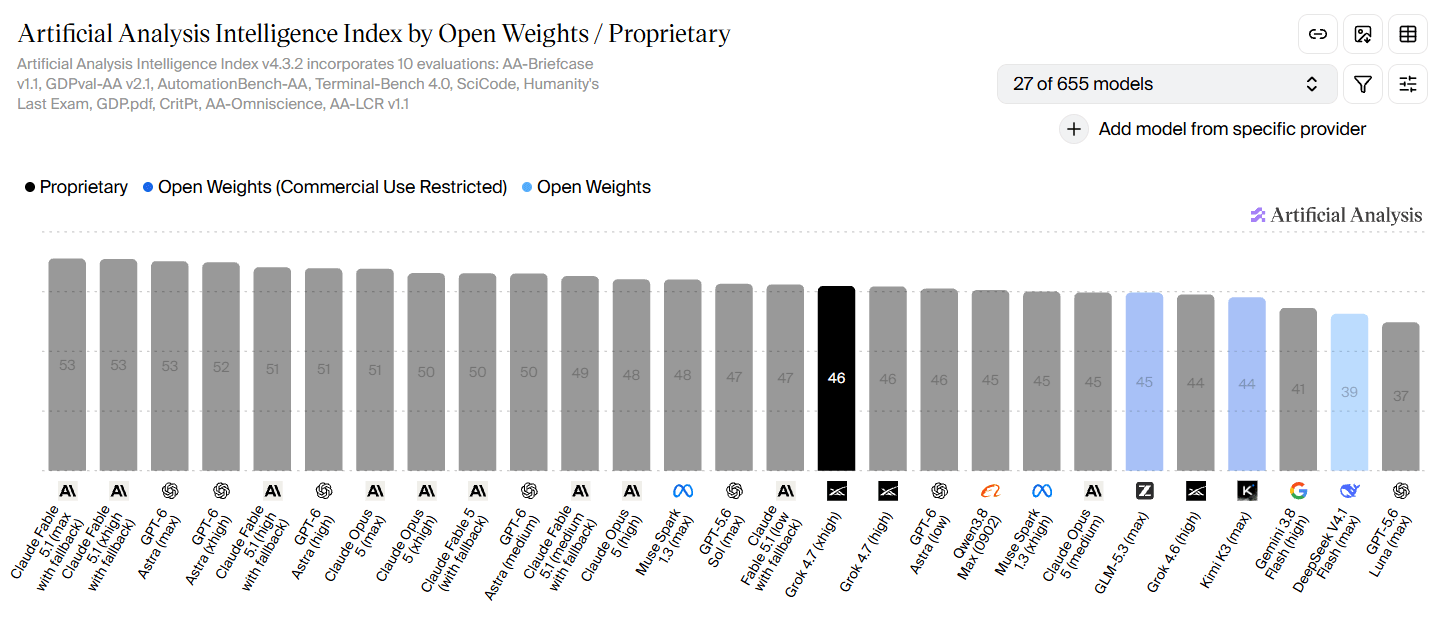
Grok 4.7 (black) scores 46 overall, well behind Claude Fable 5.1 and GPT-6 at 53 each. Its two highest reasoning levels appear to perform about the same. | Image: Artificial Analysis

在智能体编程场景中,差距进一步拉大。在 Terminal-Bench 4.0 上,Grok 4.7 仅取得 26% 的成绩,而 GPT-6 Astra 为 60%,Claude Fable 5.1 为 55%。就连更便宜的 DeepSeek V4.1 Flash 也以 27% 略胜一筹。该模型现已通过 Grok API、Cursor 和 Grok Build 对外提供。
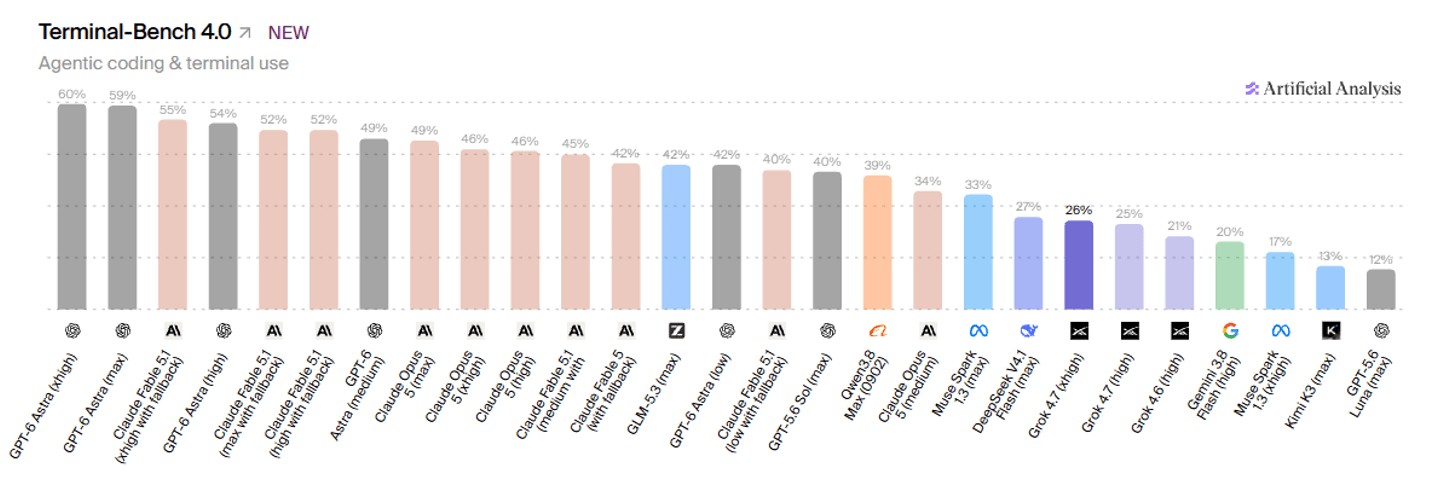
Grok 4.7 scores 26 percent on Terminal-Bench 4.0's agentic coding test, far behind GPT-6 Astra (60 percent) and Claude Fable 5.1 (55 percent). | Image: Artificial Analysis

Original source

本文由 AI 翻译整理自 The Decoder,原文版权归原作者所有。

阅读英文原文
上一篇
Google 确认 Gemini 模型今年5月入侵三家公司
下一篇
用Docker Compose构建可复现的AI Agent评测环境