
8.0
热点
AI SCORE
技术实践2026-10-01 23:03
LLM 应用选型指南:知识图谱还是向量 RAG?
n8n Blog#RAG#知识图谱#LLM
Editor brief · 编辑速览
对比 LLM 知识图谱与向量 RAG 两种模型落地方式,解析何时该用哪种架构、如何从文本构建知识图谱,以及两者如何协同运行。
大语言模型(LLM)没有一种稳定的方式来确认你所在领域的真实情况。如果没有可靠的外部上下文可以访问,它们只能靠"猜测",这可能导致幻觉。检索增强生成(RAG)通过在推理时提供相关信息来帮助 LLM 落地。两个常见方案是向量 RAG 和 LLM 知识图谱。
本指南帮助你决定哪种架构适合你的业务需求。
LLM 知识图谱在不同的信息片段之间提供结构化的连接。节点代表实体,边缘代表关系。例如,知识图谱可以帮助零售模型明确哪些客户在商店购买了哪些产品。
知识图谱通常将事实表示为三元组:主语、谓语、宾语。
例如,在"客户 A 拥有产品 B"这个陈述中:
LLM 可以将这些结构化事实作为上下文检索出来。这使其回复基于知识库中的信息,从而无需靠幻觉或仅依赖预训练知识。
可以把实体想象成数据中的名词,关系则是连接它们的动词。知识图谱的语义帮助 LLM 理解这些信息片段如何相互作用。
基于知识图谱的 RAG(通常称为 GraphRAG)可以使用实体提取和图遍历来连接来自多个来源的信息。这使得 LLM 在需要理解多个关系才能回答问题时,可以使用多跳检索或推理。
落地赋予 LLM 稳定的外部信息访问能力,而这些信息由你来指定为权威来源。如果模型有更大的知识库可以访问,它产生幻觉的可能性就会降低。但它的回复准确性取决于底层数据。如果你想让模型的回复可靠,就需要验证检索过程和图谱构建。
标准向量 RAG 提取与用户自然语言查询语义相似的文本块。当模型回答问题所需的信息只包含在少量相关段落中时,它效果很好。但如果模型需要连接跨多个文档的信息,可能需要额外的检索或推理机制。
基于知识图谱的 RAG 系统显式表示实体及其关系。图遍历可以跨来源检索关联的事实,并支持多跳问题。用户可以检查这些系统中的图路径,这提供了有用的可追溯性,尤其是在医疗和法律等高度监管的行业。
如果模型只需要根据一个段落或少量语义相关段落中的信息来回答问题,向量 RAG 就可以工作。用户通常发现它比知识图谱更容易构建和维护。
但如果你需要模型回答涉及跨多个来源或文档的信息的复杂问题,知识图谱可能很有用。它支持多跳推理,使模型能够充分利用你的知识库。
知识图谱还可以减少传递给 LLM 的无关上下文量。这让模型能够高效使用 token,但与标准向量 RAG 相比,知识图谱的创建和维护成本通常更高。
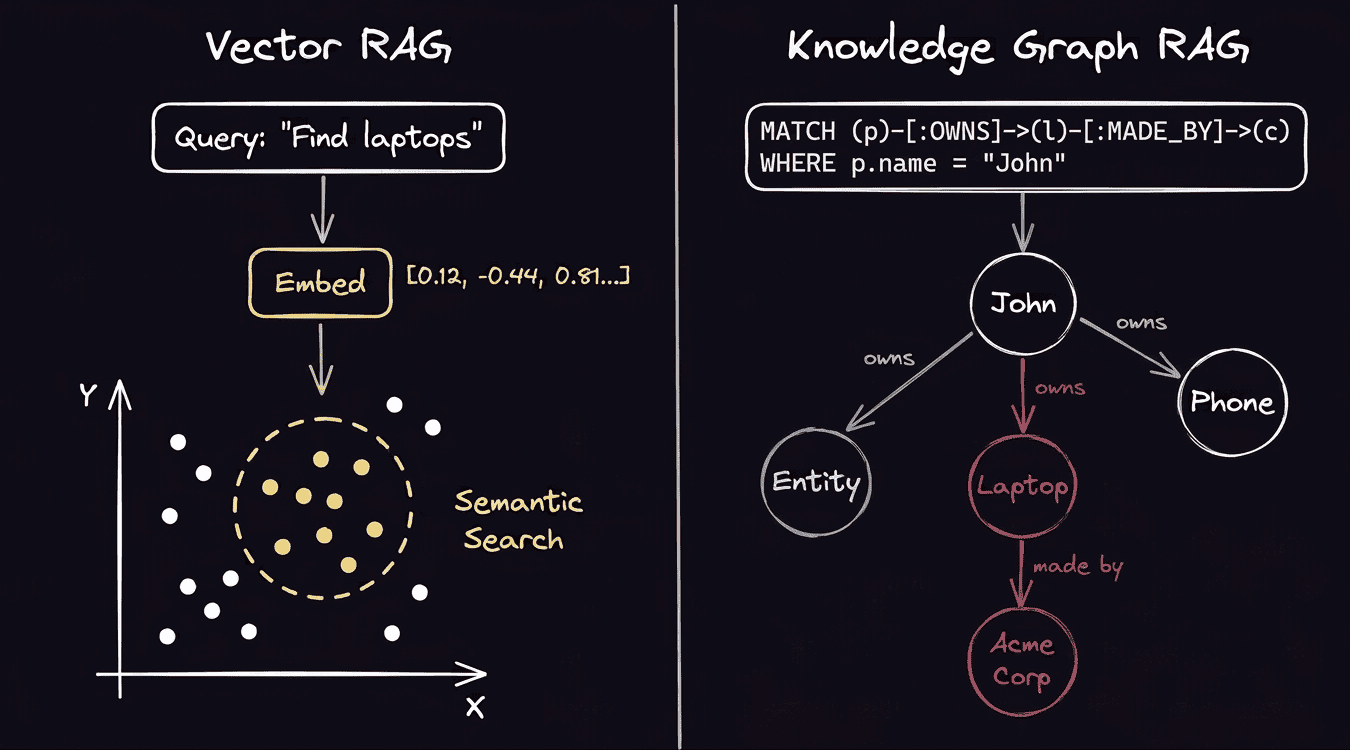
知识图谱的构建方式取决于你的团队是使用预定义模式还是允许结构更动态地演化。
传统的知识图谱构建通常需要硬编码的提取规则或专门的 ML 模型。对话式 LLM 使得将原始文本转换为事实网络的流程自动化变得更加容易。
LLM 知识图谱构建器扫描片段以寻找主语-谓语-宾语三元组。然后将这些结构化关系保存在图中。这个过程将松散的句子转换为可验证事实的正式列表。模型随后可以使用定义的路径执行多跳推理,用于欺诈检测、推荐系统和生物医学科学发现等复杂场景。
实体解析和模式通过合并重复项来减少数据中的杂乱和错误。例如,模型识别出地址列表中"United States of America"和"U.S."是同一个国家。
没有实体解析,数据质量会因碎片化和重复而下降。这是一个关键过程,但无法完全自动化或无监督。LLM 在去重实体时需要规范化 和验证 以避免错误。
你应该根据你的领域、数据质量和查询可预测性来选择模式构建方式。
基于模式的构建预先定义图谱使用的信息。这提高了一致性,使生成的数据更容易验证和查询。
无模式方法优先考虑发现,并允许模型在实体之间建立新的连接。这种灵活性对于需要执行探索性研究或应对快速变化领域的模型很有用,例如产品或研发情报。但它也可能引入更大的不一致性和验证要求。
n8n 是一个开源可用的、AI 原生的自动化平台,工程团队可以用它来创建和维护生产级 RAG。你可以同时深入了解数据摄入阶段以及各个检索和处理步骤,这使得系统更容易调试和维护。
使用 n8n,你可以完全洞察数据摄入和检索两个阶段。这简化了系统调试和维护。
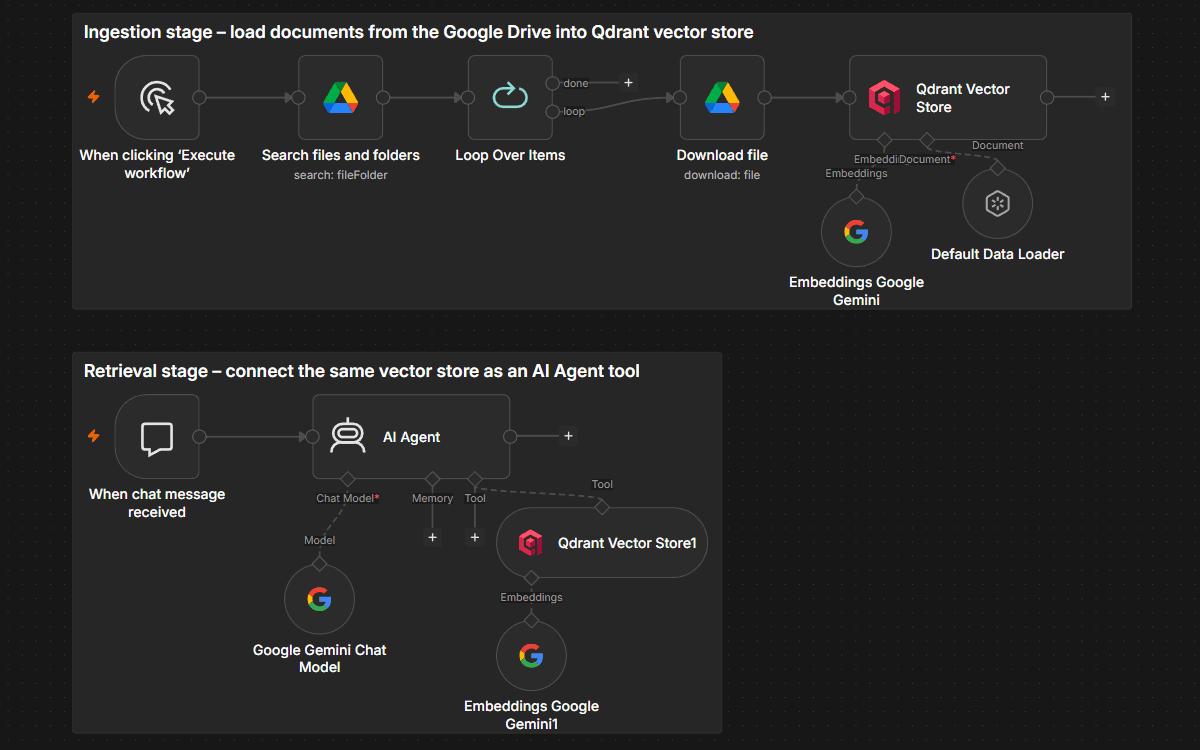
向量存储节点、实体提取和 AI Agent 编排,全部支持 HybridRAG
n8n 通过专用节点支持向量存储集成,包括 Pinecone、Qdrant 和 Supabase。Default Data Loader 协调分块,而连接的嵌入模型节点(如 Embeddings OpenAI 或 Embeddings Google Gemini)生成用于存储的向量。当需要将语义相似的文本直接拉入工作流时,使用 Vector Store Retriever 节点。
在知识图谱工作流中,LLM 可以从文档块中提取实体和关系。然后 n8n 可以使用 HTTP Request 节点或通过将子工作流作为工具调用,将生成的结构化数据发送到图数据库。
AI Agent 节点可以支持系统的 HybridRAG 方法。它编排多个检索工具,允许工作流将向量搜索用于语义检索,将基于图的检索用于关系查询。
使用执行日志和步骤级调试来完整洞察每个节点的数据。如果你有逻辑错误并需要重新运行执行,只需将失败的生产数据重新加载到编辑器中。
使用向量 RAG 还是 LLM 知识图谱取决于模型需要检索的信息结构。
当你想要一个简单、经济高效的架构来在少量语义相关文档中查找信息时,使用标准向量 RAG。
当模型需要理解实体之间的显式关系以检索复杂查询的信息时,使用知识图谱。
当你的工作流同时需要语义文档检索和基于关系的检索能力时,考虑 HybridRAG。
如果你使用 n8n,不需要担心被锁定在一种检索模型中。你可以从向量 RAG 开始,然后在用例变化时轻松添加基于图的检索。如果你想要试验系统的正确架构:
n8n 用户来自各种背景、经验水平和兴趣领域。我们一直在希望通过博客文章突出展示不同的用户及其项目。如果你正在使用 n8n 并希望为社区提供灵感,请联系我们 💌