
8.0
热点
AI SCORE
技术实践2026-10-01 21:30
何时用Graph RAG:当关系数据是证据链的一部分
The New Stack#Graph RAG#RAG#知识图谱
Editor brief · 编辑速览
解释在哪些场景下Graph RAG比普通RAG更有效,例如服务依赖关系、客户与服务的映射等需要多跳关联推理的场景。
哪个团队拥有依赖这个漏洞库的服务?哪些客户使用了那个服务,每个客户的合同要求你通知他们什么?
向量检索可以返回安全公告和服务描述,以及所有权页面或通知策略。每个结果都可能相关,但答案仍然可能缺少建立正确关系所需的上下文。
缺失的证据在于连接之中。服务的特定版本使用了这个库。该服务支持特定的客户环境。该客户当前的合同定义了通知窗口期。如果智能体必须从少数相似的段落中推断这些关系,它可能没有足够的证据将相关关系与相似但不相关的关系区分开来。
"当事实之间的关系是答案背后证据的一部分时使用它。"
这就是 Graph RAG 证明其额外工作量的合理性所在。在事实之间的关系是答案背后证据的一部分时使用它。保留向量检索,因为它在查找重要的文档和记录方面仍然非常好。当相似性本身无法证明为什么一个事实适用于另一个事实时,添加图。
向量检索最擅长的场景
向量检索查找语义与问题相似的文本或记录,即使它们使用不同的词汇。关于"终止订阅"的查询可以找到关于"账户取消"的支持文章。关于内存驱逐的问题可以找到将同一概念称为"上下文修剪"的论文。
这使得向量搜索成为一大类 RAG 应用的好选择。文档、支持文章、产品描述和其他非结构化知识通常在一两个段落中包含答案。数据主要是文本,问题范围有限,应用不需要在多个业务记录之间证明一条路径。
相似性在这种设计中有明确的职责:排序可能的证据。它不建立所有权、依赖关系、授权或策略范围。两条记录可能在语义上接近但没有操作上的联系。另一对可能直接相关但几乎不共享语言。
"相似度分数是对相关性的意见,而租户边界、生效日期或账户标识符是系统必须强制执行的条件。"
这就是为什么硬元数据约束必须独立于向量排序来强制执行。相似度分数是对相关性的意见,而租户边界、生效日期或账户标识符是系统必须强制执行的条件。当问题依赖于关系时,关系也值得同样的区分。
依赖关系的问题
一旦智能体超越自包含的知识库,关于连接系统的问题无处不在:
哪些服务依赖于此组件?
谁可以批准此账户的例外?
哪些客户受此部署影响?
哪些控制适用于此环境中的数据?
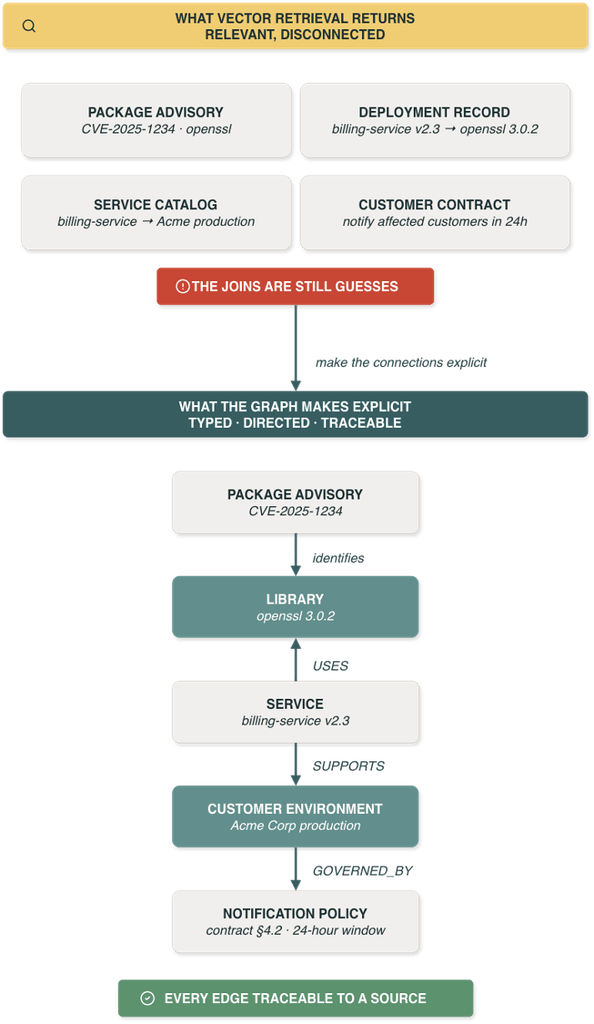
考虑漏洞示例。一个软件包公告识别出一个库。部署记录表明服务使用了该库。服务目录将服务连接到客户环境。合同记录将该客户连接到通知策略。答案需要四条记录和它们之间的三个关系。
文本可以描述每一步,但隐式组装链的智能体可能将易受攻击的库连接到错误的服务版本,或将共享服务与错误的客户关联起来。它还可能检索上个月已过期的策略,或错过在文档发布后更新到服务目录中的依赖项。
图通过将每条记录转换为节点使这些连接变得明确。类型化的有向边可以记录服务 USES 库或 SUPPORTS 环境。GOVERNED_BY 边将合同与策略绑定。每个连接都带有其来源和所有者,在这些细节重要时添加置信度分数或生效日期。
相同的四条记录作为相似段落在顶部检索,在下方作为类型化的、可追溯的边连接。
从回答重要问题的关系类型开始。映射整个公司是一条很长的绕路,无法保证到达有用的目的地。
Graph RAG 添加关系证据
Graph RAG 是一个被重载的术语。微软的 GraphRAG 使用 LLM 从非结构化文本中提取知识图谱,构建社区层次结构,并支持语料库级和实体级查询。本文指的是更窄的范围:从系统已经记录的关系构建的图,其中每条边都追溯到操作源,而不是从模型对文档的解释中推断。
该方法将内容检索与已知关系的遍历相结合。一种实用的流程首先找到问题的候选实体和段落。应用程序将这些候选解析到特定记录,只遵循允许的关系,然后检索解释结果所需的源文档。解析步骤是流程中最难的部分。关于"支付服务"的问题必须在目录中列出三个名称相似的服务时落到正确的记录上,而不正确的匹配会影响其后的每一跳。当匹配不明确时,应用程序应该显示候选而不是选择最接近的名称。
"图回答'什么被连接?'源材料回答'策略说了什么?'你两者都需要。"
图回答"什么被连接?"源材料回答"策略说了什么?"你两者都需要。从客户到合同的路径不包含通知条款,除非这些条款被建模在那里,而将每个段落复制到图中会在另一个真相版本上创建维护负担。
遍历也需要限制。指定请求可以遵循的边类型,它可以采取多少跳,哪个租户或账户边界适用,每个连接必须有多当前,以及可接受的置信度是多少。在结果到达模型之前,将这些限制作为查询和访问约束应用,而不是作为提示中的建议。
在遍历之前解析实体,在查询中强制执行限制,并在缺少必需的边时停止。
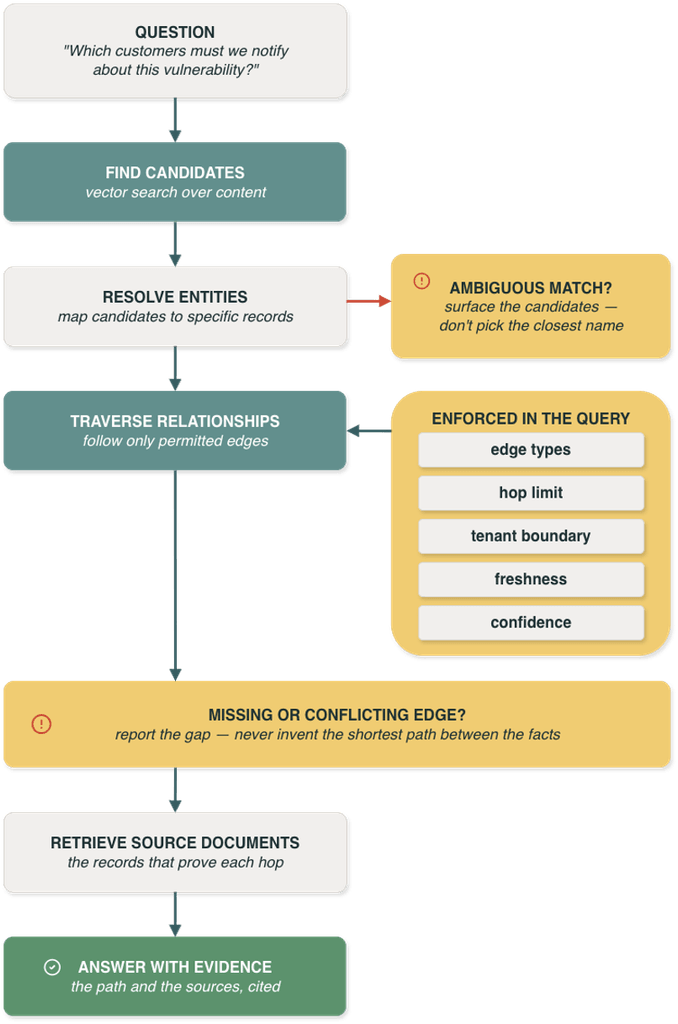
缺失的边也很重要。如果服务没有记录的所有者,或者两条记录对哪个合同是活跃的存在分歧,智能体应该报告该情况。它应该报告该情况,而不是在可用的事实之间推断路径。"我可以识别受影响的服务,但无法验证其当前所有者"是一个有用的答案。在事件期间得出不支持的结论可能会将通知发送给错误的客户。
因此,图需要一个所有者和一个定义的更新路径,就像它背后的操作数据一样。它的访问规则还必须保留足够的出处以进行审计历史记录。否则,你可能会将未记录的假设呈现为看起来权威的边。
将图保持在操作数据附近
许多关系已经存在于关系表中。外键将服务连接到团队。部署表将服务版本连接到环境。授权表将客户连接到产品。将这些事实复制到单独的图系统中会产生更新延迟和另一个权限模型。在每次调查期间也会留下一个不舒服的问题:哪个副本是当前的?
当图和向量搜索需要靠近它们所依赖的关系记录时,Oracle AI Database 可能是一个有用的选项。SQL 属性图可以在现有表和视图上定义,然后通过 GRAPH_TABLE 查询。AI Vector Search 可以在同一数据库中对相关文本进行排名。这让应用程序可以对当前业务数据使用图模式,然后在不将每次查找转换为跨多个存储的对账工作的情况下添加语义检索。
查询本身是普通 SQL。查找每个使用 OpenSSL 的服务以及这些服务支持的客户环境,是一次单一的模式匹配:
SELECT *
FROM GRAPH_TABLE (ops_graph
  MATCH (lib IS library WHERE lib.name = 'openssl')
        <-[IS USES]- (svc IS service) -[IS SUPPORTS]-> (env IS customer_environment)
  COLUMNS (svc.name AS service_name, env.customer_id AS customer_id)
);
决策规则比特定数据库更重要。该平台应该让团队检查智能体使用的确切路径,并在保护底层记录的相同访问规则下追溯每个节点和边到其来源。如果移动关系破坏了这些属性,那么副本会使答案更难验证。
为定义明确的问题选择 Graph RAG
在添加图之前问一个问题:答案是否需要跨实体连接事实、遵循依赖关系或证明为什么一条记录适用于另一条?
重复的多跳问题是一个强信号。由所有权、授权、依赖关系或策略控制的决策也是如此。由缺失或过时连接引起的事件提供了一个更清晰的起点,因为不支持路径的后果已经被理解。
自包含的知识库可能不需要 Graph RAG。单个文档通常可以回答问题的工作负载也不需要。而且,如果没有操作系统拥有这些关系,构建图不会解决底层数据问题。它可能只是在更漂亮的查询界面后面隐藏它。
"像评估它产生的散文一样仔细评估路径,因为流畅的响应可能不会揭示不完整的连接。"
先试点一个决策。影响分析是一个很好的候选:给定一个组件变更,识别受影响的服务和客户,然后引用建立每个连接的记录。授权感知支持是另一个:在检索支持指导之前,确定适用于账户的产品和策略。
使用已知的源数据并在构建之前定义成功。检查智能体是否解析了正确的实体并在允许的边界内遵循了当前的关系。验证检索的文档是否支持答案。像评估它产生的散文一样仔细评估路径,因为流畅的响应可能不会揭示不完整的连接。
更好的上下文需要更好的证据
只有当图提供智能体无法可靠地以其他方式检索的证据时,图才有用。从人们已经用来做决策的关系开始,然后证明使这些连接显式化可以改善结果。
向量检索仍然会找到公告和合同条款。图解释为什么它们属于同一个答案。如果智能体不能同时显示其结论背后的数据和连接,它应该传达剩余的不确定性。