
8.0
热点
AI SCORE
开源项目2026-10-01 23:34
Cloudflare 开源决策模型 Clef 与 RL 微调平台
Cloudflare Blog#Cloudflare#开源#强化学习
Editor brief · 编辑速览
发布轻量开源决策模型 Clef/Clef-flash,托管于 Workers AI,另推出 RL 微调平台支持自定义数据训练。
过去几周,决策模型(decision model)引起了广泛关注,比如 Typesafe AI 的 Jev System One 模型。分类模型(classifier model)早已存在,而 Jev 带来了一种全新的决策模型概念——能够以低成本、快速且稳定地生成有界的结构化输出,可以接入工作流中在需要决策的时刻调用。这类模型能力足够强大,能够在不持续重训练模型以纳入新分类类别的情况下,处理任意输入集合。这与大型语言模型(LLM)的世界形成了鲜明对比——LLM 在很大程度上是非确定性的,但其开放性足以支持智能体(agent)工作负载中的推理和文本生成。
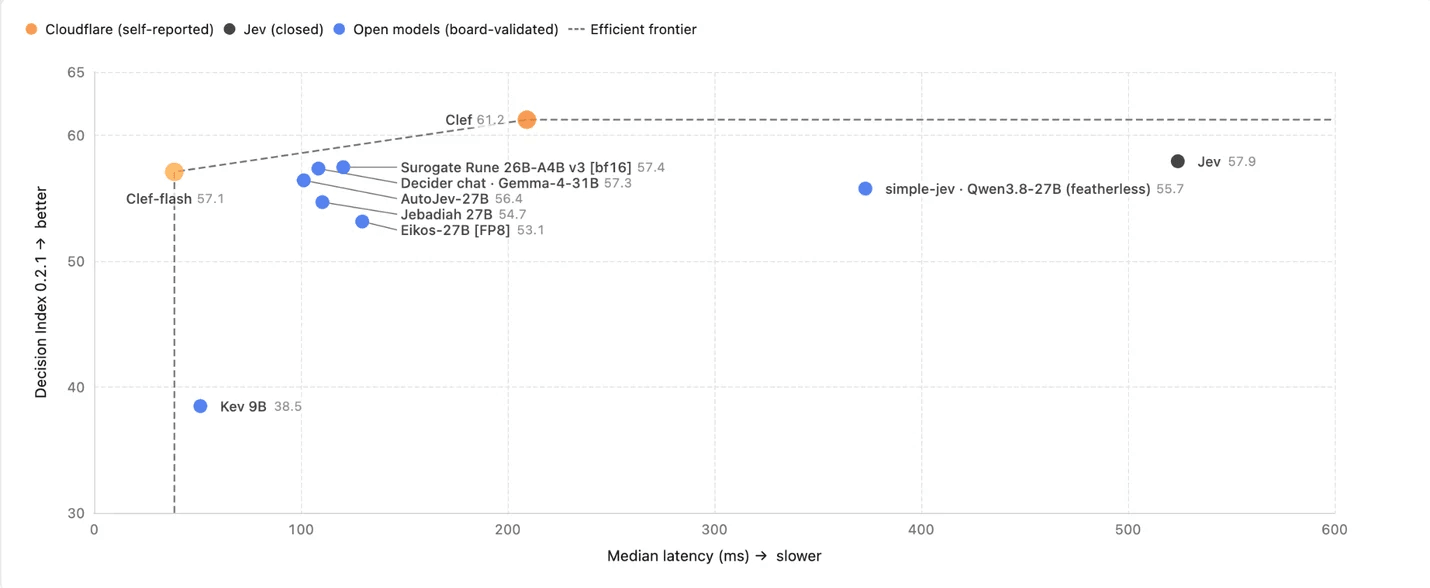
今天,我们发布两款 Cloudflare 训练的决策模型——Clef 和 Clef-flash,托管在 Workers AI 上。Clef 在 Jev Decision Index 评估中目前排名第一,你可以在实时基准测试演示站点上查看完整结果。这些模型更智能、更快速,且完全兼容 Jev API,让你能够轻松实验这些托管模型。我们已在 Hugging Face 上以 Apache 2.0 许可证完全开源这些模型,供你在本地运行和实验。
最后,我们很高兴推出全新的强化学习(RL)微调产品,让客户能够根据自己的用例对 Clef 进行微调。
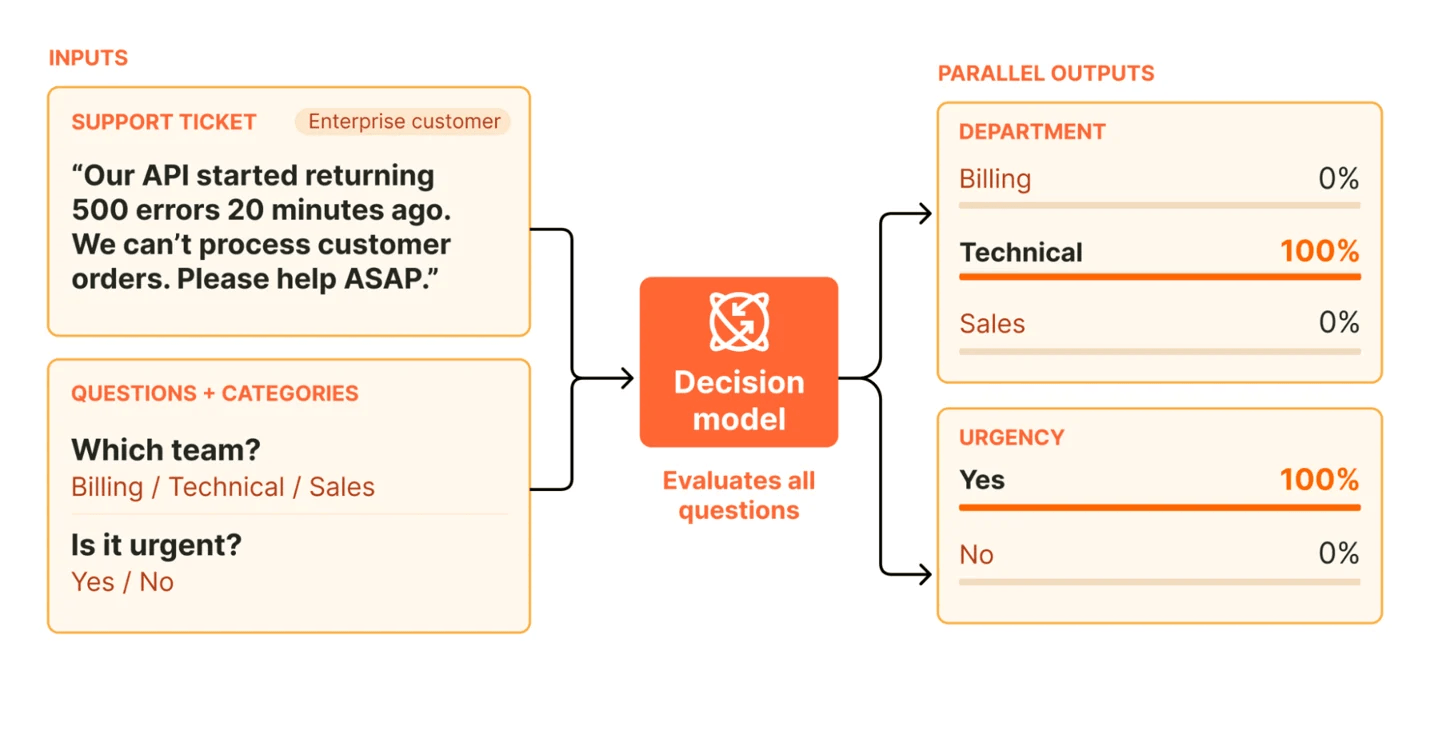
决策模型通过分类来帮助智能体决定如何行动,基于特定的概率。例如,你可以传入一条客户支持消息(输入),询问它是否紧急以及应该由哪个团队处理。决策模型会返回带有概率的类型化答案(输出),你的代码可以用这些结果来路由工单、触发升级或转人工处理。这意味着在智能体决策中,人类不再必须介入——智能体可以在程序上收集上下文、做出决策并对任务采取行动,或在需要时转给人工处理。
具体在 Cloudflare,我们一直在威胁情报团队中测试新的 Clef 模型,帮助我们对网站域名进行分类。通过向 Clef 提供一个域名(配合 Browser Run),它可以快速识别该域名所属的类别——例如,它可能以 95% 的概率将其分类为时尚网站,85% 为电商网站,低于 1% 为钓鱼网站。我们的 Clef 模型完成这个分类花了 2.2 秒来获取、渲染和分类网站。相比之下,我们最快的通用 LLM gpt-oss-120b 在同一工作流程中花了 4.7 秒,而且只返回了两个分类。作为用户,你可以想象 2 倍的延迟节省和更全面的结果如何帮助我们改进威胁情报工作流程,更快地识别恶意或合法域名。将这个能力泛化到任何需要快速程序决策的场景,你就解锁了强大的智能体工作流程,使其能够自主决策、推理和执行。
在音乐理论中,clef(谱号)是一个放置在乐谱开头的符号,为线条和间赋予特定的音高名称。决策模型类似于音乐中的谱号,因为它帮助定义上下文的域和后续的音符(动作)。我们选择 Clef 作为决策模型系列的名字,因为它有相似的作用,而且 CF 也呼应了 Cloudflare。
虽然市场上决策模型越来越饱和,但 Clef 有一些独特的特性,让我们很高兴将其公开发布。首先,它有一个视觉编码器,所以能够接收图像并对视觉内容进行分类。这与 Jev 不同,Jev 目前只做文本分类。其次,我们的模型有 64k 的上下文窗口(而 Jev 是 32k),这允许用户为模型提供更多的输入状态来进行分类。
第三,我们的模型准确且强大,在各种质量基准测试中与其他市场上的决策模型相比具有竞争力。我们精选了一些对决策很重要的评估(由 Jev Decision Index 定义),并对市场上一些较流行的模型进行了评分。查看下面的基准测试表格,或在我们的实时决策索引演示站点上查看分数:
Home appliances · case exact
CLINC150+OOS · macro-F1
Amazon ESCI · macro-F1
PhishNChips · accuracy
我们还在 Typesafe 自己的评估套件上运行了基准测试,我们的 Clef 模型表现良好,在 4 个领域中的 3 个击败了 Jev。值得注意的是,我们的 Clef-flash 表现异常出色,考虑到它快得多。
在我们运行的 43 个评估基准测试中,我们的 Clef 模型在延迟方面击败了决策模型(除了 Laya,它非常快但在上述基准测试中牺牲了质量):
除了模型本身的延迟优势外,我们的 Clef 模型托管在 Workers AI 上。因为它们托管在 Cloudflare 的基础设施上,我们能够利用边缘的 GPU,带来低网络延迟和更快的决策。这意味着你可以将 Clef 放入智能体的热路径中进行决策,并与我们 Workers AI 上的一个 LLM 结合来采取行动。
curl https://api.cloudflare.com/client/v4/accounts/$CLOUDFLARE_ACCOUNT_ID/ai/run/@cf/cloudflare/clef \
  -X POST \
  -H "Authorization: Bearer $CLOUDFLARE_AUTH_TOKEN" \
  -d '{
    "model": "clef",
    "state": "Checkout has been failing for every customer for the last hour.",
    "questions": {
      "urgent": { "type": "noul", "instructions": "Is this support request urgent?" },
      "team": {
        "type": "choice",
        "instructions": "Which team should handle this request?",
        "criteria": {
          "billing": "Payments, invoices, and refunds",
          "technical": "Outages, errors, and configuration",
          "sales": "Plans and upgrades"
        }
      },
      "severity": {
        "type": "score",
        "instructions": "How severe is the customer impact?",
        "criteria": ["No impact", "Minor", "Major", "Critical"]
      }
    }
  }'
Clef 还产生与 Jev 类似的严格类型化输出,并且完全 API 兼容,所以你可以非常容易地进行切换。较大的 Clef 模型是你的更强大的精确模型,而 Clef-Flash 模型非常适合对延迟敏感的决策。这些模型已为企业做好准备,我们保证不会读取、存储或训练你的请求或响应(除非你想使用我们的微调产品,我们在下面会介绍)。你今天就可以开始使用 Clef 模型,先从我们的开发者文档开始,或者在 Hugging Face 仓库上玩玩开源模型。
如果你想帮助调优 Clef 以适应特定工作负载,我们也提供微调服务——首先是作为我们的前线部署工程师(FDE)团队的实践合作伙伴,然后是作为自助微调平台,让客户能够在 Cloudflare 上训练和重新部署模型。
在 Jev 发布的同一周,我们发布了一些关于我们自己开发的决策模型的实验。我们的演示深入介绍了我们如何调整 DiffusionGemma 模型,通过暴露大型语言模型生成的 logprobs 来输出确定性概率。我们最初的方法建立在 Matt Mastracci 的独立研究之上,他一直在机器学习(ML)社区中活跃,分享新想法并向 vLLM 推理引擎提交 pull request,以使 DiffusionGemma 支持更强。
Clef 在这个概念基础上构建,但使用不同的基础模型作为骨干。我们目前使用 Qwen 作为基础模型,并对其进行后训练以适应决策模型的用例。在推理过程中,Clef 对 Qwen 进行仅 prefill 的传递,然后并行对有效的模式选择进行评分。决策步骤是非自回归的,因此没有中间文本需要逐 token 生成,这使得 Clef 比自回归 LLM 快得多。与其生成中间文本来产生结构化答案,Clef 和 Clef-flash 直接从内部骨干表示中导出模式选择。这种方法依赖于专门的两阶段注意力路由过程:每个有效选择都会提取与提示相关的上下文,允许单个字段参数与其他字段交叉关注,并在评分前回到原始 payload。通过利用词汇先验,模型在选项之间保留语义意图。最终,架构将选项特定证据路由、联合交叉字段注意力和模式绑定评分统一起来。
通过冻结 Qwen3.8-27B 用于 Clef 和 Qwen3.5-9B 用于 Clef-flash,我们联合优化了路由头和 rank-256 低秩适配器。我们的后训练利用标签平滑交叉熵来处理有效模式输出,并结合 Brier 损失来改进概率校准。这项训练利用我们自己的内部合成数据集,对字段顺序、提示和模式结构进行排列组合。我们还开发了用于校准决策的强化学习(RLCD)作为二级优化目标,对相邻的有序选择给予部分信任,对完全精确的记录输出给予奖励,并对参考模型应用惩罚以防止分布偏移,这为我们提供了更好的准确性和泛化能力。
这意味着我们能够用 Clef 实现几个创新:提高了模型在分类中的准确性,约束其只输出概率而不是文本生成,并且使其比 Jev 和基础 Qwen 模型更快。
我们听到了很多内部用例,需要将我们的 Clef 模型微调以集成到 Cloudflare 的智能体工作流程中。例如,内部团队想要一个分类模型来评估 Trust & Safety 提交,帮助我们分类 Cloudflare Support 请求,甚至集成到我们的 Bot 产品中,以判断爬虫是好爬虫还是坏爬虫。
这些用例非常具体,我们有多年的标签决策数据可用于训练特定的分类器。当你微调模型时,你可能会牺牲一些通用性能,以换取特定领域更高的准确性。因为 Cloudflare 拥有超过 15 年跨不同领域的网络数据,我们可以微调模型以适应这些特定用例,这比我们的通用 Clef 模型更准确更快。我们正在与内部团队合作,研究如何后训练 Clef 以创建强大的 ML 模型,提升我们在 Cloudflare 的影响力和改进工作流程。这些内部团队和用例是我们新 FDE 微调团队和强化学习(RL)产品的下一个任务。
我们提供一项服务,通过我们的实践 FDE 团队帮助客户微调 Clef 以适应其工作负载。从那里,我们将从实践经验中学习,构建一个自助服务平台,让客户能够捕获数据、微调和重新部署模型,全部在 Cloudflare 上完成。
这实际上是酝酿已久的——我们一直在构建我们的 AI 平台,以具备正确的原语(primitives),这样我们就可以构建自定义 RL 产品。Jev 引发的兴趣表明需要一个快速、小型、特定的分类模型,我们选择这作为开始实验 RL 环境的利基市场。
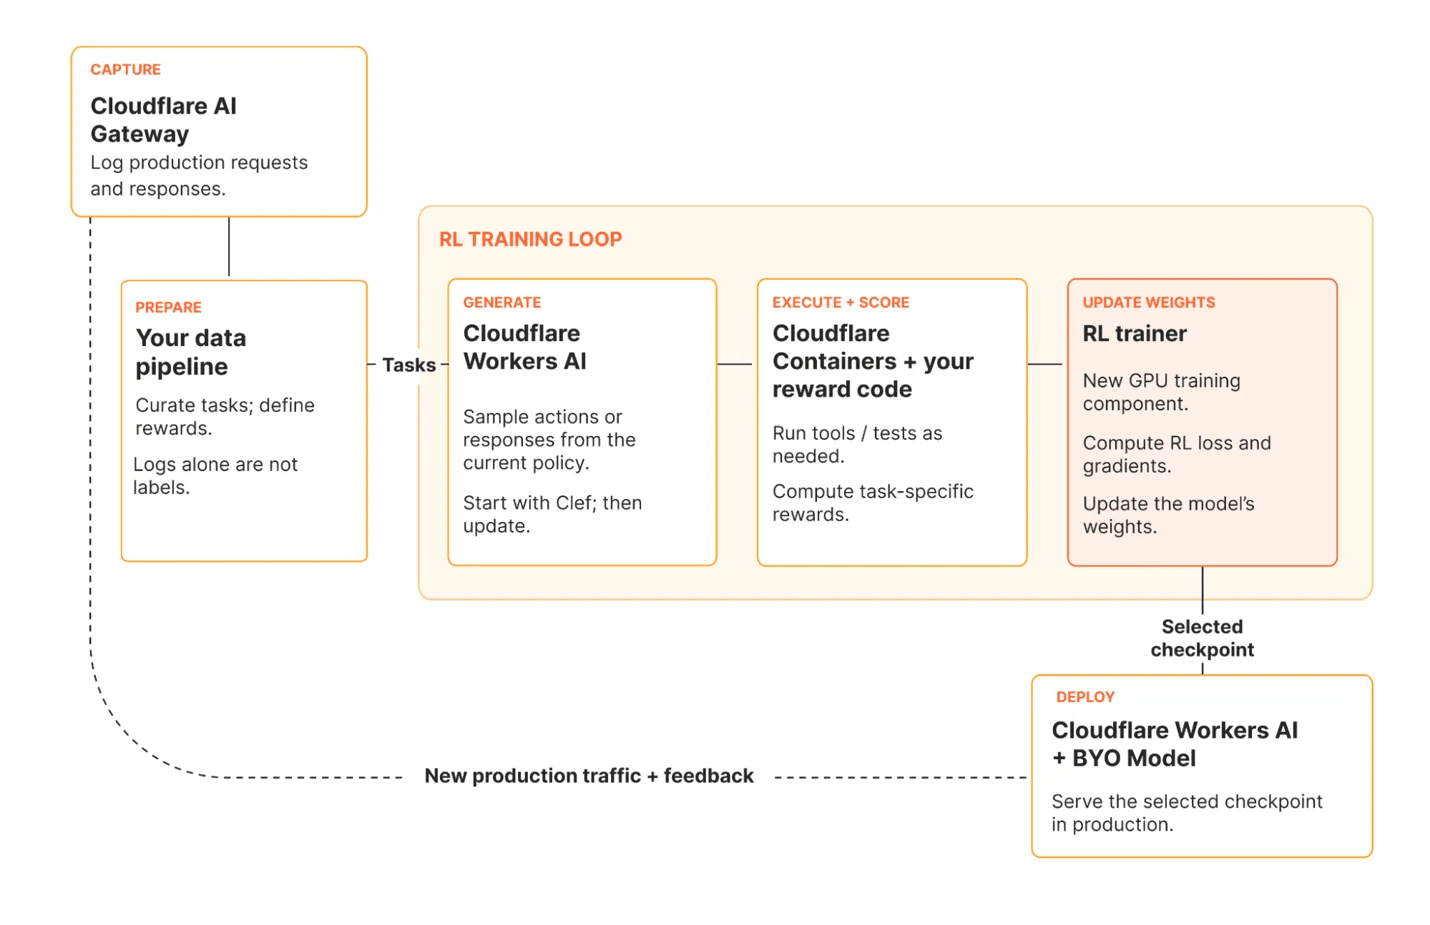
为此,我们利用已经在 Cloudflare 平台上构建的原语:
Cloudflare AI Gateway – 传递你所有的 AI 流量通过 AI Gateway,自动为你创建一个针对你用例的请求数据集
Cloudflare Workers AI – 针对基础 Clef 模型生成 rollout
Cloudflare Containers – 用于评分和回放智能体操作的 RL 沙箱
[NEW] Trainer – 更新微调 Clef 模型的权重
Cloudflare Workers AI + BYO Model – 在 Workers AI 上重新部署微调模型
这结合了我们一直在开发的 AI 平台的几个进行中的部分,包括捕获你 AI 流量的 AI Gateway 以便你利用自己的请求/响应数据、用于 RL 沙箱的 Containers,以及自我们收购 Replicate 以来一直在推进的 Workers AI 的自带模型(Cog)工作。
我们很高兴今天从 Workers AI 团队推出首个 Cloudflare 训练的 ML 模型。我们仍处于早期阶段,还有很多改进要做,但这很好地展示了我们 AI 平台团队所做的艰苦工作。我们相信 Clef 有能力颠覆我们使用智能体的方式,这自然契合 Cloudflare 成为智能体云(agent cloud)的使命。
如果你有特定的用例并且已经是这些产品的客户——我们很乐意与你交流,并在我们在这个领域实验时成为设计合作伙伴。
尝试托管在 Workers AI 上的 Clef 模型,如果你想自己探索,可以在 Hugging Face 上下载权重,如果你有微调用例需要我们帮助,请联系我们。
我们的 ML 团队一直在提升影响力,从模型优化到模型训练研究。如果你有兴趣加入我们的使命,看看我们的空缺职位。