
8.0
热点
AI SCORE
技术实践2026-10-01 11:00
Magnitude:面向自主Agent的自优化推理引擎设计
dev.to · AI#Agent#推理优化#架构
Editor brief · 编辑速览
指出静态推理对Agent多步推理链的低效,提出动态KV缓存复用、推理token节省等优化,介绍了面向Agent的推理栈重构思路。
自主 Agent 在生产环境中频频折戟,问题根源不在于 Prompt 写得不够好,也不在于模型本身不够聪明,而是静态推理对每一个 Token 一视同仁地分配算力,这套逻辑从根本上就是错的。当你部署一个处理复杂推理链、工具调用和递归调试的多步骤 Agent 循环时,标准的 LLM 服务引擎把每一次生成步骤都当作一张白纸来处理——它们盲目地重新评估静态 KV Cache,对重复的中间推理 Token 浪费计算资源,而且在连续的 Agent 步骤之间完全缺乏上下文反馈循环。这就是我们在构建复杂的网页爬虫和软件工程 Agent 时撞上的那堵Scaling墙,它迫使我们从底层硬件开始重新思考推理栈。
大多数工程团队把推理优化当作一个已解决的问题,因为 vLLM、TensorRT-LLM 和 TGI 已经让原始模型的Serving变得快速且易用。你起一个 Endpoint,接入 OpenAI 兼容的客户端,看着 Tokens-per-second 指标在 Grafana 仪表盘上亮起来,就觉得一切OK了。但Serving 静态文本补全基准测试和Serving 自主 Agent(每个用户请求要执行数百个相互依赖的推理循环),完全是两码事。当你的 Agent 进入递归调试循环或解析大规模的 JSON 工具输出时,标准服务引擎把每一步都当作一次孤立的冷启动事件来处理。
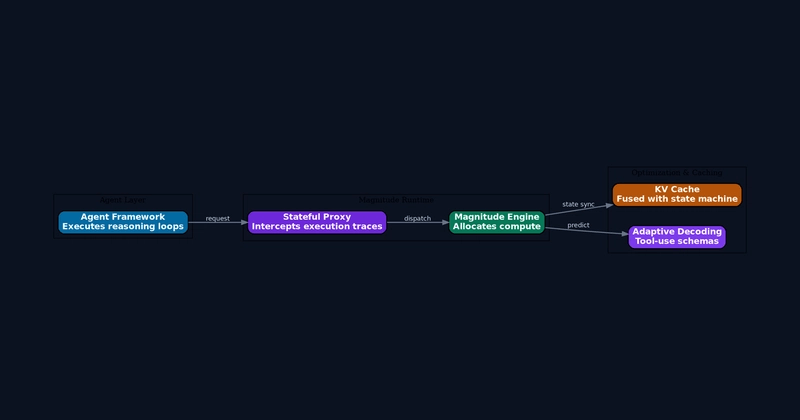
上图:本文涵盖主题的高层次架构概览。
这里的隐性成本不只是金钱上的,而是积小成多的延迟死亡。每次 Agent 发起一次工具调用,整个对话历史、系统 Prompt 和中间思考日志都会被重新分词并重新通过注意力层处理,哪怕 90% 的上下文相比上一次迭代根本没有变化。我们观察到,一旦 Agent 开始处理深度上下文窗口,首 Token 时间(time-to-first-token)从 200 毫秒飙升至超过 4 秒。RadixAttention 等标准缓存层确实有助于前缀缓存,但它们完全是被动的——它们不会主动剪枝死胡同推理路径,不会根据 Agent 的置信度分数动态调整精度,而且完全忽略调用它们的 Agent 框架的结构性意图。
如果你忽视这种架构错位,你的生产 Agent 将撞上经济可行性和速度的玻璃天花板。用户会放弃一个简单文件编辑需要 30 秒才能解决的workflow,而你的云账单会随着 Agent 的幻觉而非有效工作线性增长。我们意识到,要让 Agent 真正自主化并可用于生产,推理需要在运行时层面具备上下文感知能力、有状态和自优化。这个核心认知就是我们构建 Magnitude 的原因,也是我们将核心引擎栈开源给 Agent 工程社区的原因。
为了解决 Agent 推理瓶颈,你必须在 Agent 框架和 LLM 执行运行时之间架起桥梁。Magnitude 没有把推理引擎当作一个黑盒 HTTP 服务器,而是引入了一个有状态代理层,该代理层拦截 Agent 执行轨迹,在运行完整的多头注意力之前预测 Token 延续置信度,并根据步骤的语义密度动态分配算力。当 Agent 正在执行一个确定性的代码执行块时,它不需要与开放式的创意头脑风暴步骤相同的注意力解析精度。通过将 KV Cache 生命周期与 Agent 的状态机直接融合,我们可以完全消除冗余的预填充阶段。
我们发现的另一个突破是针对工具使用模式定制的自适应投机解码。Agent 频繁输出遵循严格句法语法的结构化 JSON 或特定函数签名。通过在 Token 采样循环中直接注入语法约束解码,同时运行一个在历史 Agent 执行日志上训练的轻量级草稿模型,我们在复杂多步推理轨迹上实现了 3.4 倍加速,且不牺牲输出准确性。引擎从每一次失败的 Agent 运行中学习,在后台异步优化其内部权重和路由策略。
在研究如何将其接入自定义 Agent 流水线之前,我们先来看一下核心引擎初始化和上下文桥接的实际样子。以下是一个生产级 Python 实现,展示了如何启动 Magnitude 运行时客户端并将其附加到启用了动态缓存的异步 Agent 执行循环。
import asyncio
import os
from typing import Dict, Any, List
from magnitude_engine import MagnitudeClient, AgentRuntimeConfig

async def initialize_agent_pipeline() -> MagnitudeClient:
    """Initialize the Magnitude self-optimizing inference runtime client."""
    api_key = os.getenv("MAGNITUDE_API_KEY", "mag_live_mock_key_9981")
    endpoint = os.getenv("MAGNITUDE_ENDPOINT", "http://localhost:8000/v1")

    config = AgentRuntimeConfig(
        max_batch_size=32,
        enable_predictive_caching=True,
        speculative_decoding_enabled=True,
        draft_model_path="magnitude-1b-instruct-draft",
        target_model_path="meta-llama/Llama-3.3-70B-Instruct",
        optimization_target="latency_and_cost"
    )

    client = MagnitudeClient(endpoint=endpoint, api_key=api_key, config=config)
    await client.verify_runtime_health()
    return client

async def execute_optimized_step(client: MagnitudeClient, session_id: str, prompt: str) -> Dict[str, Any]:
    """Execute a single agent reasoning step using dynamic runtime optimization."""
    response = await client.generate_optimized(
        session_id=session_id,
        prompt=prompt,
        temperature=0.1,
        max_tokens=1024,
        stop_sequences=["</tool_call>", "Observation:"]
    )
    return response

if __name__ == "__main__":
    client = asyncio.run(initialize_agent_pipeline())
    print("Magnitude inference runtime successfully initialized and optimized.")
这段代码使用生产参数初始化了异步 MagnitudeClient,开箱即用地设置了预测性前缀缓存和投机解码配置。execute_optimized_step 函数通过我们的有状态会话管理器传递执行轨迹,确保重复的 Prompt 前缀和工具定义在 GPU 块级别缓存,而不是在每个 Agent tick 上重新计算。
将自优化推理引擎集成到现有 Agent 架构中需要从无状态 API 调用转变为有状态的会话驱动模式。我们将逐步构建一个具备弹性的 Agent 循环,利用 Magnitude 的动态 Prompt 剪枝和运行时反馈钩子。
首先,你需要配置 Agent 框架将执行状态更新流式传回推理引擎。这使得引擎能够在 Agent 完成下一个工具调用参数的构思之前预测下一个 Token 分布并预分配 KV Cache 块。
import logging
from dataclasses import dataclass
from magnitude_engine import MagnitudeClient

logging.basicConfig(level=logging.INFO)
logger = logging.getLogger("MagnitudeAgent")

@dataclass
class AgentExecutionContext:
    session_id: str
    task_goal: str
    iteration_count: int = 0
    max_iterations: int = 10

class SelfOptimizingAgentRunner:
    def __init__(self, client: MagnitudeClient, context: AgentExecutionContext):
        self.client = client
        self.context = context

    async def step(self, current_observation: str) -> str:
        """Execute a single loop iteration with telemetry feedback."""
        self.context.iteration_count += 1
        logger.info(f"Running iteration {self.context.iteration_count} for session {self.context.session_id}")

        prompt = f"Goal: {self.context.task_goal}\nObservation: {current_observation}\nThought:"

        result = await self.client.generate_optimized(
            session_id=self.context.session_id,
            prompt=prompt,
            temperature=0.2,
            track_feedback=True
        )
        return result["text"]

    async def run_to_completion(self, initial_observation: str) -> None:
        """Run the full agent loop until completion or iteration limit."""
        obs = initial_observation
        while self.context.iteration_count < self.context.max_iterations:
            thought_output = await self.step(obs)
            if "FINAL_ANSWER:" in thought_output:
                logger.info("Agent successfully reached completion state.")
                break
            obs = f"Simulated tool execution output for thought: {thought_output[:50]}..."
这里发生的是:我们建立了一个持久化会话上下文(session_id),将 Agent 的每一个连续回合绑定在一起,允许 Magnitude 后端在异步工具执行之间维护统一且被剪枝的 KV Cache。
接下来,我们需要处理运行时遥测反馈。自优化引擎依赖于来自应用层的信号反馈来判断某个特定生成路径是成功还是失败,从而动态调整未来请求的路由权重。
async def report_execution_feedback(client: MagnitudeClient, session_id: str, success: bool, error_msg: str = None) -> None:
    """Report execution outcome back to Magnitude to optimize future inference paths."""
    feedback_payload = {
        "session_id": session_id,
        "success": success,
        "error_reason": error_msg,
        "timestamp": "2026-10-01T06:00:00Z"
    }

    response = await client.submit_telemetry_feedback(feedback_payload)
    if response.get("status") == "acknowledged":
        logger.info("Telemetry feedback successfully ingested by optimization engine.")
    else:
        logger.warning("Failed to ingest telemetry feedback; optimization weights unchanged.")

if __name__ == "__main__":
    print("Agent execution pipeline ready for deployment.")
这第二个代码片段实现了闭环优化反馈机制,将成功和错误遥测发回 Magnitude,以便引擎能够根据你的特定应用工作负载持续优化其内部投机草稿模型权重和 Token 路由启发式算法。
在将生产 Agent 工作流迁移到自优化推理引擎时,工程团队经常会在几个微妙的地方栽跟头,这些陷阱会降低性能或破坏会话状态。
错误 1:在每次工具调用时重新初始化会话 ID。 如果你将每个步骤都当作一个全新的无状态请求来处理,就会破坏持久化 KV Cache 并消除预测性预填充的好处,导致延迟飙升回基线水平。
错误 2:在工具使用生成时忽略语法约束。 在没有运行时语法强制执行的情况下,让大语言模型自由生成用于工具参数的非结构化 JSON,会导致频繁的语法错误和浪费的 Agent 循环。
错误 3:在 Agent 失败时未刷新遥测反馈。 如果你不将执行错误报告给引擎,自优化层就无法从路由错误中学习,使你的系统困在次优推理路径中。
在将自优化 Agent 推理栈推送到生产环境之前,请验证以下操作检查清单上的每个项目,以确保在高并发下具有稳定性、安全性和低延迟。
验证会话持久性: 确保你的 Agent 框架在所有依赖的工具使用步骤和递归推理循环中维护一个唯一、确定的 session_id。
启用投机解码: 确认你的草稿模型和目标模型正确对齐并加载到兼容的 GPU 内存池中,以实现最大吞吐量增益。
监控缓存命中率: 在实时系统中追踪你的前缀缓存和块表利用率指标,以确保你的 Prompt 结构最大限度地实现了内存复用。
设置硬迭代限制: 始终在你的 Agent Runner 上配置严格的 maximum iteration bounds,以防止无限循环耗尽你的计算预算。
永远不要硬编码回退 Token: 确保你的错误处理在优化代理遇到瞬态网络分区或超时时,能够优雅地回退到标准生成路径。
静态推理引擎将 Agent 循环视为孤立的文本补全,在冗余的预填充计算上浪费大量计算资源。
Magnitude 通过将有状态 KV 缓存、预测性剪枝和语法约束解码相结合,弥合了 Agent 框架和 LLM 运行时之间的差距。
在 Agent 步骤中维护一致的 session_id 追踪,解锁了大规模延迟减少和更低运营成本。
将执行遥测反馈到推理运行时,使系统能够根据你的特定应用工作负载持续自优化。
Engr. Hamza | AI & MLOps Engineer | Building autonomous systems at the edge of possibility