
8.0
热点
AI SCORE
技术实践2026-09-27 10:36
FORGE多Agent研究系统的设计复盘:运行即日志
dev.to · AI#多Agent#AI系统#工程实践
Editor brief · 编辑速览
作者搭建FORGE多Agent研究流水线(规划→搜索→写作→核查)的工程复盘,核心洞见:一次运行是一组事件日志而非状态记录;Dashboard先行用假Agent模拟验证全流程。
第一个版本是一个还不存在的系统的仪表板。
它有一个工作流画布,每个 agent 是一张卡片,每个箭头是一次交接。它有实时事件流、时间线、回放拖动条、每个 agent 的成本和 token 计数器、agent 构建器和工作流设计器。背后是一个模拟器:虚假的 agent 运行在虚假的时间上,产生看似真实的事件,让每个界面都有东西可展示。
从第一天起就确立的一个设计决策贯穿了后来的所有工作。一次运行是一份事件日志,而不是一条会被更新的记录。"Researcher started"、"tool call finished"、"handed the notes to the writer":每个界面都是从这份日志计算出来的。实时视图和回放是同一套代码;回放只是在读到日志的某个位置就停下来。当后来真实的 agent 取代模拟器时,界面没有任何变化,因为真实 agent 发出的事件是一样的。
它看起来很漂亮,但全是假的。
真实的 agent 意味着真实的模型调用,而我希望它们便宜。我从三个 agent 开始:researcher、writer 和 reviewer。
模型:大多数 agent 通过 OpenRouter 运行 GLM-5.3 Flash,每百万输入 token 约 $0.15。Reviewer 运行在 Claude 上。
搜索:通过 ddgs Python 包调用 DuckDuckGo。免费且无需密钥。
读取页面:一个小脚本获取 URL 并提取正文(网页用 trafilatura,PDF 用 pypdf)。
服务器:一个小型 Node.js 服务器运行 agent、存储每个事件、并实时推送到浏览器。
第一次真实运行以模拟器永远无法模拟的方式失败了。
每次调用都立即超时。服务器没有 IPv6。当一个主机名有多个地址时,Node.js 会依次尝试每个地址,默认每次尝试只有 250 毫秒,在这个网络上不够用。修复只有两行:优先使用 IPv4,每次尝试给三秒钟。
有些回复是空的。模型把全部输出预算都花在了推理上,没有剩余空间给答案了。现在它会重试一次,给双倍的空间。
Researcher 从不停止研究。它一直搜索和读取,直到达到步骤限制,然后没有任何笔记。现在每个工具结果都会告诉它还剩多少轮,最后一轮会强制它整理已有的内容。
有些网站从不响应。一个慢的主机可以吃掉一分钟。页面获取现在会在 20 秒后放弃,而超时的主机在本次运行的剩余时间里会被跳过。
随着真实的 agent 开始工作,我逐页检查应用,问一个问题:这是真的还是模拟的?
很多东西是模拟的但看起来像真的。模型供应商页面显示的是捏造的使用数据。工具页面列出了从未运行过的工具的成功率和响应时间。运行历史充满了示例运行。
然后我问团队一个真正的问题,得到了一个自信、格式规范的答案——但答案针对的是一个完全不同的问题。那次运行使用了模拟器,它产生看似合理的文本而完全忽略问题。它是大多数工作流的默认设置,而界面上没有任何提示。
我从中学到的规则:永远不要交付看起来像真的占位符。要么标注它,要么删掉它。现在模拟数据在各处都有明确标记。模拟器只作为工作流设计器里的一个"Dry run"按钮存活下来,用于免费检查连线。你根本无法从 New Run 界面启动一次模拟运行。
我在桌面端和笔记本上使用 FORGE,它们显示不同的数据。一切都存在每个浏览器的本地存储里,所以每个设备都有自己的私有副本。
现在服务器拥有一个单一的 SQLite 数据库。每次变更都发送到服务器,每个打开的标签页通过实时连接获得推送更新。每个浏览器只需上传一次旧的本地数据,服务器负责合并。
这暴露了一个更隐蔽的 bug。运行 ID 由每个浏览器生成,笔记本生成了一个桌面已经用过的 ID,覆盖了一次运行。现在只有服务器才能发放运行 ID。
我在 researcher 前面加了一个 planner。它写一份简短的计划,包含子问题和搜索查询,成本大约一分钱的一百分之一,这让研究的专注度明显提升。
然后我查了账单。一个 OpenRouter 密钥为所有东西付费,余额只剩 $1.74。所以 Claude 模型现在直接走 Anthropic 的 API,其他一切留在 OpenRouter 上。如果 Anthropic 的密钥在计费时失败,调用会回退到 OpenRouter 而不是让运行失败。
Reviewer 是最贵的部分。我用同一份有缺陷的草稿(其中包含一个真实错误:把一项性能声明归到了错误的来源)测试了三个 reviewer。
Claude Sonnet,高努力程度:发现了错误。每次审查约 $0.03。
Sonnet,低努力程度:批准了那份有缺陷的草稿。每次约 $0.014。
Claude Haiku:因为其他原因把草稿打回,但没有发现那个错误。$0.009。
我选了 Haiku。下一节是关闭那个差距的做法。
一次运行连续七次网络搜索失败。对日志的一次外部审查把责任推到 DuckDuckGo 的限流上,建议切换到付费搜索 API。
日志说的是另一回事。搜索库在多个引擎之间轮换,四个引擎在三分钟内全部超时。当我重新运行时同样的查询在两到四秒内成功了。这是我这边的短暂网络故障,付费 API 同样会超时。所以不是切换提供商:
搜索快速失败并重试:12 秒限制,一次重试,连续三次失败后等待 30 秒让网络恢复。
来源不足在代码里标记,不只是提示:如果 researcher 读取的页面少于两页,答案会带有警告横幅说明未经核实。Writer 也会被告知,但标记不依赖它是否听话。
Reviewer 自己检查来源:它打开草稿引用的两到三个页面,检查它们是否说了草稿声称的内容。这就是便宜 reviewer 缺失的部分:一个可以对照核实的来源。Researcher 已经获取的页面被复用,所以这个检查不花额外时间。
我已经运行了一个叫 Hermes 的个人助手 agent,它在 Telegram 上和我交流。FORGE 和 Hermes 现在双向连接。
FORGE → Telegram:每次完成的运行都会发送答案、成本、时间和运行页面的链接。失败的运行发送 ❌ 和错误信息。
Telegram → FORGE:Hermes 里的 /forge 命令把问题交给团队。Hermes 一个命令只能等三分钟,而一次运行需要更久。所以命令启动运行后立即返回,答案在团队完成后到达 Telegram。
现在有三个级别:quick(无 reviewer,大约半美分,答案标注"未经事实核查")、verified(默认,二到四美分)和一个更大的六 agent 团队用于深度问题。我自己选择级别。我考虑过一个分类器来判断问题是否需要核查。它会很便宜,但有时候恰恰是在最重要的那个问题上跳过核查。
交接是单向的:writer 拿到笔记,仅此而已。如果笔记留下了空白,writer 只能猜测或略过。
所以 agent 现在可以在任务中途向队友提问。Writer 可以问 researcher,researcher 从笔记中回答或做一次快速查找。在一次运行中 writer 发现两个 researcher 给出了同一事实的不同数字,问其中一个去裁定。Researcher 回到来源,用设定那个数字的账单回答了。
我还加了一个并行团队:leader 把问题拆成三个角度,三个 researcher 同时工作并将发现发布到共享看板上,然后 writer 和 reviewer 完成。
它的第一次运行在 20 分钟限制时失败,当时每个 agent 都很忙。一个 researcher 的最终整理单独花了五分钟,因为模型把它花在了推理上。我的 stall 检测器监视着变得安静的流,而一个正在输出思考过程的推理模型永远不会安静。
我测量了同一个三句话的提示词。不设置推理努力时,模型用了 93 秒和 3,200 个推理 token。设置努力:低,用了 9 秒。不设置这个参数并不意味着一个合理的默认值;而是没有限制。为每次调用设置它之后,同一个并行问题在 5 分 10 秒和四美分内完成。
最后一块是监控。我有一个仪表板叫 Operator Pulse,显示服务器上每个定时任务并在某个失败时提醒我。FORGE 现在作为服务出现在上面:服务器是否在线、最近的运行、成功率和 OpenRouter 余额。
新的 FORGE 节点第一次渲染时是琥珀色的:只剩 $0.47 的余额。那个密钥也为 Hermes 付费,所以两者都会在没有预警的情况下停止工作。
FORGE 现在也可以运行定时问题了。每一个都是一个小脚本,仪表板像其他任务一样跟踪它。
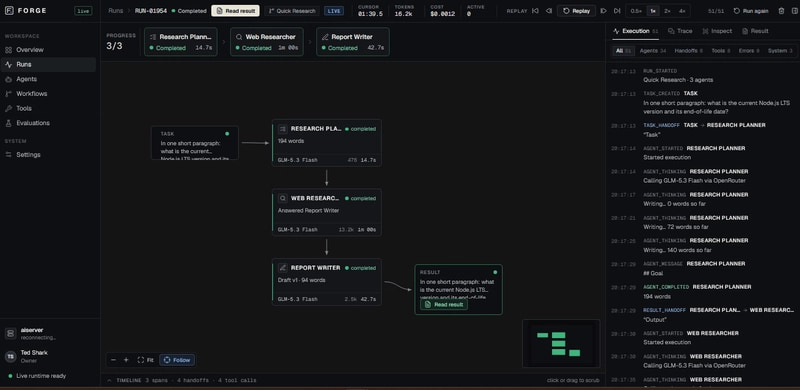
一次完成的快速运行:三个 agent,1 分 40 秒,大约一美分。右侧的每个事件都可以回放。
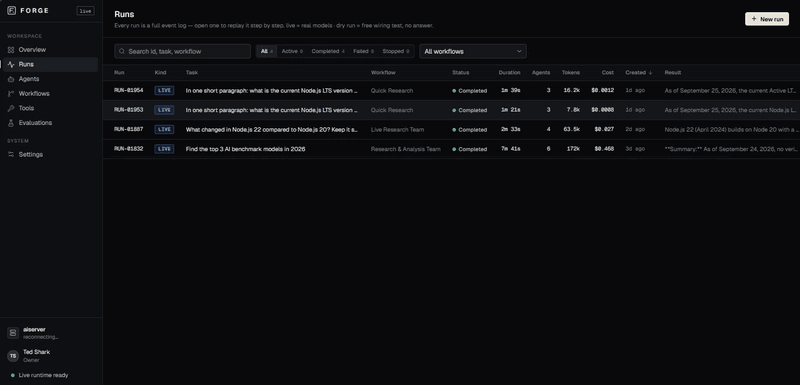
每次运行都可以完全回放。每个答案都列出来源的页面,当无法核实足够多的来源时会如实说明。
仪表板在第一天就完成了。它有每个界面、每个计数器和每个动画,而全是模拟的。那之后的一切都是同样工作的重复:找到一个地方,应用看起来能工作但实际不能。
有些地方很明显:超时、空回复、在二十分钟时死掉的运行。最重要的那些是安静的:一个针对错误问题的自信答案、两台设备都确信自己的数据才是真的、一个因为模型不停说话而从不触发的超时、一个没人看着的余额。
演示说明某样东西可以工作。让它可信意味着找到每个它只是看起来能工作的地方。