
8.0
热点
AI SCORE
模型发布2026-10-01 06:06
Gemini 4 Argon:追平OpenAI但仍未超越Anthropic
The Decoder#Google#Gemini#大模型
Editor brief · 编辑速览
Gemini 4 Argon 在独立测试中与 GPT-6 Astra 持平,但落后于 Claude Opus 5.5,每任务 token 消耗是 Astra 两倍以上,API 和付费层即将开放。
Google 发布了 Gemini 4 Argon,这是一款旗舰级模型,缩小了与 OpenAI 和 Anthropic 前沿模型的差距,并在部分关键基准测试中超越了它们。
新特性:Argon 支持高达 100 万输出 token,能够在单次处理中完成复杂推理而不会超时。
Google 分阶段推出 Argon,初始价格为每百万输入 token 2 美元、每百万输出 token 10 美元,后续常规价格将上涨至 4 美元和 20 美元。缓存输入价格优惠 95%。
Google 发布了 Gemini 4 Argon,这是一款前沿模型,缩小了与 OpenAI 和 Anthropic 竞争对手的差距,并在部分关键基准测试中超越了它们。虽然它可能并未明确领跑,但作为前沿模型价格相对低廉——至少在初始阶段如此。
Argon 是 Google 超过七个月以来的首款前沿模型,上一款是 Gemini 3.1 Pro。它让这家广告巨头重新回到了 AI 实验室前三甲之列,不过 Anthropic 可能仍占据领先地位。经过一段困难而漫长的开发周期——期间已宣布的 Gemini 3.5 前沿模型被完全跳过——Google 重回竞赛。
Argon 最初将面向 "可信网络防御者" 群体开放,作为 Fairwind 计划的一部分。这些用户和 Google 内部团队将获得不带网络防护栏的模型。Google 以"分阶段方法"来解释这种渐进式推出,称此类 AI 能力需要这种方式。公司还参与了美国政府的自愿计划,让各部门在新模型公开发布前就能获取。
早期测试者的反馈将注入模型的安全机制中。在此之后,Google 才计划向开发者、企业和消费者开放 Argon,从付费 API 客户和 Google AI Ultra 订阅者开始。公司尚未给出具体日期,只说"尽快"。
价格已经确定,至少作为初始费率:每百万输入 token 2 美元,每百万输出 token 10 美元。缓存输入 token 成本降低 95%,折合每百万约 10 美分。Gemini 3.8 Flash 的缓存折扣为 90%。这使得 Google 在原始 token 价格上远低于其他前沿模型,不过在 token 消耗量上并非如此(见下文)。
*Google 没有明确说明这一数字,只是称缓存比常规输入 token 价格便宜 95%。
Google 还将输出上限从 64000 提升到 100 万 token,称之为行业首创。理念是:如果模型能在单次轨迹中生成数十万 token,就能更彻底地思考难题并一次性解决。为此,Google 在 Gemini API 中新增了 "Long Decode Continuation" 功能。它会暂停长响应,通过后续请求恢复,使推理不会因超时而中断。
输入上下文窗口保持在 100 万 token。Argon 接受文本、图像、视频和音频作为输入,但只输出文本。
Artificial Analysis 提供了早期独立评估。在其最高可用推理级别 "High" 下,Gemini 4 Argon 在 Artificial Analysis Intelligence Index 上获得 53 分。与 OpenAI 的 GPT-6 Astra(最高)和 Claude Fable 5.1 持平,领先 GPT-6.1 Sol(最高)1 分。
Anthropic 的模型仍处于领先地位。Claude Opus 5.5 达到 58 分,Claude Sonnet 5.5 达到 56 分。与 Google 的上一款前沿模型 Gemini 3.1 Pro Preview 相比,Argon 跃升了 23 分。"High" 通常是 Gemini 模型的最高推理级别,不过有时也会支持特殊的 "Deep Think" 模式。
按当前促销价格,每个 Intelligence Index 任务成本 1.99 美元。这是 GPT-6 Astra 成本(3.26 美元)的 60%,但却是 GPT-6.1 Sol 的 2.7 倍。折扣结束后,成本升至 3.98 美元,比 GPT-6 Astra 高出约 20%。价格优势来自更低的 token 费率,而非效率。Argon 每个任务平均消耗 62000 个输出 token,而 GPT-6 Astra 仅需 27000 个。
Artificial Analysis 结果显示 Argon 在 "High" 下正在追赶上第一梯队。| 图片来源:Artificial Analysis
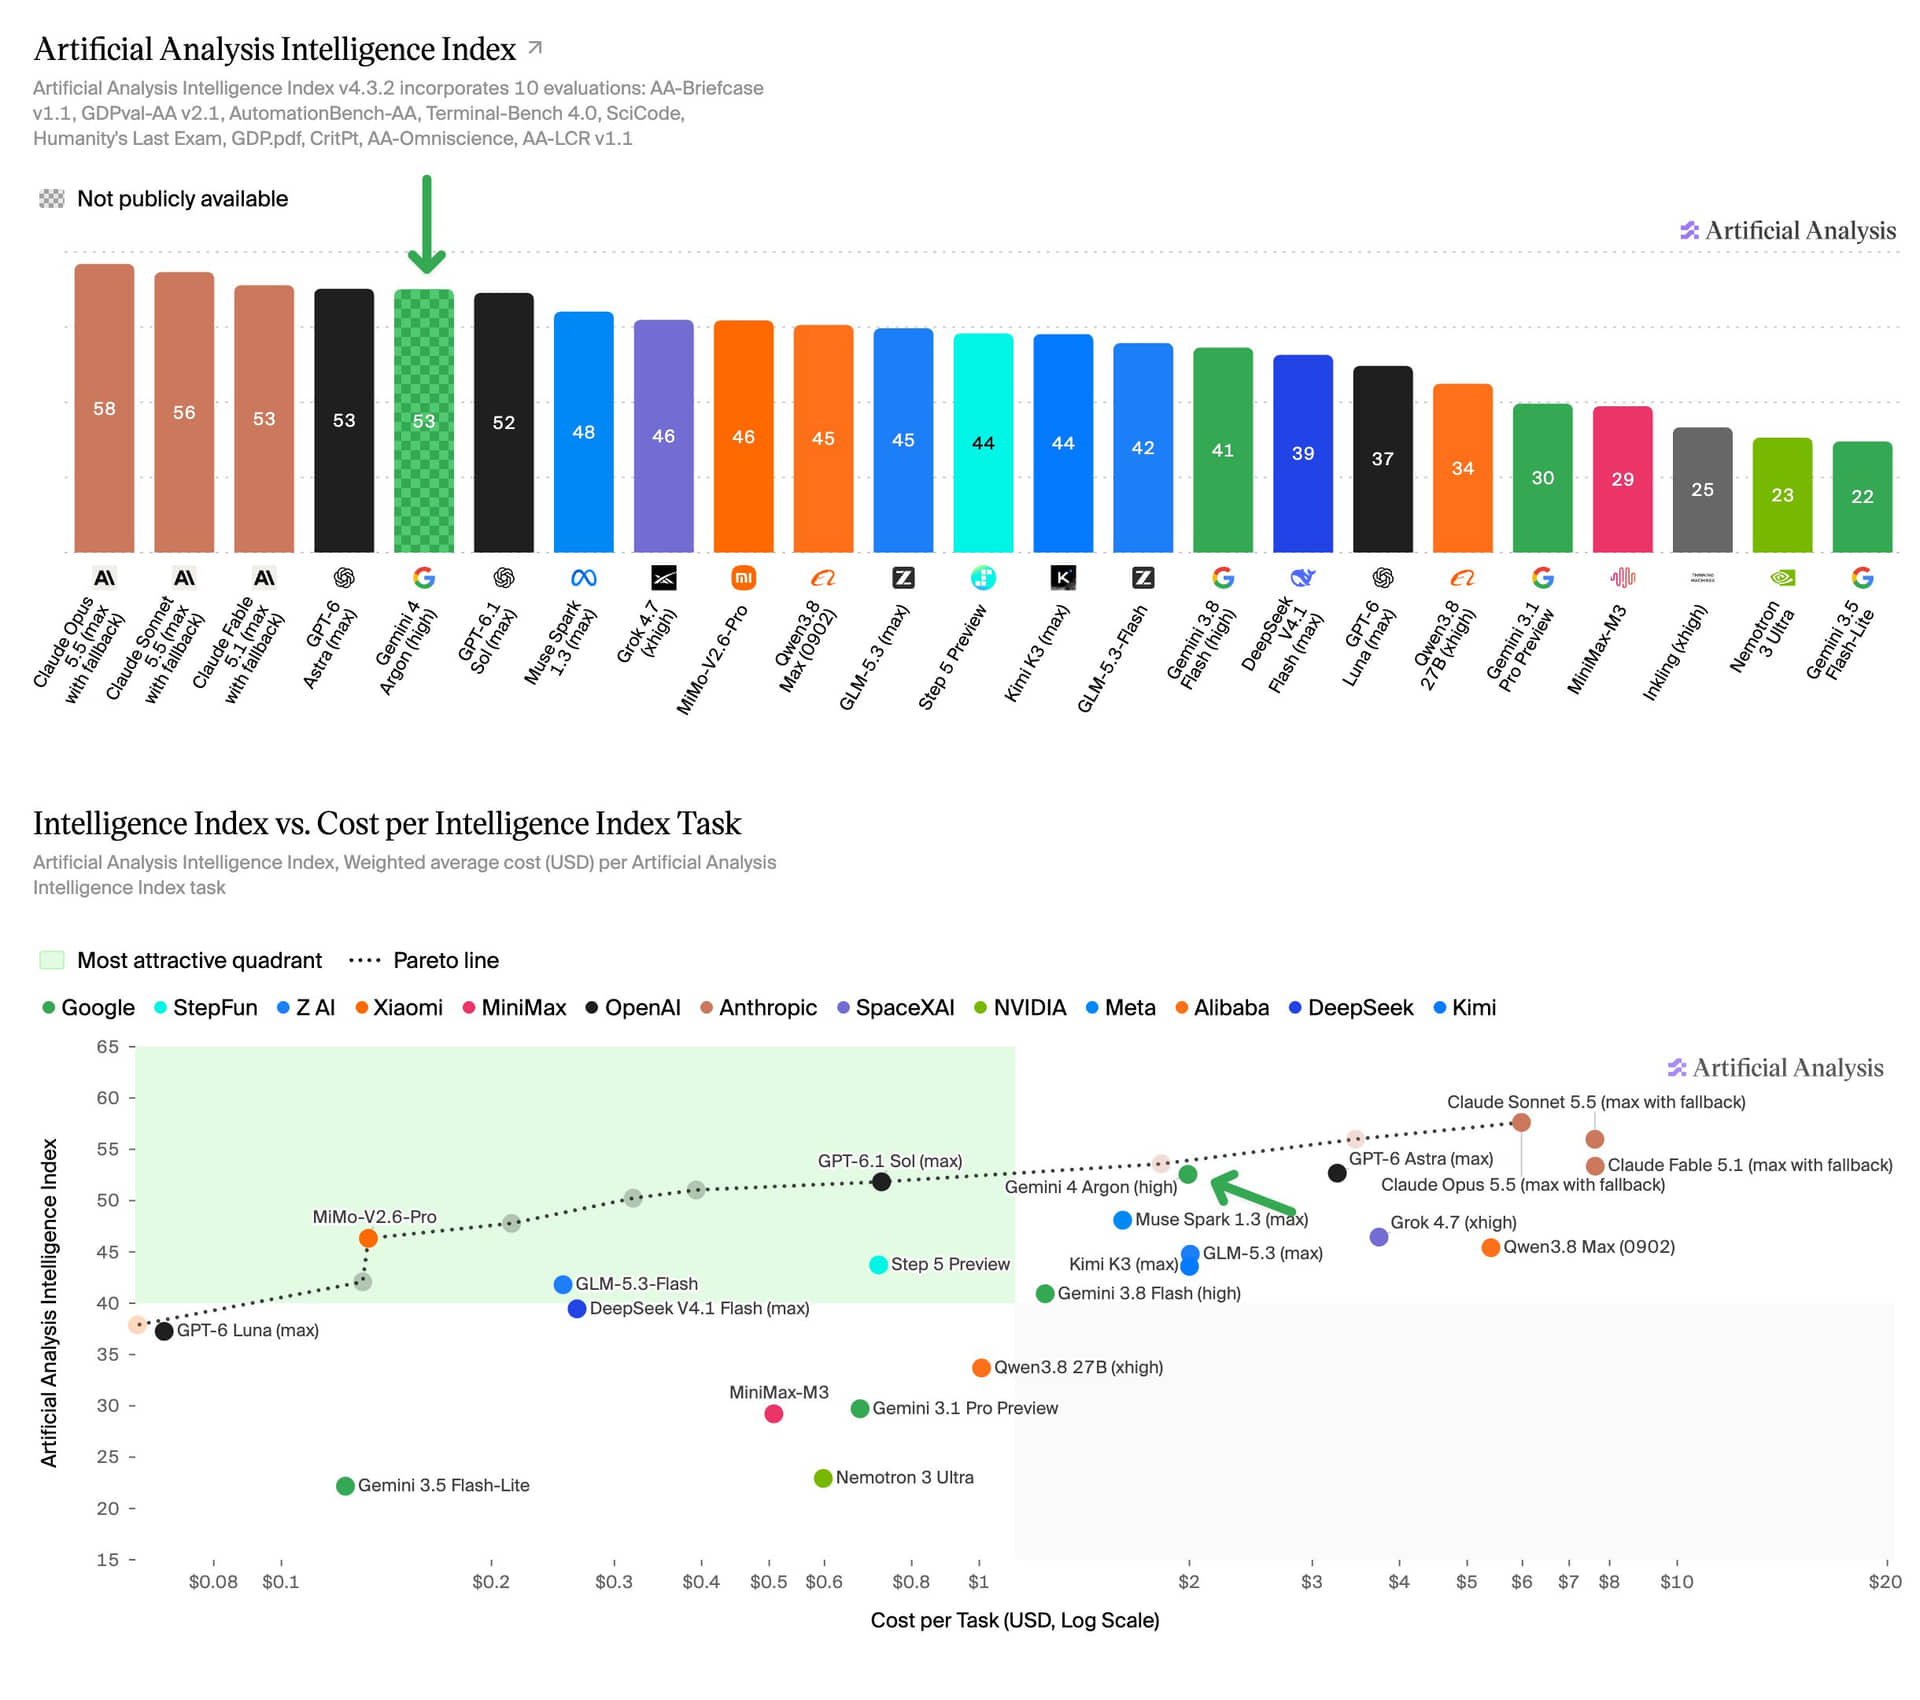
Argon 在代理任务上也有显著提升,而据 Artificial Analysis 称,这一直是 Gemini 模型的弱项。在 Artificial Analysis 变体的 AutomationBench-AA 上,它以 77.5% 获得第一名,领先 Claude Sonnet 5.5(最高)6 分。在 Terminal Bench 4 上达到 57%,比 Gemini 3.1 Pro Preview 跃升 53 分。但仍落后于 Claude Sonnet 5.5(64%)、Claude Opus 5.5(60%)和 GPT-6 Astra(59%)。
Artificial Analysis 还强调了 Argon 的低幻觉率。在 AA-Omniscience 上——一个测试事实知识和诚实处理知识缺口的基准——Argon 的幻觉率为 15%。GPT-6 Astra(最高)为 51%,GPT-6.1 Sol(最高)为 54%。Argon 更倾向于承认不知道答案,而不是猜错。然而,它的准确率仅达到 50%,比 Gemini 3.1 Pro Preview 低 5 分,比 GPT-6 Astra(最高,63%)低 13 分。在该基准的总分上,Argon 获得 42 分,与 GPT-6 Astra(43)和 GPT-6.1 Sol(42)大致持平。
Google 自己的基准测试结果描绘了一幅更乐观的画面。Argon 在大多数基准测试中处于领先,有时优势明显。
Google 内部基准测试结果显示 Gemini 4 Argon 领先。| 图片来源:Google
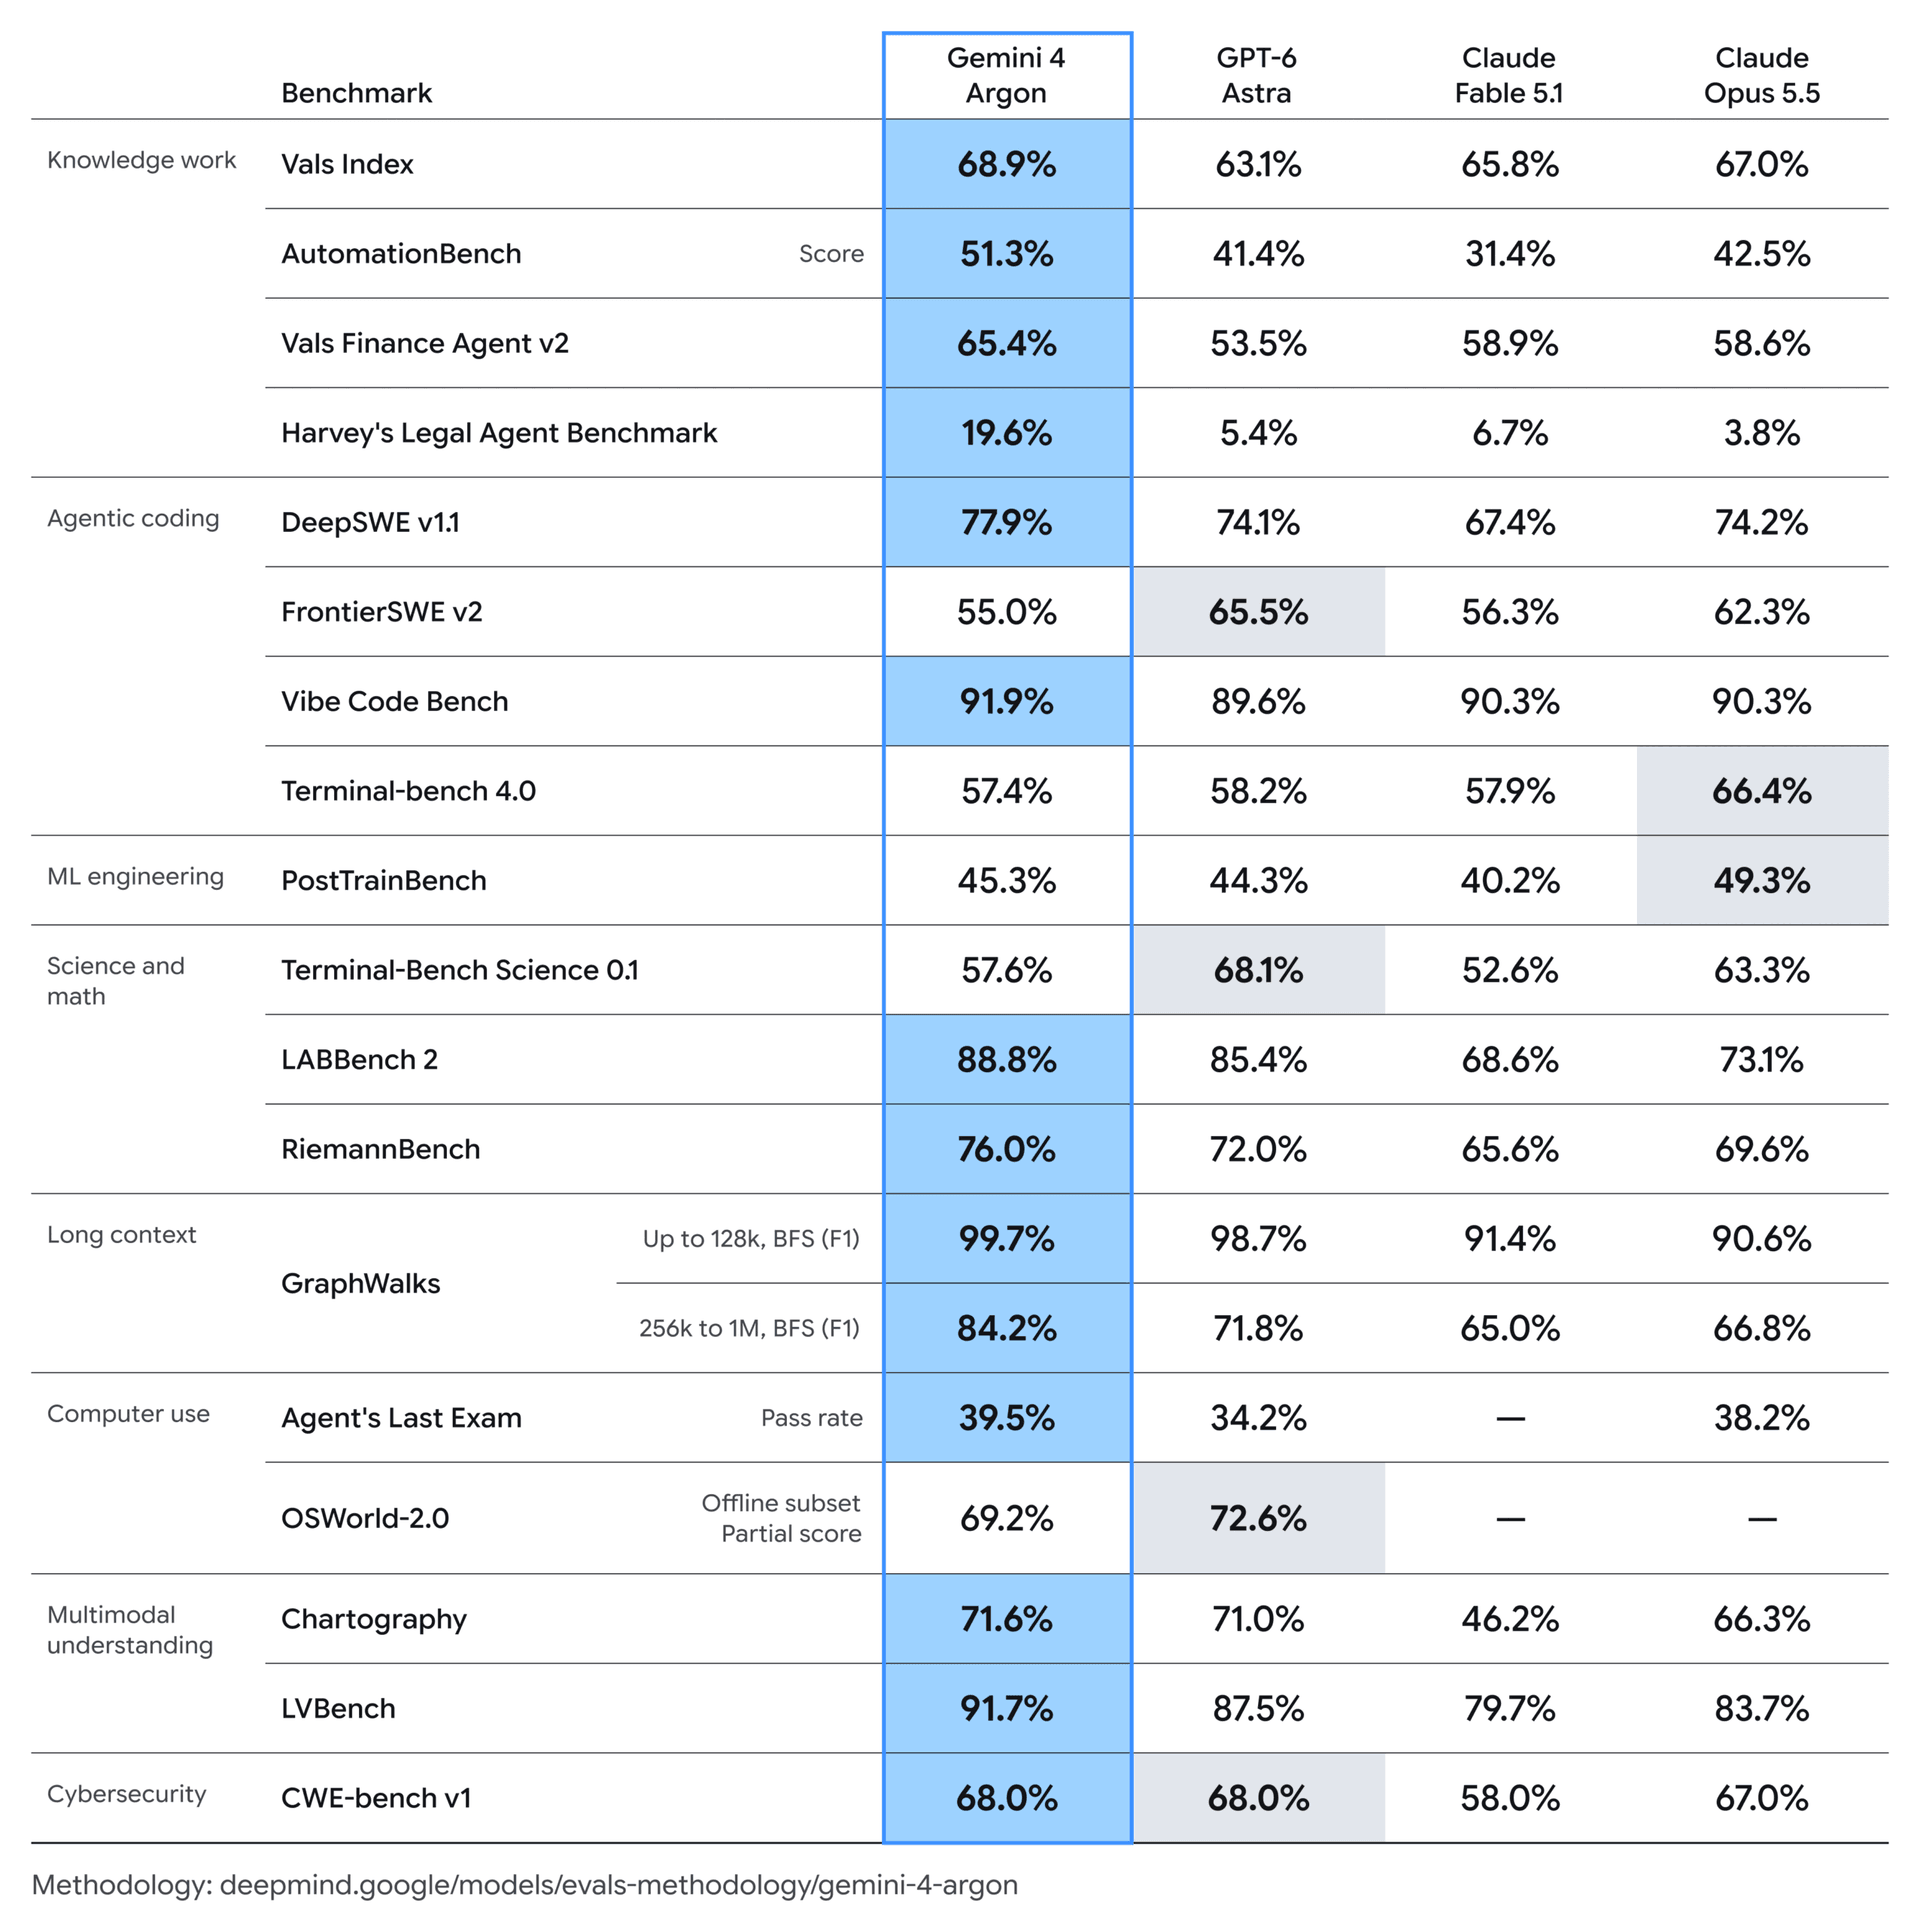
Argon 还在 Vals Index 上占据首位。根据 Vals AI,它以 68.9% 排名第一,成为首款在该索引上登顶的 Gemini 模型。在 22 个测试基准中的 20 个中进入前五,在金融、法律、编码和安全领域表现尤为突出。不过,在这个测试中,中端模型 Sonnet 5.5 也超越了 Anthropic 的顶级模型 Opus 5.5,所以需要持保留态度。
一如既往,AI 模型必须在实际使用中证明自己,性能不仅取决于模型本身,还取决于围绕它的软件。这是 Google 目前的弱点:与 Claude Cowork 和 ChatGPT Work 相比,Gemini 应用仍然落后。
在 Arena.ai——人类对模型输出进行一对一比较评分的地方——Argon 表现出色。在 Text Arena 中,Gemini 4 Argon(High)以 1525 分获得第一名,领先第二名的 Claude Opus 4.6(High)20 分。这使其成为写作任务的强有力竞争者,尤其是在写作模型长期匮乏、而 Opus 5.5 在人类偏好排名中仍未能超越 Opus 4.6 的情况下。Google 的上一款模型 Gemini 3.8 Flash(High)排名第十一。
根据 Arena,Argon 在编码、困难提示、指令遵循、长查询和创意写作方面处于领先地位。它还在所有评估的专业领域位列第一,以及英语、中文、俄语和非英语查询中均排名第一。
Web 开发结果较为平淡。在 Code Arena: WebDev 中,Argon 获得 1679 分,排名第八。比 Gemini 3.8 Flash(High)提升了 96 分,从第 29 名跃升,但未能进入前列。
在性价比方面,Arena 将 Argon 置于领先地位。按每百万 token 8 美元的混合费率计算,Argon 移动了 Text Arena 的帕累托前沿,是该排名中目前最具成本效益的模型。