
8.0
热点
AI SCORE
技术实践2026-10-01 04:38
构建 Agent 数据工厂:Parquet + DuckDB + MCP 架构实战
dev.to · AI#Agent#MCP#数据工程
Editor brief · 编辑速览
文章将软件工程的工厂模式引入数据分析 Agent,提出 Data Factory 概念解决 Schema 发现重复、业务逻辑困在对话中、大结果集消耗上下文等难题,描述如何用 MCP + 验证循环构建可复用的分析管道。
给 AI Agent 配数据库凭证很容易。给它真正能可靠使用的数据,就难多了。
一个典型的分析型 Agent 通常是这样工作的:发现 schema、识别表、生成 SQL、把结果加载到上下文、重建业务定义、计算请求的指标。这套流程跑一个问题可以,但它不是一个可复用的系统。
下一个 Agent 会重复同样的发现过程。一个略有不同的 prompt 就会产生一个略有不同的查询。业务逻辑被锁在对话里。大结果集消耗上下文窗口。生产数据库承受着反复的分析查询压力。答案之所以不一致,是因为每个工作流都在独立地重建对公司的认知。
我们一直把这个问题当作基础设施问题来对待:Agent 需要一个 Data Factory(数据工厂)。
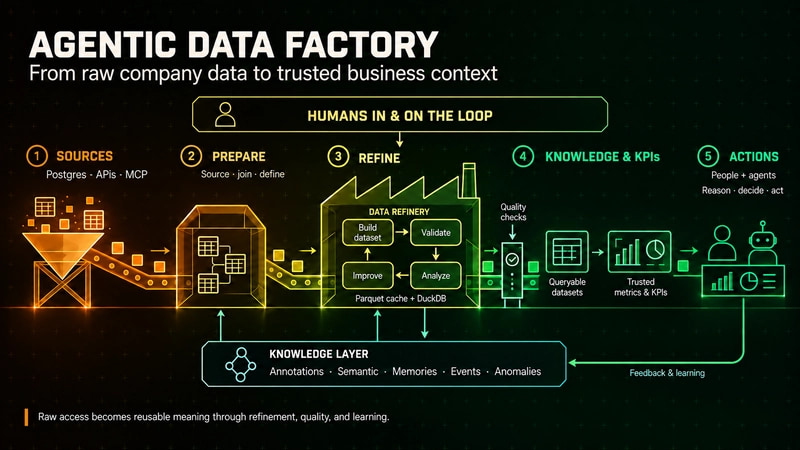
一个 Agentic Data Factory 将软件工厂中正在兴起的相同运营原则应用到分析工作上。它为 Agent 提供上下文、专用工具、验证、反馈、记忆和反复的精炼循环。它的主要产出不是生成的文本或一次性的 SQL 查询,而是受治理的指标、可复用数据集、关系和知识产品。
本文将介绍该模型背后的技术架构。
原始表是为应用程序和事务优化的。它们很少是所有分析型 Agent 都适用的正确接口。
数据源层可能包括:
Data Factory 应该通过有限范围的只读连接访问这些系统,并将分析工作从反复直接查询生产库中剥离出来。
数据源是输入,不是最终的 Agent 接口。
传统数据管道做的是数据搬运和转换。Agentic Data Factory 还要对它进行精炼(refinement)。
精炼意味着将原始记录转化为具有足够结构和上下文的分析产品,以便安全地复用。一个概念性的管道如下:
Source systems
    ↓
Schema and relationship discovery
    ↓
Cross-source joins and cleaning
    ↓
Business definitions and metric logic
    ↓
Materialized analytical datasets
    ↓
Profiling, quality checks, and anomaly detection
    ↓
Semantic + Knowledge Layer
    ↓
Dashboards, reports, APIs, and agents over MCP
重要的分界线在于原始源数据和精炼后的分析产品之间。
一份精炼后的数据集应该包含的不只是数据行,还应该携带:
这些元数据使数据集在其创建工作流之外也有价值。
Agent 需要探索的空间,但不能把每个中间结果都变成永久基础设施。
一个有用的数据集生命周期至少有三个状态:
临时调查数据集:为即时问题创建,允许过期销毁。
展示数据集:供仪表板、报告或其他定义的产物使用。
持久数据集:晋升后供未来的 Agent、指标、工作流和接口复用。
晋升时应该保留查询定义、物化结果、元数据、血缘、权限和刷新行为。
这让 Agent 可以快速工作,同时保持持久层的审慎性。有价值的分析工作在对话结束后得以保留。一次性探索不会变成永久的冗余。
对于分析型 Agent 工作负载,一个实用的模式是将精炼后的数据集物化为 Parquet,然后用 DuckDB 查询。
Parquet 提供了一种紧凑的列式格式,非常适合分析型扫描。DuckDB 提供了一个嵌入式分析 SQL 引擎,能够处理连接、聚合、过滤、窗口函数和时间序列转换,而无需将每个请求都推回源数据库。
一个简化后的数据集定义可能长这样:
{
  "name": "customer_revenue_health",
  "sources": ["supabase.accounts", "stripe.charges"],
  "refresh": "0 6 * * *",
  "storage": "parquet",
  "query_engine": "duckdb",
  "purpose": "Revenue, retention, and customer-health analysis"
}
一旦物化完成,Agent 就可以直接查询这个分析产品:
SELECT
  customer_id,
  current_mrr,
  active_users_30d,
  support_events_30d,
  churn_risk
FROM customer_revenue_health
WHERE churn_risk = 'high'
ORDER BY current_mrr DESC;
源系统仍然负责操作层面的真相。精炼后的数据集成为可复用的分析接口。
Agent 不应该在每个任务里都独立地重建相同的 KPI 公式。
工厂可以计算并存储以下指标:
一个概念性的指标对象可能长这样:
{
  "metric": "net_revenue",
  "definition": "Captured charges minus refunds and fees",
  "value": 2674000,
  "as_of": "2026-09-30",
  "comparisons": {
    "day_over_day": 0.018,
    "rolling_7d": 0.064,
    "rolling_30d": 0.121
  },
  "events": ["pricing_change", "enterprise_plan_launch"],
  "anomaly": null
}
具体的存储模型会因实际情况而异,但原则是稳定的:指标逻辑应该成为一个受治理的、可复用的产品,而不是随 prompt 局部计算。
语义层解释数据应该如何被解读。它映射 schema、关系、维度、度量、连接、定义和指标逻辑。
Agent 还需要 schema 中不存在的组织上下文:
将这些元素连接起来就形成了知识层。知识图谱可以表示源系统、数据集、指标、业务概念、事件、人员和工作流之间的关系。
Stripe charge ── contributes to ──> Net Revenue
     │                                  │
     └── belongs to ──> Customer ── affects ──> Retention
                                      │
Product usage event ── evidence for ──┘
这张图为 Agent 提供了一种结构化的方式来导航语义,而不必完全依赖相似性搜索或庞大的上下文 prompt。
Model Context Protocol 为 Data Factory 和外部 Agent 之间提供了有用的接口。
MCP Server 不暴露通用的 SQL 端点,而是提供更高级别的工具,例如:
list_datasets()
get_dataset_profile(dataset_id)
query_dataset(dataset_id, sql)
get_metric(metric_id, comparison_window)
get_related_events(metric_id, date_range)
ask_data_analyst(question)
更高级别的工具保留了工厂的治理和上下文。Agent 发现已批准的数据集、查看它们的用途和剖析报告、在定义的限制内查询数据、并通过已建立的定义获取指标。
同一套接口可以为 Claude、Codex、ChatGPT、Cursor、Gemini、Grok、Slack 中的 Agent 以及内部系统服务,而无需让每个系统都对公司数据有各自不同的解读。
Data Factory 不应该因为一条查询执行了就宣告一个分析产品完成。
产出应该进入一个循环:
Plan
  ↓
Source and join
  ↓
Materialize
  ↓
Profile and validate
  ↓
Review definitions and output
  ↓
Detect quality issues or anomalies
  ├── pass → publish or promote
  └── revise → return to the responsible stage
质量检查可以评估:
修正应该成为未来工作的可复用上下文。随着时间推移,被接受的定义、晋升的数据集、注释、规则和审查结果会改善下一个 Agent 可用的输入。
这就是让自主性变得可信的方式。人类定义目标、约束、权限和审查阈值。Agent 处理更多重复性的数据获取、计算、验证和精炼工作。
原始数据可以变成信息。通过定义、历史、事件和关系连接起来的精炼信息变成知识。
智慧仍然属于为决策负责的人。
Agentic Data Factory 的目的不是把判断自动化拿走。它是为了给人类和 Agent 一个共享的分析基础,让人们减少重建数据的时间,把更多时间花在将判断应用于业务上。
这就是我们用 Dreambase Data Factory 构建的架构。关于更宏观的产品论,请阅读 Agents Need a Data Factory。