
8.0
热点
AI SCORE
模型发布2026-09-23 04:06
GPT-6 Sol/Luna 价格减半但性能提升有限
The Decoder#OpenAI#GPT-6#模型评测
Editor brief · 编辑速览
OpenAI 发布两款平价模型 GPT-6 Sol 和 Luna,价格是前代一半但实际智能提升甚微,与 Anthropic Opus 5.5 同日发布形成竞争。
OpenAI 推出 GPT-6 Sol 和 Luna 两款更便宜的模型,以一半的 token 价格实现了与前代相当的性能,并试图与 Anthropic 部分更昂贵的模型展开竞争。
最大的变化是相较于 GPT-5.6 Sol 和 Luna,价格直接砍半。GPT-6 Sol 输入 token 定价为每百万 2 美元,输出 token 为每百万 10 美元;Luna 则为每百万输入 0.10 美元、输出 0.50 美元。
OpenAI 将降价归因于缓存和推理层面的改进,并表示将节省下来的成本直接回馈给用户。此定价使其与部分更便宜的开源权重模型处于同一价位区间。此前产品线中最便宜的模型 Terra 已不再提供。
OpenAI 指出,Sol 专为复杂的重复性任务而设计,例如构建新功能、审查代码、调试和分析数据。Luna 则用于以低成本处理大量定义明确的任务,如文档摘要提取、信息抽取和简短问答。
除了 token 降价,OpenAI 还表示改进了 GPT-6 的 prompt 缓存,缓存输入 token 可享受 90% 的折扣。新上线的 prompt 缓存仪表板和诊断工具旨在帮助开发者优化缓存使用,开发者现在可以在不使缓存失效的情况下调整推理努力程度(reasoning effort)和工具可用性。
发布时,两款模型已在 ChatGPT Work 和 Codex 中面向 Plus、Pro、Business、Enterprise 和 Edu 订阅用户开放。Free 和 Go 用户可通过桌面端应用访问 Luna,但两款模型最初都不会出现在常规聊天界面中。API 中以 gpt-6-sol 和 gpt-6-luna 提供,ChatGPT 中的访问权限正在逐步开放。
GPT-6 Sol 和 Luna 的基准优势主要体现在性价比
OpenAI 此次主要围绕与 Anthropic Claude 系列的价格性能比来定位新模型。在 OSWorld 2.0(测试计算机使用能力)中,OpenAI 表示 GPT-6 取得了与 Claude Opus 5 相近的结果,成本低约 80%,不过 Astra 在该类别中仍处于领先地位。
在 AutomationBench(跨 47 种工具测试业务流程)的最高努力级别下,GPT-6 Sol 据报超越了 Claude Opus 5 在最高努力级别下的表现。OpenAI 将 Sol 的单任务成本定为 Opus 的仅 9%。Luna 则在比前代产品便宜 58% 的同时,性能提升了 5.4 个百分点。
在编程方面,OpenAI 提供了两项基准测试结果。FrontierCode 1.1 测试 AI 智能体生成的代码能否真正集成到现有代码库中,会检查测试质量、代码风格和对需求的遵循程度。GPT-6 Sol 在最高努力级别下得分为 49.3%,单任务成本 2.14 美元,与 Claude Fable 5.1 大致持平(Fable 5.1 在最高努力级别下得分 50.3%,但成本高出六倍,达 12.83 美元)。Claude Opus 5 在中等努力级别(其在该测试中的最佳设置)下达到 53.4%,单任务成本 4.31 美元。
OpenAI 的推理级别正在变得失控
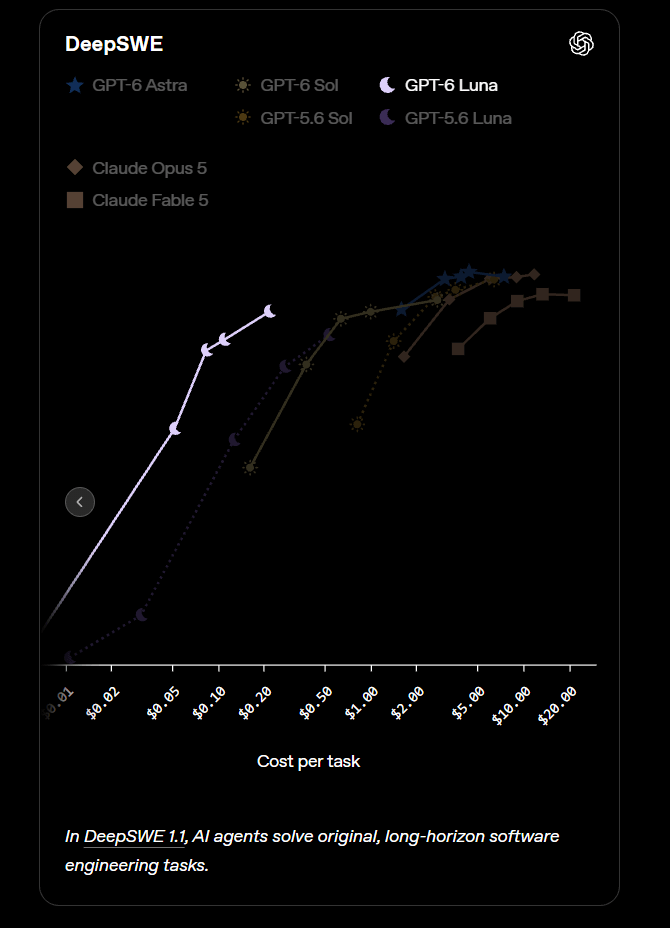
在 DeepSWE v1.1(针对真实代码库中长时间高强度软件工程任务的基准测试)中,OpenAI 报告 GPT-6 Sol 在最高努力级别下得分为 68.8%。这与 Claude Fable 5 在 "xhigh" 级别下 69.9% 的最佳得分仅相差 1.1 个百分点,而 Fable 在 "max" 下为 69.7%,单任务成本 21.63 美元。
当然,Sol 并非在追逐技术前沿。Claude Opus 5 在最高努力级别下达到 73.7%,单任务成本 11.84 美元,而 OpenAI 自家的 GPT-5.6 Sol 为 72.7%,成本 6.46 美元。GPT-6 Sol 的意义在于以极低的价格接近这些数字。在 "xhigh" 级别下,它以 1.00 美元的成本达到 66.6%。Luna 更便宜,在最高努力级别下以仅 0.22 美元的成本匹配该分数。OpenAI 表示,Luna 的结果与 Claude Opus 5 和 Claude Fable 5 在中等努力级别下的表现相当,但成本比 Opus 低 93%,比 Fable 低 96%。
DeepSWE 的结果还让 OpenAI 自家模型之间的选择变成了一道难题。Luna 在最高努力级别下可以匹配 Sol 在 "xhigh" 级别下的表现,但成本降低了 78%。将 Sol 调至最高努力级别也仅能得到 68.8%,比 Luna 仅高 2.2 个百分点。在实际使用中,谁来理清这一切?
OpenAI 自己才是最大的竞争对手。Luna 以远低于 Sol 的成本实现了相当的性能。| 图片来源:OpenAI
总体而言,OpenAI 的基准测试选择看起来有刻意挑选之嫌。GDPval(知识工作)或 Terminal-Bench 4.0(智能体编程)等常见基准测试缺席,尽管它们本是标准配置。OpenAI 似乎还错过了 Opus 5.5 的发布——该版本比 Opus 5 便宜达 40%,同时性能显著提升。
独立分析认为实际进展甚微
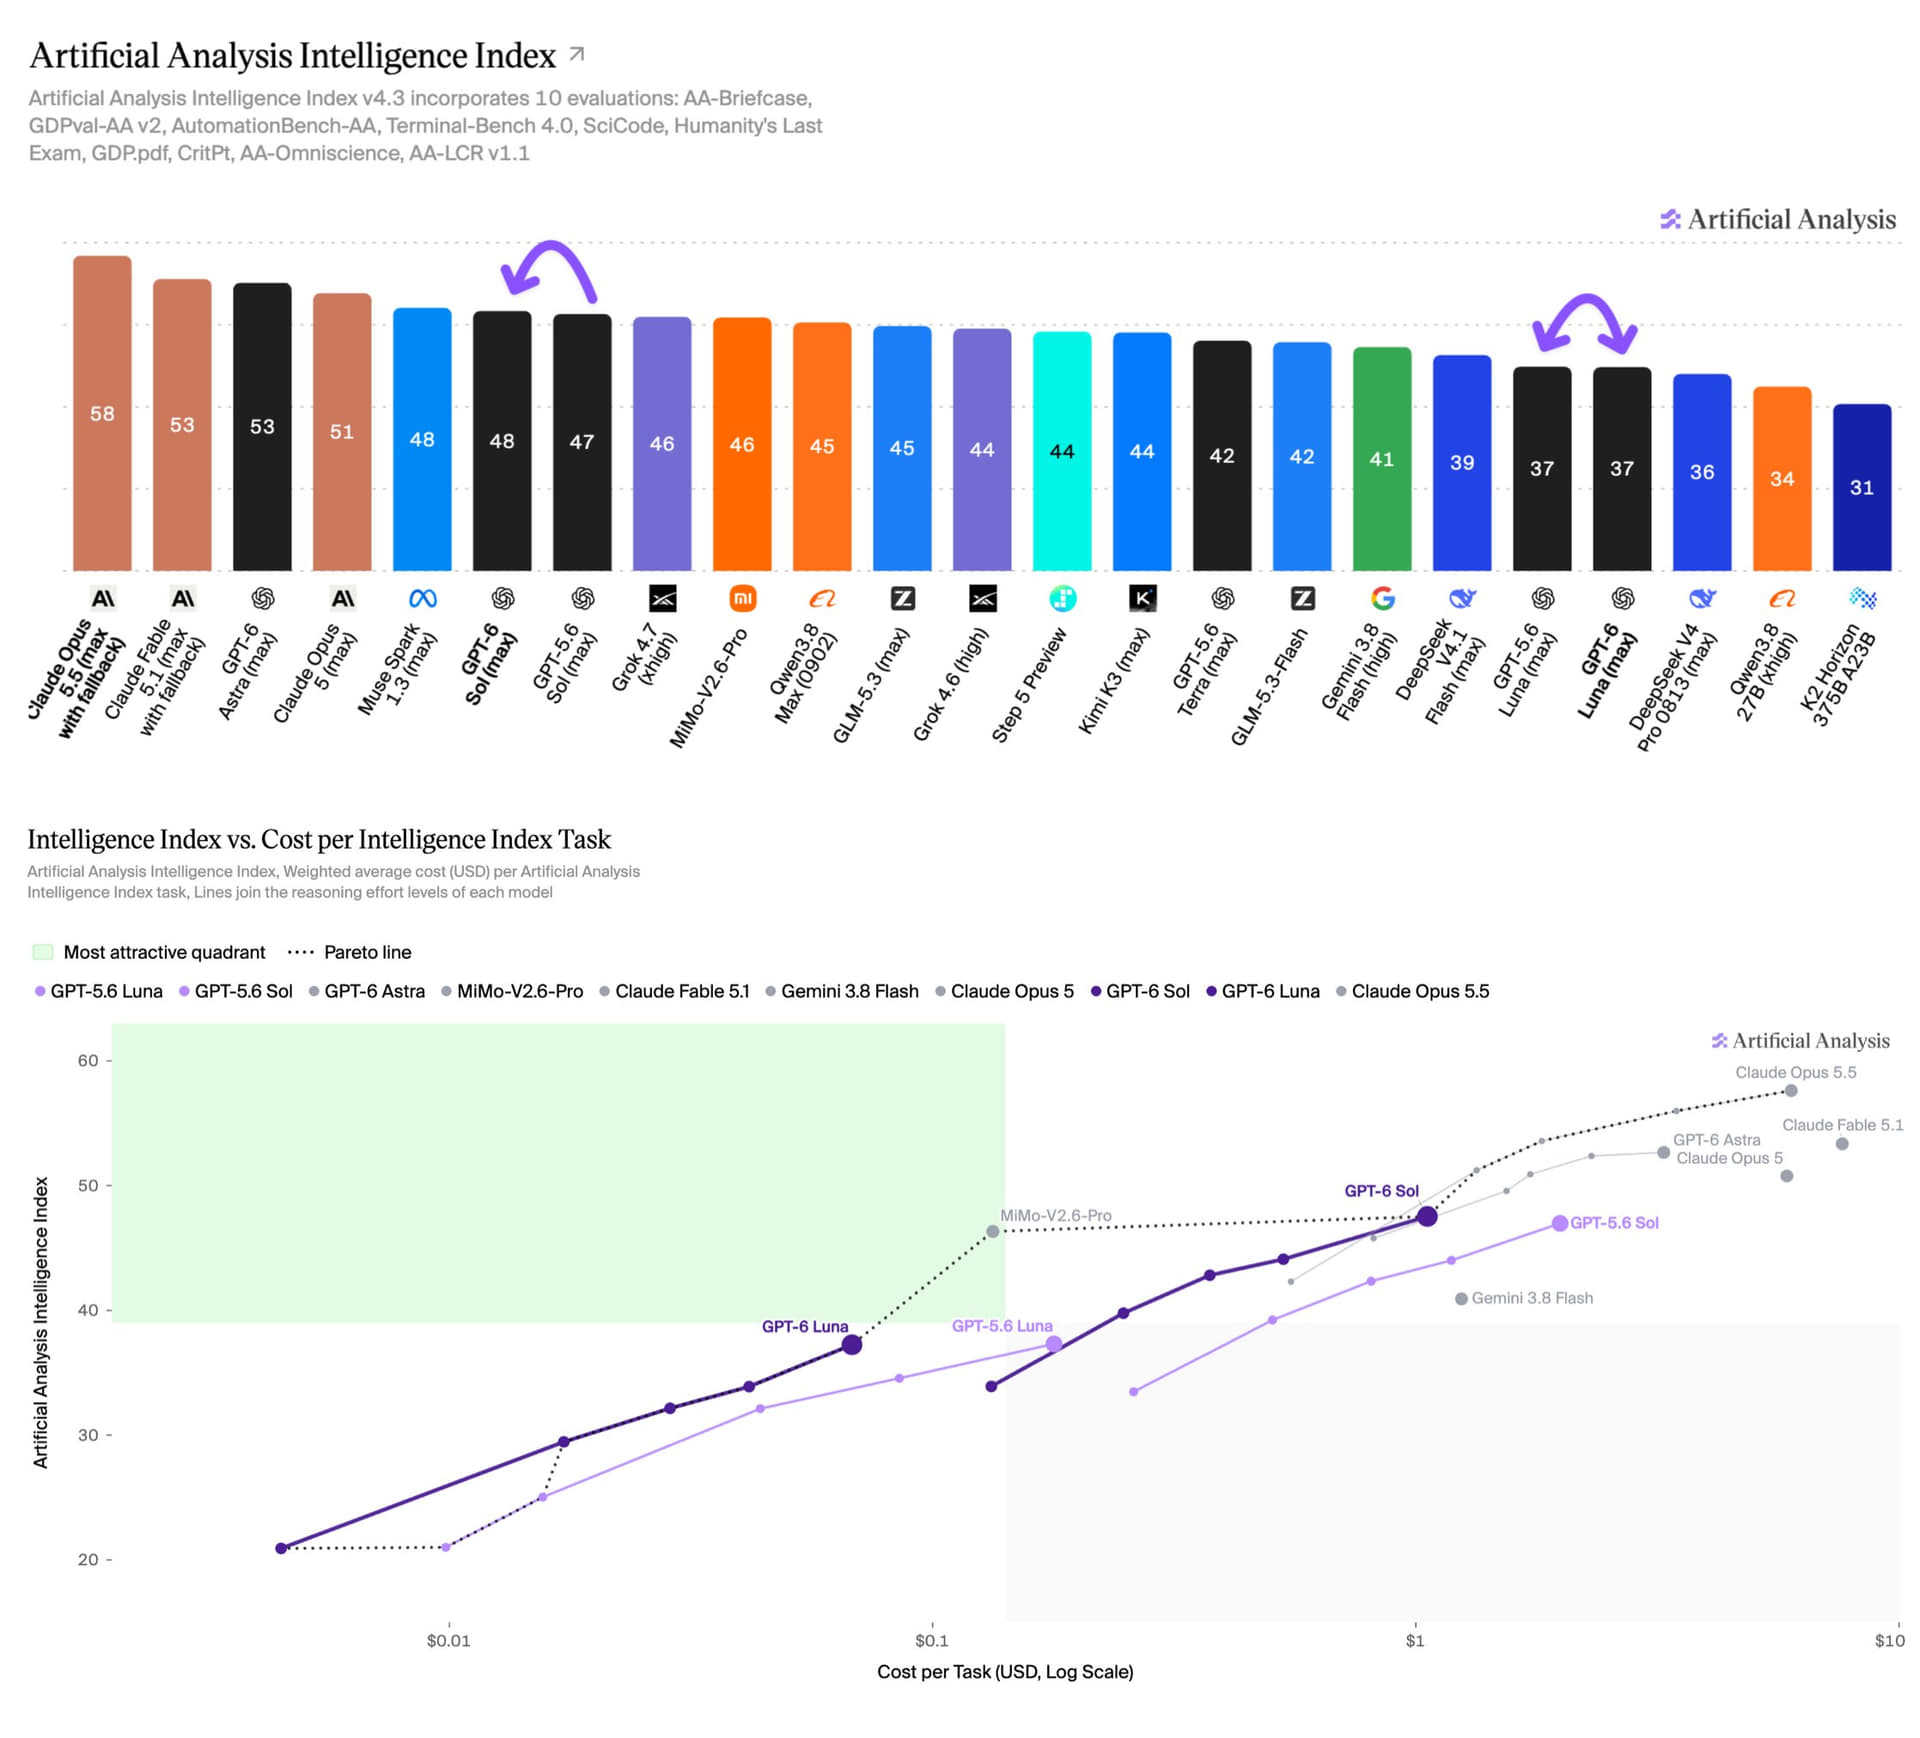
根据 Artificial Analysis 的数据,GPT-6 Sol 和 Luna 的单任务成本相较前代砍半,但智能分数仍维持在 GPT-5.6 的水平,部分评估有提升,部分则有倒退。在编程智能体指数上,Sol 提升了 2 点,而 Luna 则下降了 2 点。
在 Artificial Analysis 智能指数上,GPT-6 Sol 较前代从 47 分升至 48 分,而 Luna 维持在 37 分。真正的差异在于单任务成本大幅降低,如下图所示。| 图片来源:Artificial Analysis
Artificial Analysis 还在两项关键知识工作基准上发现了倒退。在 GDPval-AA v2.1(跨 44 个专业领域测试基于计算机的知识工作)中,Sol 损失了约 100 Elo 分,Luna 下降了约 75 Elo 分。人工检查发现倒退主要源于呈现质量下降和结果不完整。
不过,Artificial Analysis 此前也遭受过批评——因其对 OpenAI Astra 模型的评分过低,原因是基准测试过时。随后进行了两次基准更新,Astra 重新回到榜首。这次会如何还有待观察。
无论如何,有一点非常清楚:OpenAI 在 GPT-6 Sol 和 Luna 上大力押注价格。现在这些模型需要在日常工作中证明自己,因为基准测试只讲了故事的一部分。这或许也能解释为什么 OpenAI 省略了部分基准测试。加上不同的推理级别以及有时看起来像是为基准测试量身定做的结果,无论是否有意为之,整个基准测试游戏在每次新模型发布时似乎都变得更加荒谬。
AI 新闻,去除炒作——人工精选
订阅 THE DECODER,享受无广告阅读、周报 AI 通讯、六期年度独家「AI Radar」前沿报告、完整档案访问以及评论区域。