前端进阶之旅前端进阶之旅
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片NEW
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 业务场景题真实业务问题与追问
  • 查漏补缺常见问题解析
  • AI 模拟面试NEW模拟真实面试 + 报告
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
    • AI 定制路线NEW按你的简历现排
    • AI 知识地图NEW串起全站知识点
  • 动态
    • AI 热点NEWAI 每日动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
AI 助手NEW
旧版
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片NEW
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 业务场景题真实业务问题与追问
  • 查漏补缺常见问题解析
  • AI 模拟面试NEW模拟真实面试 + 报告
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
    • AI 定制路线NEW按你的简历现排
    • AI 知识地图NEW串起全站知识点
  • 动态
    • AI 热点NEWAI 每日动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
AI 助手NEW
旧版
返回 AI 情报前线
All News · 全部资讯8742
  • 小米开源 MiMo-V2.6:万亿参数开源模型登顶榜
  • AI Agent 工具 API 设计指南
  • 一个浏览器扩展权限即可劫持五大 AI Agent
  • Claude Opus 5.5 主打端到端代码补全而非起步
  • GPT-6 Sol发布:对齐能力逼近Astra,价格仅五分之一
  • GPT-6 Sol/Luna编程能力比肩Claude,成本降80%
  • Claude Opus 5.5发布:性能对标Fable 5.1,成本低40%
  • Claude Opus 5.5:编程修复成功率达97.5%,成本降40%
  • 开源工具llm 0.36支持GPT-6 Sol/Luna
  • JetBrains押注Agent开发:称其为26年最重要一步
  • 为 AI 代理添加预算守卫的实战方案
  • OpenAI GPT-6 Sol和Luna模型上线Amazon Bedrock
  • OpenAI发布GPT-6 Sol和Luna,API价格减半
  • OpenAI 发布 GPT-6 Sol/Luna 模型,Token 价格减半
  • GPT-6 Sol/Luna 正式发布:成本更低、错误更少
  • OpenAI 发布 GPT-6 Sol/Luna,主打低成本低幻觉
  • Claude Opus 5.5 登陆 Google Cloud,在 Model Garden 可用
  • Claude Opus 5.5 现已在 AWS Bedrock 可用
  • Strands Evals + Bedrock AgentCore:Agent 技能选择评估指南
  • llm-anthropic 0.29支持Claude Opus 5.5
  • Claude Opus 5.5发布:性能持平Fable 5.1,定价直降40%
  • GitHub Copilot上线Claude Opus 5.5,支持长时Agent任务
  • GitHub Copilot 新增 GPT-6 Sol/Luna 模型选项
  • Claude Opus 5.5 智能/性能/价格深度分析
  • Anthropic发布Opus 5.5降价20%,但Agent调用可能暗中路由至旧模型
  • Anthropic称Opus 5.5为「史上最强」,定价更低的Fable级性能
  • Anthropic 发布 Claude Opus 5.5:强化网络安全防护,遏制越狱行为
  • Claude Opus 5.5 正式发布:832 分成社区热议
  • 生产级 AI 语音 Agent 架构:WebSocket 与延迟优化实战
  • Permission Envelope:让 AI 权限自动过期的安全控制机制
  • llm-typesafe插件支持Jev模型二元判断
  • Python AI Agent 上线前必读:测试、可观测性与零成本方案
  • Cloudflare Worker Previews:为 Agent 每次变更提供隔离预览环境
  • NVIDIA Isaac ROS 5.0 发布:加速 Agentic 机器人开源开发
  • Meta Muse macOS 应用零日漏洞遭修复
  • 小米6天烧2000万训练开源模型MiMo,跃居开放模型榜首
  • LLM应用输入输出Guardrails实战指南
  • Claude发现libheif堆缓冲区溢出:HEIC图片供应链安全研究
  • 多模型调度与反馈闭环:基元律动CTO谈Agent持续进化
  • 阮一峰科技周刊第413期:再见了React Native
  • 用Python/ChromaDB/Gemini搭建轻量级RAG实战
  • 生产环境中降低LLM成本的七种实战方法
  • AI驱动开发反思:过度规格化反而拖累AI编程
  • AMD ROCm:AI Agent正在降低GPU编程门槛
  • 小米MiMo-V2.6-Pro登顶开源权重模型榜首,300万美元预训练
  • 四Agent并行:状态文件是保持一致性的关键
  • 长任务前何时压缩上下文:Claude Code实战经验
  • 5美元/月自建Qwen2.5 72B推理服务:vLLM+AWQ量化部署指南
  • Prompt缓存失效的根因:工作流在悄悄破坏精确前缀匹配
  • NVIDIA SoL-Pi:编码Agent的Token流量降低49%的Auto-Research框架
  • Grok 4.7 发布:更大基座、同价位,编程与 Agent 任务升级
  • 已加载 51 / 8742
8.0
热点
AI SCORE
模型发布2026-09-23 01:11

Claude Opus 5.5发布:性能持平Fable 5.1,定价直降40%

The Decoder#Anthropic#Claude#大模型
Editor brief · 编辑速览

Anthropic新一代Opus模型亮相,基准测试多数任务追平Fable 5.1,运行成本较Opus 5降低约40%,并承诺减少「Claudish」写作风格。

文章思维导图
Knowledge map
拖拽缩放
Full translation

完整中文译文

更新 – 2026 年 9 月 22 日

已补充 Artificial Analysis 基准测试结果

Anthropic 正式发布 Claude Opus 5.5,这是全新模型系列的首款产品。公司表示,它在保持与 Claude Fable 5.1 相同性能水平的同时,运营成本显著降低,且运行速度比前代更快。

Anthropic 声称,Opus 5.5 在"大多数任务"上与 Claude Fable 5.1 持平,但运行成本比 Opus 5 降低约 40%。Claude Sonnet 5.5 和 Haiku 5.5 预计在接下来几周内推出,在性能、效率和安全性方面将有类似提升。Anthropic 的基准测试显示,这款新 Opus 模型在大多数任务上领先于 Fable 5.1 以及OpenAI 定价高得多的 GPT-6 Astra。

Anthropic 表示,新系列主要回应了客户在成本、效率和沟通质量方面的反馈,尤其涉及金融服务、法律和软件开发领域。

价格下调与 token 用量减少降低运营成本

Anthropic 将 Opus 5.5 的定价调整为每百万输入 token 4 美元、每百万输出 token 20 美元,而 Opus 5 分别为 5 美元和 25 美元,降幅为 20%。同时缓存读取费用降低了 60%。

Anthropic 表示,综合 token 价格和 token 用量来看,总运营成本比 Opus 5 降低约 40%。新模型 token 消耗更少,输出生成速度快出 30% 以上。

订阅者的 5 小时用量限制将提升 20%。结合模型成本的下降,Anthropic 表示整体可用时长增加 25%。用户也可以保存一次用量重置,留待最需要的时刻使用。

Anthropic 正在用编程基准测试来证明其在价格和性能上的优势。在 FrontierCode 上,公司称 Opus 5.5 以约 20% 的单任务成本击败了 OpenAI 的 GPT-6 Astra。在 Terminal-Bench 4.0 上声称以 40% 的成本达到与 Astra 同等的性能。在 CursorBench 上声称 Opus 5.5 以三分之一的成本领先 GPT-5.6 Sol 达 11 分。

此次降价是对来自 OpenAI、尤其是中国 AI 模型的压力做出的回应——后者性能稍逊,但成本仅为其零头。

Anthropic 承诺减少"Claudish"风格

Opus 5.5 在沟通方式上也比前代模型更加自然。Anthropic 表示,它将最重要信息放在首位,用更少的行话,并更严格地遵循写作指令。早期测试者描述其写作更清晰、更易理解,Anthropic 称这使它成为长时间工作任务的更好搭档。当前的 Claude 模型因其公式化、绕来绕去的写作风格而备受批评,这种风格有时被称为"Claudish"。
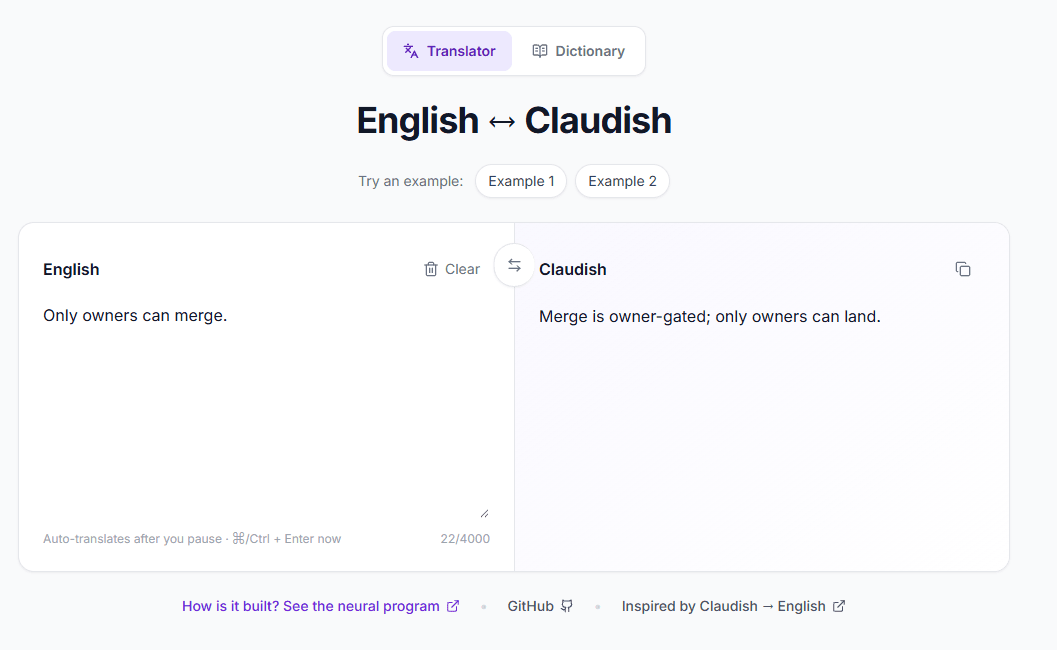
Screenshot via PAW

Opus 5.5 也是首款在网络安全、生物学和前沿 LLM 开发方面拥有与 Fable 5.1 同等安全防护的 Opus 模型。当这些安全防护触发时,Anthropic 表示请求将被透明地路由到另一个模型。

用户仍能在代码中查找和修复 bug,但大多数网络安全任务将被送往较老的 Opus 4.8。被分类器标记为生物学或前沿 LLM 开发相关的请求将被送往 Opus 5。

通过验证的组织可以通过生命科学验证计划(Life Sciences Verification Program)申请将该模型用于生物研究。Anthropic 计划在未来几周内将其现有的网络验证计划(Cyber Verification Program)扩展至 Opus 5.5。

Claude Opus 5.5 现已在所有平台上可用,包括 Amazon Web Services、Google Cloud 和 Microsoft Azure。使用 Claude Platform 的开发者可以通过模型 ID claude-opus-5-5 访问该模型。

Anthropic 呼吁随着模型能力提升提高安全标准

Anthropic 计划对强化学习环境进行更严格的筛选。公司表示,有缺陷的训练环境是模型行为不对齐的主要原因。公司还在努力改进对齐奖励、自动化创建安全训练场景的方法,以及更强的安全和监控措施。

AI 实验室正在就是否加快发布更强能力的模型展开讨论。OpenAI 最近呼吁为能够自我改进的 AI 系统制定国际标准,而多位研究者公开敦促实验室放慢发布速度,直到对齐方法赶上。Anthropic 采取了类似立场,呼吁对能够完全自动化 AI 研究的模型制定更高的安全标准。公司表示,公共政策应在制定该标准方面发挥更大作用。外部组织 Frontier Design 和 METR 在 Opus 5.5 发布前对其进行了测试。

新限制措施打击蒸馏并符合欧盟 AI 法案

Anthropic 还推出了一系列打击所谓蒸馏攻击的措施。公司表示,攻击者使用数千个虚假账户以工业化规模提取模型能力,并构建不受其安全防护约束的高能力模型。Anthropic 引用了 2026 年 9 月的一份威胁报告,记录了其迄今已检测并阻止的非法蒸馏活动。

Opus 5.5 推出了"保留思考"(Preserved Thinking),这是随 Fable 5.1 首次引入的反蒸馏措施。它防止 API 用户通过编辑 Claude 的先前上下文来提取其推理过程。该措施适用于 Fable 5.1 和 Opus 5.5,适用于 2026 年 8 月 31 日或之后创建的 API 账户。

Opus 5.5 还包括水印措施以符合欧盟 AI 法案。该模型不再能在"思考"(Thinking)模式关闭的情况下运行,且以零数据保留(Zero Data Retention)方式提供。

Artificial Analysis 将 Opus 5.5 置于智能指数榜首

独立平台 Artificial Analysis 证实了 Opus 5.5 的强劲表现。在最大努力(max effort)模式下,该模型在 Artificial Analysis 智能指数中得分为 58,为历史最高分,比之前的领先者高出数分。它在十项评估中领先六项,包括 Humanity's Last Exam 的 61.4%(之前最佳:59.1%,Fable 5.1)和 SciCode 的 66.9%(63.1%,同样是 Fable 5.1)。在 Terminal-Bench 4.0 上,Opus 5.5 达到 59.6%,与 GPT-6 Astra 持平,比 Opus 5 高出 11 分。

Claude Opus 5.5 以 58 分领跑 Artificial Analysis 智能指数,Claude Fable 5.1 和 GPT-6 Astra 以 53 分并列第二。在成本-性能图表(下图)中,多个 Opus 5.5 努力等级位于帕累托前沿。| 图片:Artificial Analysis
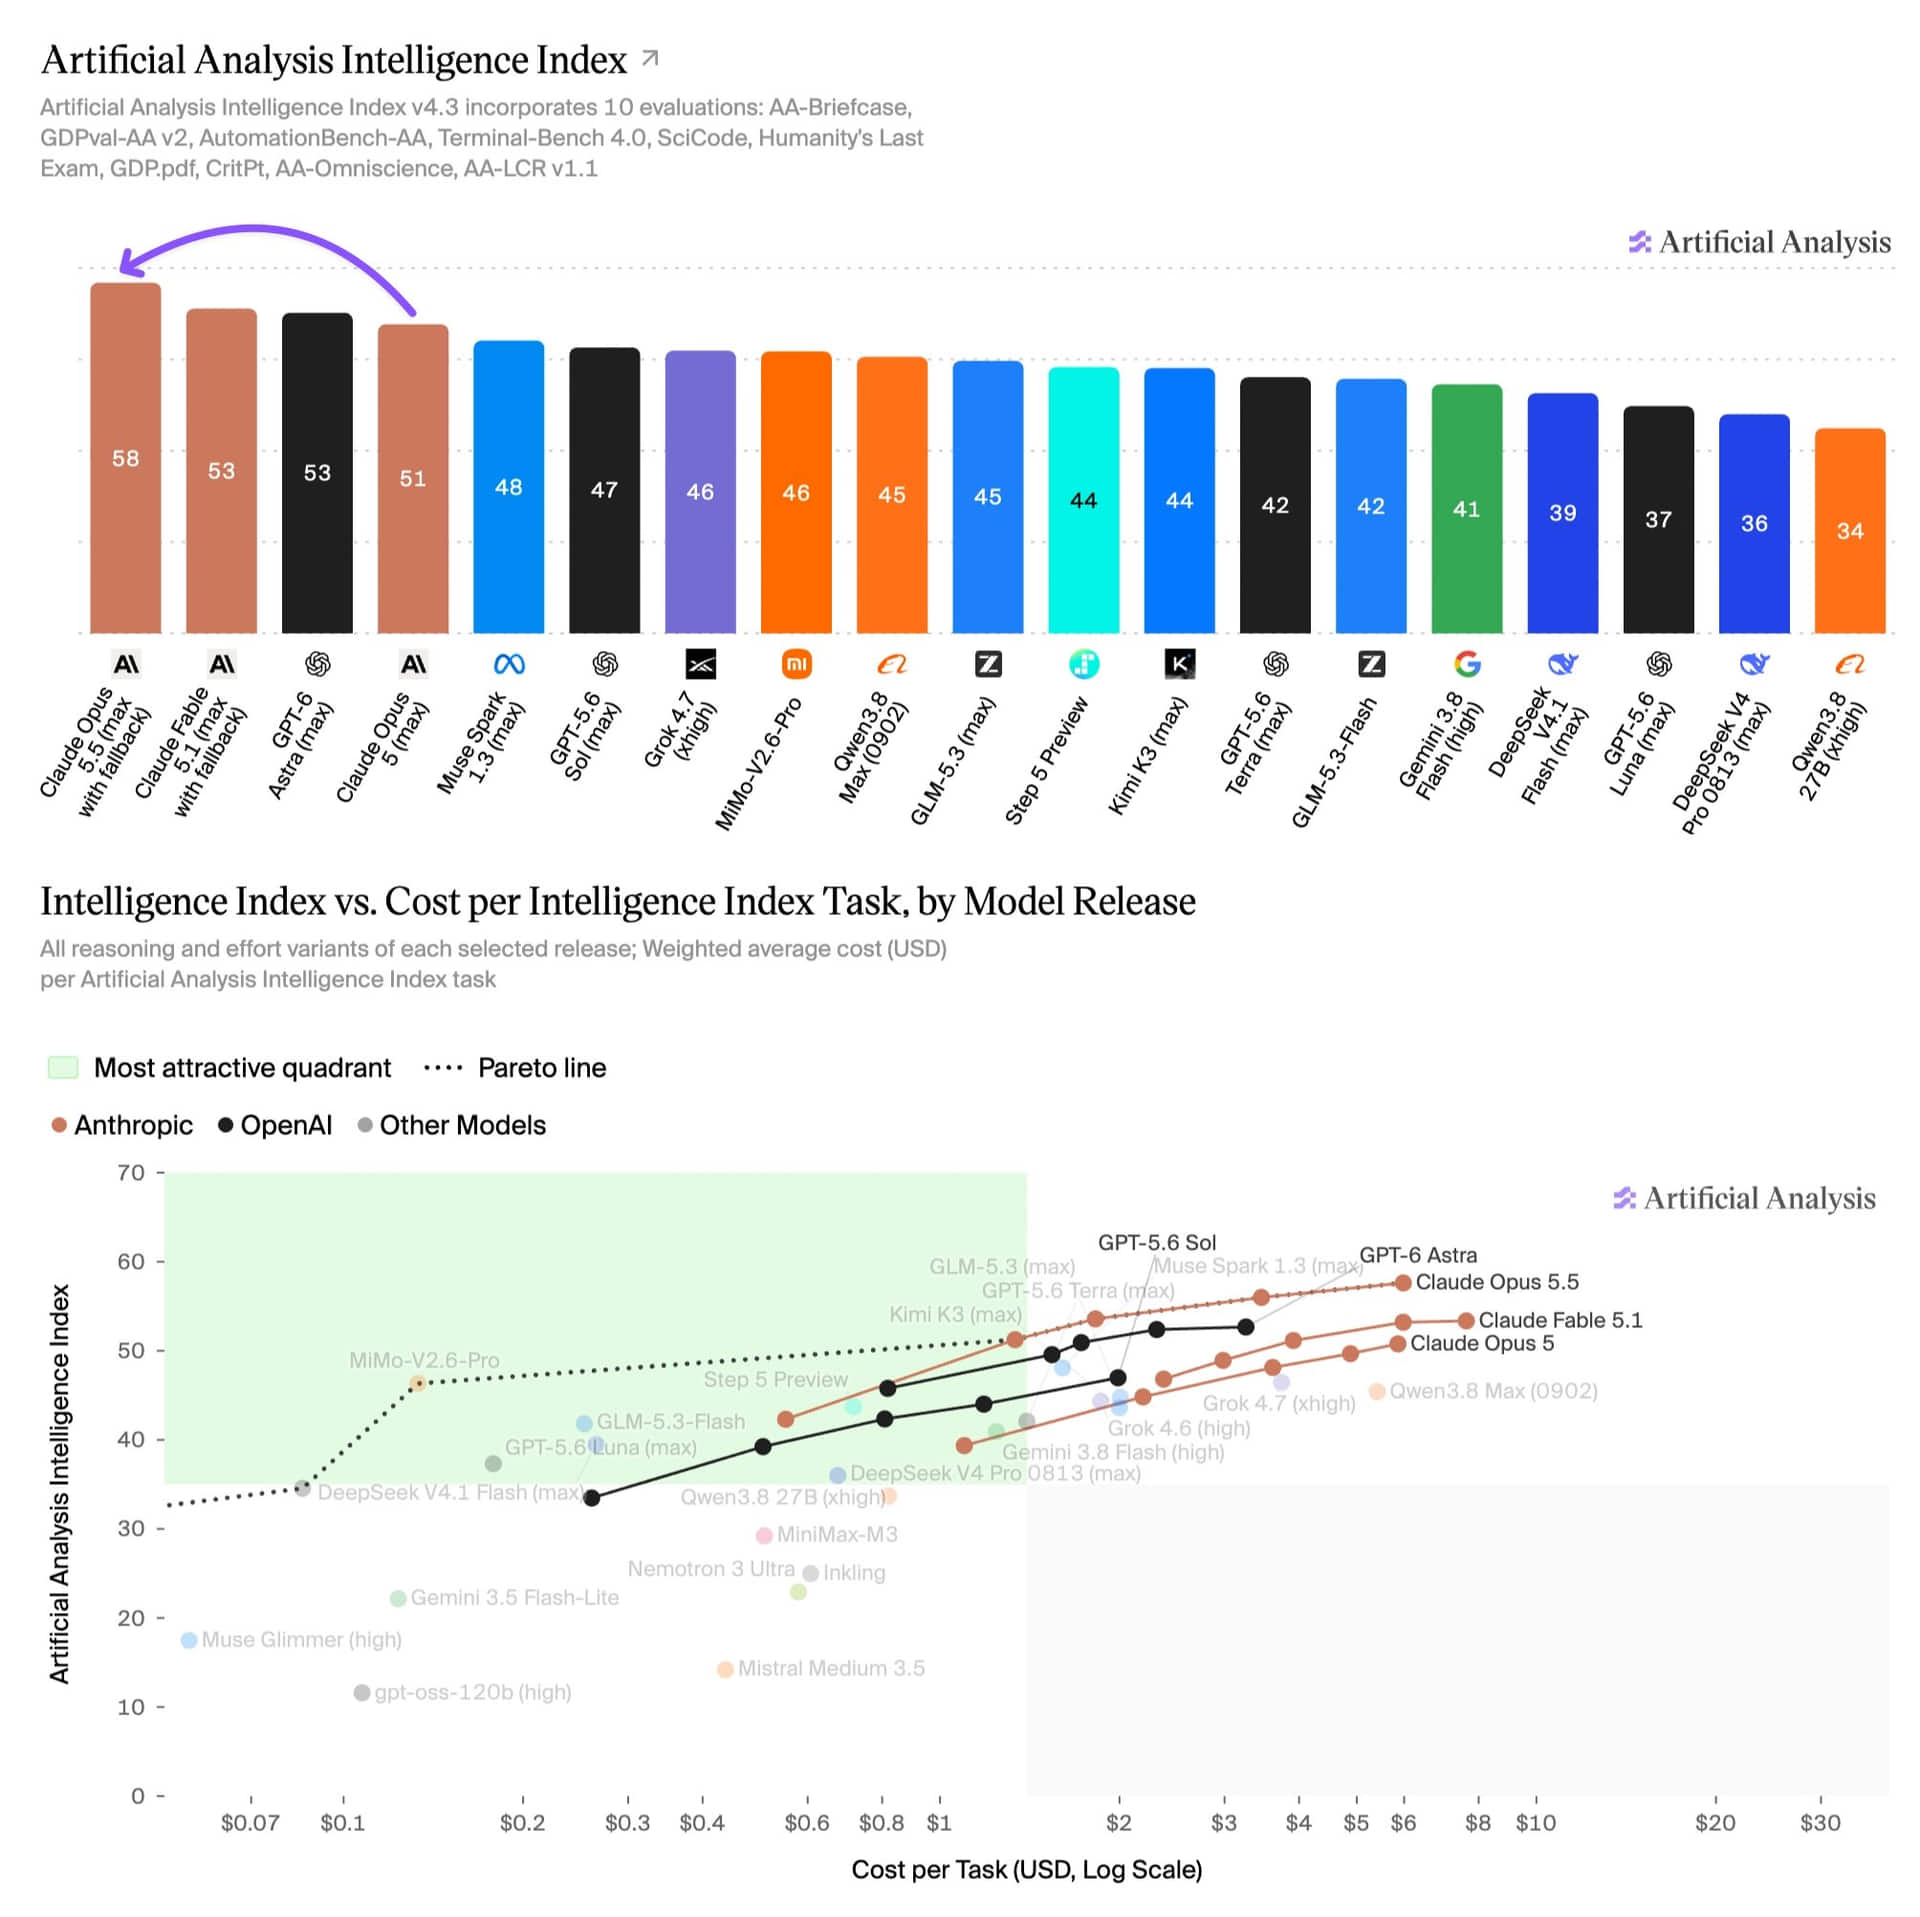
Claude Opus 5.5 leads the Artificial Analysis Intelligence Index with 58 points, followed by Claude Fable 5.1 and GPT-6 Astra at 53 each. In the cost-performance chart (bottom), several Opus 5.5 effort levels sit on the Pareto frontier. | Image: Artificial Analysis

Artificial Analysis 表示,Opus 5.5 使 Anthropic 在 Terminal-Bench 4.0 和 AutomationBench-AA 上与 GPT-6 Astra 持平,同时在代理式知识工作方面扩大了领先优势。在私有基准 AA-Briefcase 上,Opus 5.5 达到 1822 的 Elo 分值,比 Fable 5.1 高出 143 分,这是 Anthropic 模型首次在演示质量上超越 GPT-5.6 Sol。在 GDPval-AA(OpenAI 的真实世界白领工作基准)上,Opus 5.5 在除"低"推理模式外的所有推理模式上均优于 Astra。

在 GDPval-AA v2.1 上,Claude Opus 5.5 在几乎所有努力等级下均以相同或更低的单任务成本实现了比竞争对手更高的 Elo 分数。只有在"低"设置下 Astra 才取得领先。| 图片:Anthropic
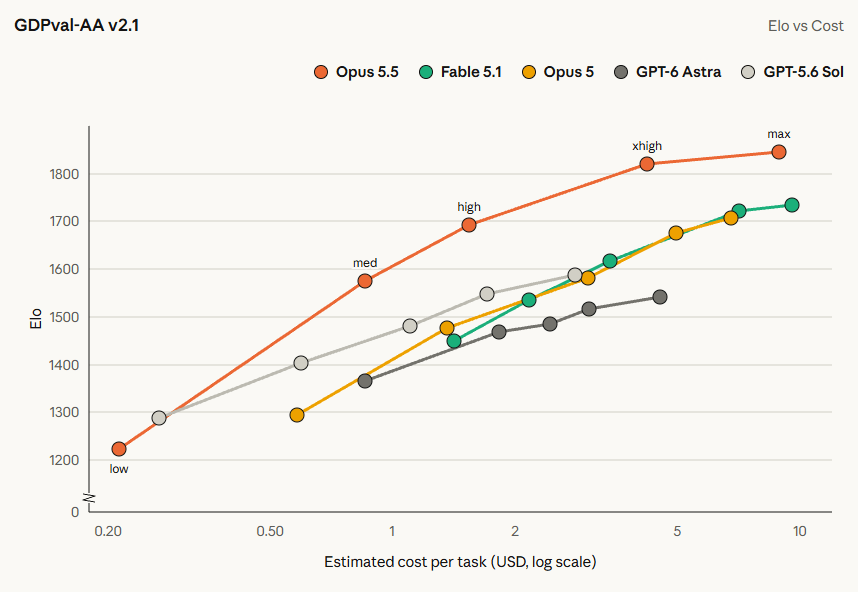
On GDPval-AA v2.1, Claude Opus 5.5 achieves higher Elo scores than competitors at comparable or lower cost per task across nearly all effort levels. Only at the "low" setting does Astra come out ahead. | Image: Anthropic

Artificial Analysis 也标注了一个效率权衡问题。在最大努力模式下,Opus 5.5 每任务消耗约 119,000 个输出 token,远多于 Opus 5(73,000)、Fable 5.1(78,000)或 GPT-6 Astra(27,000)。更低的 token 价格使其单任务成本与 Opus 5 持平,但并未更便宜。不过在帕累托前沿上有五个 Opus 5.5 努力等级中的四个,在成本-任务维度上匹配或击败指数上 50 分以上的所有其他模型。

AI 新闻无废话 – 人工精选

订阅 THE DECODER,享受无广告阅读、周报 AI 通讯、每年六期的独家"AI Radar"前沿报告、完整档案访问权限,以及评论区域访问权限。

Original source

本文由 AI 翻译整理自 The Decoder,原文版权归原作者所有。

阅读英文原文
上一篇
llm-anthropic 0.29支持Claude Opus 5.5
下一篇
GitHub Copilot上线Claude Opus 5.5,支持长时Agent任务