
8.0
热点
AI SCORE
编程提效2026-09-23 10:34
Text-to-SQL访问控制:身份决定Schema可见性
dev.to · AI#text-to-SQL#安全#数据库
Editor brief · 编辑速览
大多数text-to-SQL系统在查询写出后才做权限检查,导致未授权表仍在prompt中暴露。Schemagate通过先根据调用者身份筛选Schema再生成查询,将权限检查前置,PostgreSQL/Olacle/MySQL等均已认证。
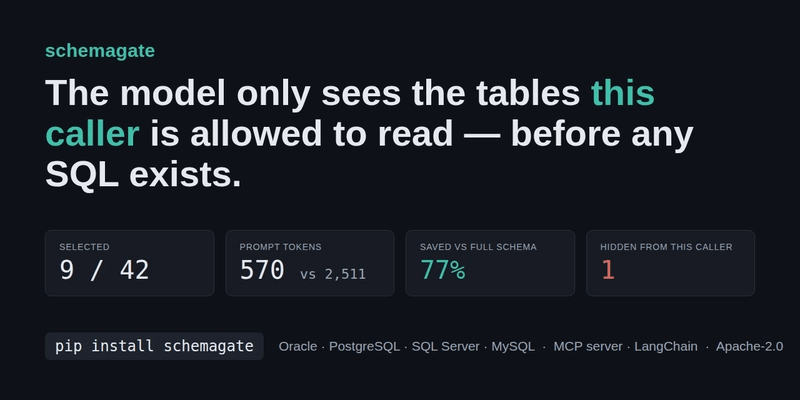
大多数 text-to-SQL 方案会把整个 schema 一股脑塞给模型,然后把访问检查放在查询写好之后。这个顺序本身就是 bug,而且它容易演示,不容易争辩。
一张图讲清楚核心思想
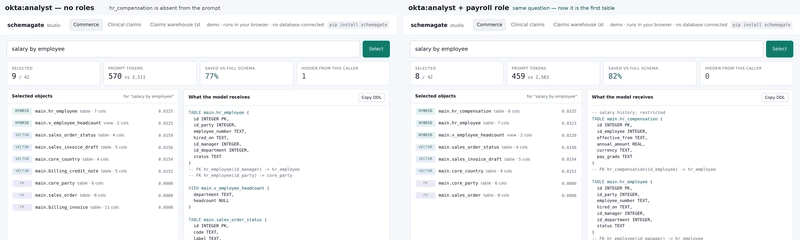
左图 —— 调用者没有任何角色。hr_compensation 压根不会到达模型:42 个对象中被选中了 9 个,prompt token 消耗 570 个而非 2,511 个,且有一个对象对这个调用者隐藏了。
右图 —— 相同的问题、相同的 schema、相同的数据库。调用者现在持有了 payroll 角色,于是 hr_compensation 成为 prompt 中的第一个表,没有任何东西被隐藏。
问题本身没有任何变化。变化的是身份。
在真实 schema 上运行

这是 Studio 在一个 claims schema 上的表现:从 51 个对象中选出了 14 个,prompt token 消耗 1,212 个对比完整 schema 的 3,237 个,且有三个对象被扣留 —— 因为这个调用者既没有 actuarial 也没有 phi 权限。被限制的对象列在左侧,这样你能看到被扣留的是什么,而不必靠猜。
pip install schemagate
SQLite、PostgreSQL 16、Oracle 26ai、SQL Server 2022 和 MySQL 8.4 均已通过实盘实例认证。此外还有一个 MCP server —— 现已收录于官方 MCP registry ——、一个 LangChain retriever 以及一个 CLI。
选择步骤的效果取决于其检索质量,而我的检索并非业界顶尖。在 Spider(汇聚为一个 catalog,876 张表,且问题本身没有提示属于哪个数据库)上,金表(gold table)在 top 10 中的命中率为 82.6%。在 Spider 2.0-lite(这是真实的 BigQuery 和 Snowflake schema,而非基准测试用 schema)上,247 道可用问题全题的 top 10 命中率为 64.0%。这两个数字、测试 harness,以及过程中我不得不修正的两种测量误差,全部记录在 BENCHMARKS.md 中。
Apache-2.0: github.com/ashishsinha1602/schemagate