
8.0
热点
AI SCORE
开源项目2026-10-08 20:00
JetBrains开源Mellum2.1:面向编程Agent的12B MoE模型
JetBrains AI Blog#JetBrains#开源#编程模型
Editor brief · 编辑速览
Mellum2.1是12B MoE模型(2.5B活跃参数),通过真实环境强化学习训练,专为编程Agent和本地高速子Agent设计,已完全开源。
通过在真实环境中进行强化学习训练,Mellum2.1 专为编码 Agent 和在你的自有硬件上运行的高速子 Agent 设计。
今天,我们正式发布 Mellum2.1,这是今年 6 月开源的 12B 混合专家模型的下一个版本。自 2.0 版本以来架构没有变化:它仍然是一个紧凑、高速的模型,拥有 25 亿活跃参数,基于 Apache 2.0 许可证发布。发生变化的是预训练之后的所有环节。
Mellum2 很快,但它无法在我们期望的级别上在代码仓库内工作。经过一个夏天在真实环境中的强化学习,在数千个环境中运行了数百万次沙盒之后,Mellum2.1 可以做到:它能探索代码库、编辑文件并检查自己的更改。
这个版本几乎所有工作都投入到了后训练阶段,主要是大规模强化学习(RL)。
大规模强化学习:RL 从一个简短的最终阶段变成了训练的主要部分。我们在如何训练方法和数据方面进行了大量实验,并保留了经受住考验的部分。
更多数据,更严格的过滤:我们在数学、竞赛编程、科学、工具使用和软件工程领域添加了新的 RL 任务,将开源 RL 数据集与我们自己构建的任务相结合。开源数据通常伴随着损坏的测试、无法验证的答案,或者对模型来说太简单或完全不可能完成的任务,因此在进入训练之前会对每个数据源进行过滤。
用于 Agent 技能的真实环境:我们构建了基础设施来在内部运行数千个 RL 环境,并在整个训练过程中启动了数百万个沙盒。
我们将 Mellum2.1 与 Mellum2 以及两个同类开源模型 Qwen3.5-9B 和 Gemma 4 E4B 进行了比较,使用相同的评估设置。
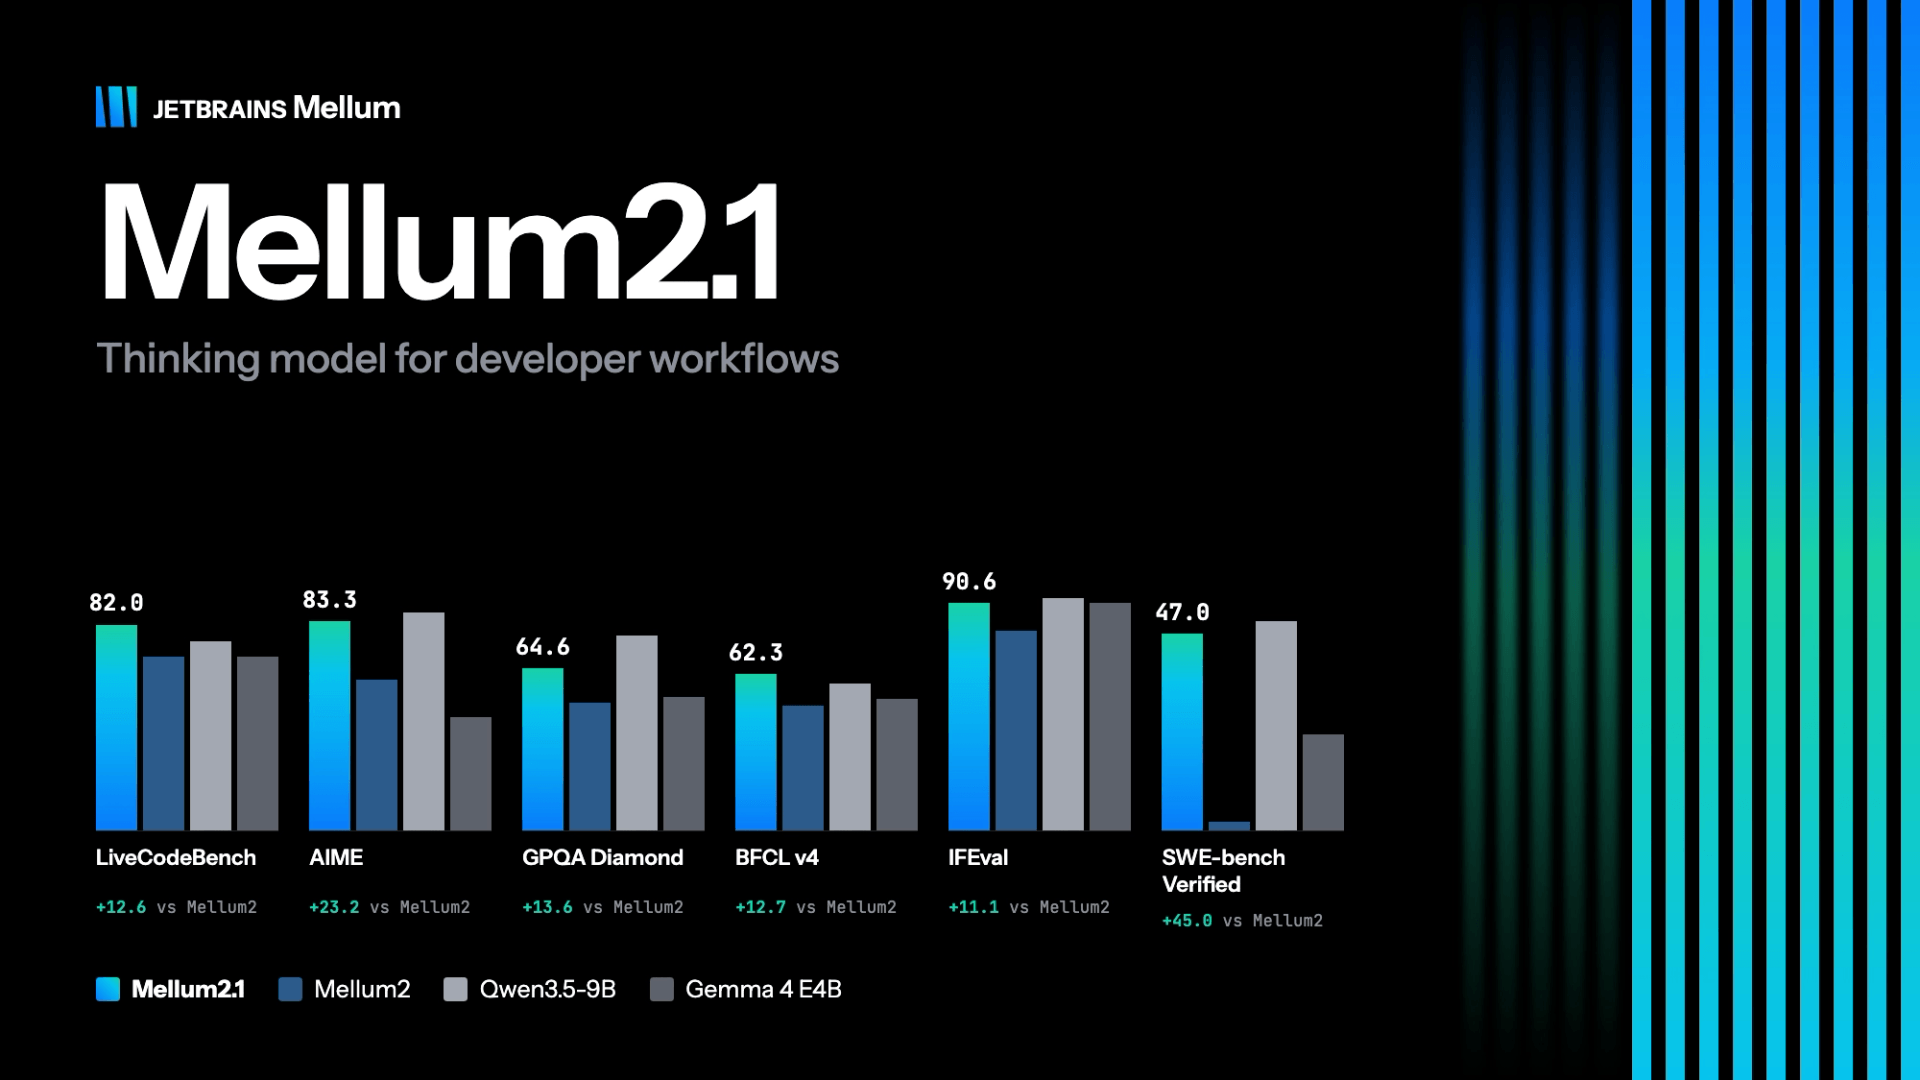
最大的改进体现在 Agent 编程能力上,Mellum2.1 相比 Mellum2 在这方面进步最大。该模型在各领域也有全面提升,在编程、竞赛编程、数学、工具调用和通用知识方面都表现出进步,在难题和日常问题上的表现同样稳健。
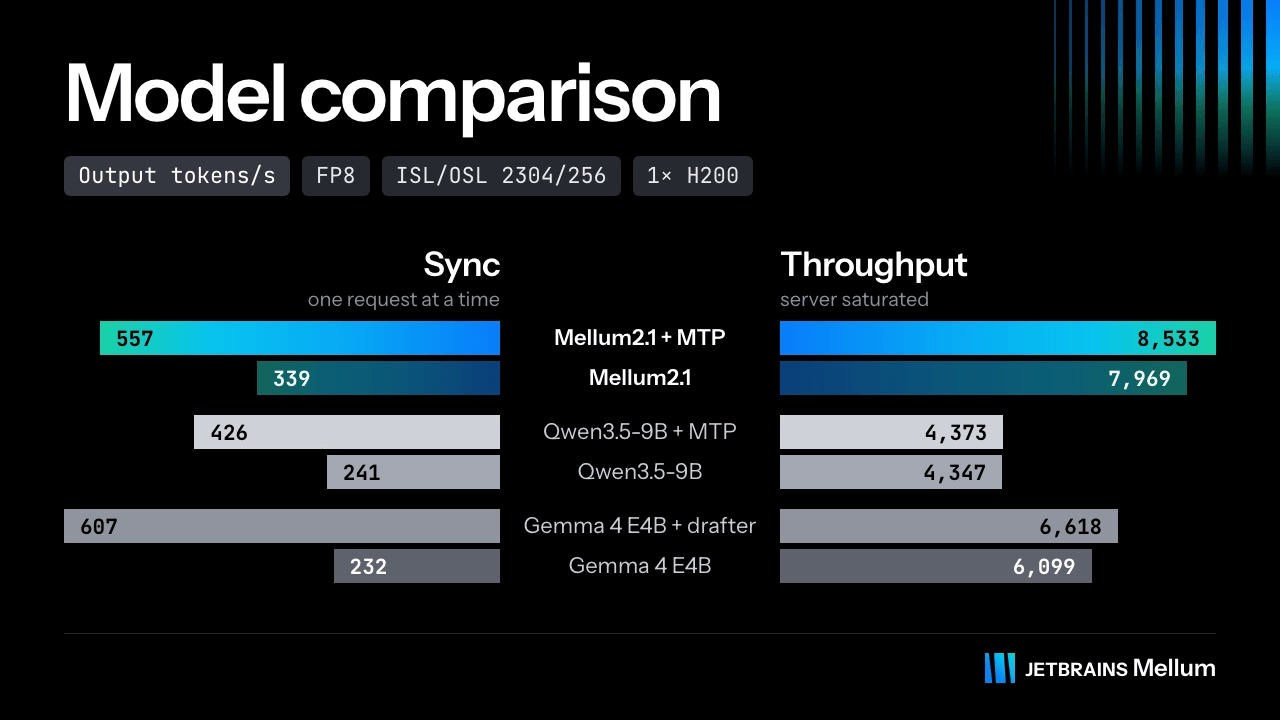
后训练没有改动架构,所以 Mellum2.1 和 Mellum2 一样快,而多令牌预测(MTP)让它更快。
在高负载下,Mellum2.1 是该组中速度最快的模型,吞吐量几乎是 Qwen3.5-9B 的两倍。对于单个请求,MTP 让它快约 1.6 倍。
Agent 系统中的能干工作者:Mellum2.1 可以处理 Agent 计划的不同环节,从识别测试失败的根因到起草和检查修复方案。
编程之外的问题:Mellum2.1 也是一个称职的通用助手。它处理日常问题,也能逐步解决困难的数学和推理问题。
私有化自托管部署:在本地或你自己的基础设施上运行 Mellum2.1,完全掌控代码和数据。
Mellum2.1 已在 Hugging Face 上发布。面向 llama.cpp、Ollama 和 LM Studio 的 GGUF 构建,以及面向 vLLM 推测解码的多令牌预测(MTP)头的支持,即将推出。
如果你正在构建编码 Agent、子 Agent 或在你自己的基础设施上运行的 AI 工具,我们非常希望你来试用 Mellum2.1。告诉我们什么运行良好、什么不如预期。你的反馈将塑造下一个版本。
开源是打造更好模型的方式。
谢谢,我们为你保驾护航!
今天,我们正式推出 JetBrains Context,这是一个新的代码库智能层,帮助编码 Agent 在复杂代码库上更高效地工作并产出更高质量的结果。作为 JetBrains AI for Teams and Organizations 推广的一部分,JetBrains Context 现已面向早期用户开放……
我们在 JVM、.NET 和 Python 上对编码 Agent 进行了评估——Codex 是最终胜出的 Agent。
Mellum2 从零开始训练,专为路由、问答、子 Agent 和软件工程系统中的私有 AI 使用场景设计。今天,我们开源 Mellum2,这是一个 12B 模型,旨在解决生产级 AI 最困难的部分:延迟、吞吐量和成本。……
推出 recap 和 insights,这是两个实验性 AI 功能,可以主动帮助你理解近期活动和你项目中不易察觉的代码。