
9.0
重磅
AI SCORE
模型发布2026-10-08 11:41
144M 小模型承担 Agent 82% 决策调用,绕过大模型降本 95%
dev.to · AI#Agent#小模型#开源
Editor brief · 编辑速览
开发者训练了仅 144M 参数的专用决策模型,输入结构化状态和选择题式问题,可在 CPU 上 1.5 秒内返回判决,将大多数 Agent 路由决策从昂贵的大模型中剥离。
或者说:为什么你的 Agent「要不要运行这条命令?」根本不需要一个 70B 的聊天模型。
我构建的每一个 Agent 工作流都会碰到同一堵墙:核心逻辑不过 10 行代码,剩下 90% 都在让语言模型反复回答「允许还是拒绝?」「选哪个工具?」「放行还是上报?」——每天成千上万次,按聊天模型的计价和延迟来跑。
所以我做了一个聊天模型的「反面」:Phocinae-Largha-150M-v1,一个 144.3M 参数的 typed decision model。它不能生成文本,只接收一个 state 外加一组带类型的问题(是/否、单选、1-10 分)然后一次前向传播返回每个问题的判决结果及校准后的置信度。GPU:每个决策 p50 仅 18.6 ms。纯 CPU:约 1.5 s,完全不需要显卡。开源,Apache-2.0 协议。
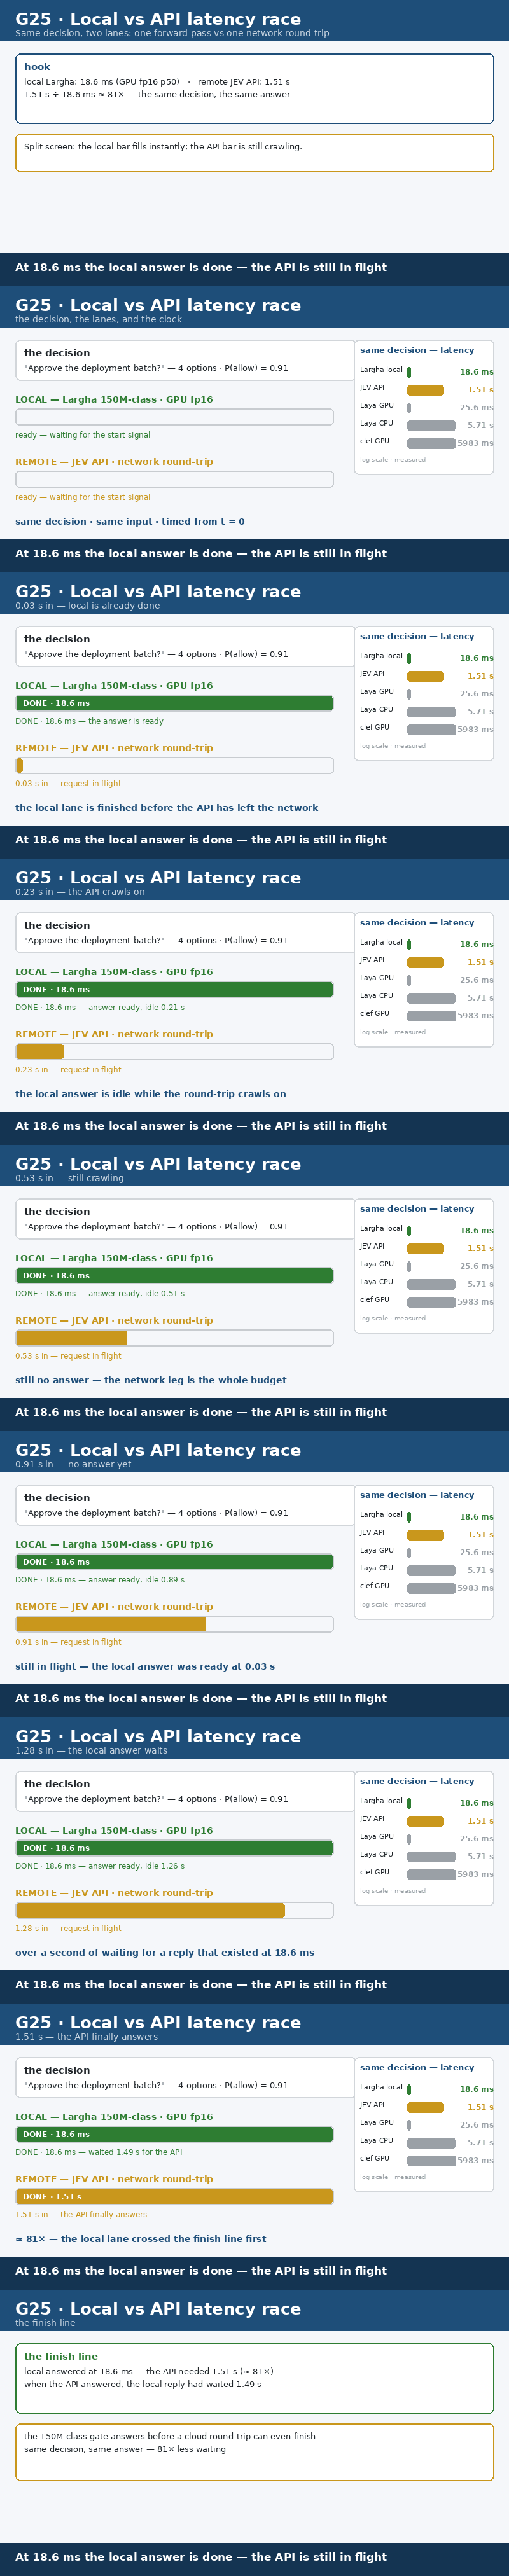
决策是对封闭选项集的带类型输出:
state: "agent wants to run: rm -rf /var/log/app"
question: { type: noul, qid: allow, options: [false, true] }
answer:  { allow: { label: false, prob: 0.96, confidence: 0.96 } }
这里没有句子要生成,没有思维链要输出,也不需要解析返回的格式。那为什么要租一个生成模型来做这件事?一个 150M 的 encoder(mmBERT-small base,256k 词表,Gemma tokenizer)做一次前向传播,输出每个问题对应的 label logits——这就是全部推理过程。结果是确定性的:相同输入,相同输出。不需要采样,不存在解析失败。
评估协议采用 typed-decisions(Laya 等项目也在用的格式),因此同一批数据上不同模型的得分可以直接比较。
英文 typed-decisions:0.797(400 个案例 / 2,000 次决策)。中文(机器翻译的评估集,无原生中文训练数据——已声明):0.789。同协议已发布分数:Laya 0.766 · JEV-27B 0.727 · meraGPT 0.768。
那些模型卡片通常跳过的指标,我们全部公开:
选项顺序翻转率:打乱选项顺序,答案会不会跟着动?reversed 0.0300 / random-mean 0.0233 / any-of-3 0.0433。大约每 ~33 次重排会改变一次答案。
校准度:shipped-column ECE 0.1313——原样公开,不藏掖。
JevBench public-231:0.5108(118/231)——未通过 58.4% 的准入门槛,照样公开。评估数据行从未用于训练。
小模型不需要完美——它只需要知道自己什么时候不完美。通过 τ=0.6 的置信度闸门,有把握的决策留在本地,其余的才上报给更大的模型。中文路由任务上的结果:LLM 调用次数减少 82%(从 100% 降到 18%),同时组合准确率从 0.789 升到 0.7948——把困难的 18% 路由上去之后,整个系统反而变好了一点点,不只是更便宜。
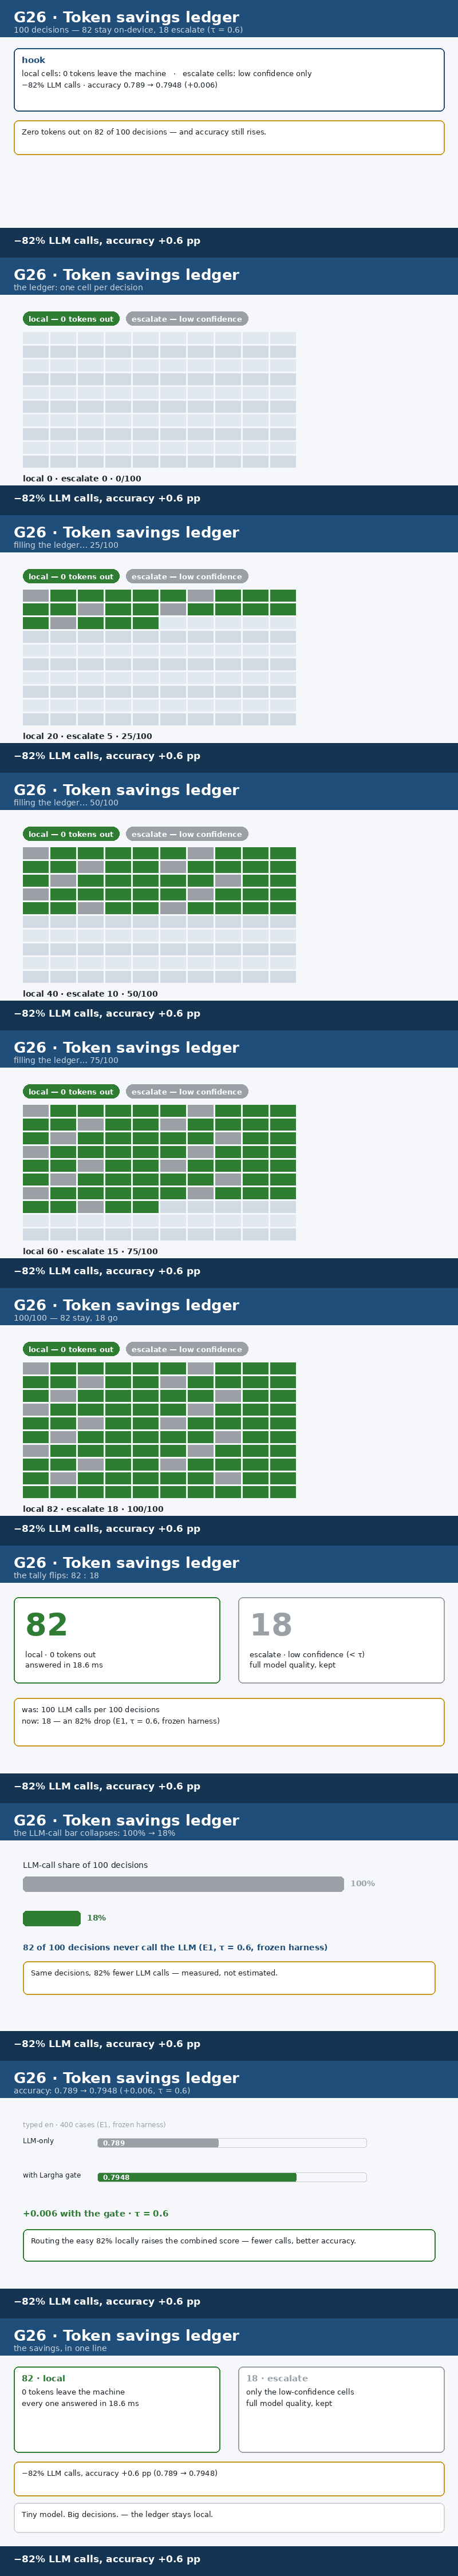
这是我想留给大家的框架:BERT 里的 System 1。Agent 的双系统架构不是「小模型 vs 大模型」,而是——对那重复性的 82%:typed、确定性、毫秒级、零成本;对那模糊的 18%:生成式、只在需要时才贵。
pip install phocinae-server huggingface_hub
huggingface-cli download Phocinae/Phocinae-Largha-150M-v1 --local-dir ./model
PHOC_MODEL_DIR=./model python -m phocinae.main
curl -s http://127.0.0.1:8155/v1/systemone \
  -H 'Content-Type: application/json' \
  -d '{"state":"The agent wants to run: rm -rf /var/log/app",
       "questions":[{"type":"noul","qid":"allow",
                     "question":"Allow this command?","options":["false","true"]}]}'
# → {"allow": {"label": "false", "prob": 0.96, "confidence": 0.96}}
服务仅监听本地(127.0.0.1),运行时纯 PyTorch,协议(/v1/systemone:noul / choice / score 各类问题,校准后的概率)完整定义在仓库里。此外还有 DeepSeek Harness 捆绑包(dsh-phocinae,npm),其中包含一个 PreToolUse 审批闸门,默认失败关闭。
它不是聊天机器人、不是生成器、不是长文档推理器。世界知识问答不是它该干的活。
中文数据行全部来自英文案例的机器翻译,没有任何原生中文训练行。
长输入会显著降级:16k/32k 探测得分分别只有 0.453 / 0.387。
JevBench 门槛未通过(这就是为什么这个数字要写在卡片上)。
目前还没有做人口统计学/公平性评估。
仓库(Apache-2.0,完整文档 + 27 个场景演示):Phocinae/Phocinae-Largha-150M-v1
权重:Hugging Face · ModelScope
复现:随机种子、行集哈希、环境和评估脚本均随仓库一起发布——每一个公开数字都可以重新推导出来。
如果你有一个主要涉及重复性决策的使用场景,我很想知道什么会最先出问题。