
8.0
热点
AI SCORE
编程提效2026-10-08 19:00
设计对AI Agent友好的可扩展API实践指南
The New Stack#API设计#AI Agent#工程实践
Editor brief · 编辑速览
探讨如何构建能被AI Agent高效调用的API结构,重点涉及响应格式、状态管理与工具调用设计。
如今,我们大多数人都以一种结构化的方式与前沿 AI 模型交互,尽管我们并不总是这样想。大多数系统已经架设在某种协议之上,这些协议通常由模型提供商自己创建。例如,OpenAI 和 Anthropic 都提供了与其推理系统通信的 API。
实际上,一种方法是使用 OpenAI 兼容的 API 来服务多轮 Agent。我们可以指向一个兼容的推理端点来使用官方 OpenAI SDK,与 Agent 进行对话,并在多轮对话中使用相同的接口。
这些系统以某种特定而巧妙的方式构建,使其能够扩展。当流量增长或子 Agent 产生时,我们需要扩展这些系统,以便作为工程师可以进行必要的调整而不被用户察觉。例如,当需要额外流量支持时,我们可以将单副本系统扩展到负载均衡器后面的三个副本,同时仍保留正确的对话上下文和之前的对话轮次。
"五年前人人都在谈论的微服务原则,恰恰正是 Agent 流量所需要的。"
我们将看看在 AI 流量突发情况下会发生什么。
在开发这些系统之前,我们需要问自己的许多问题已经在 2010 年代的微服务文献中得到解决。我们将展示如何从这些原则重建一个对 Agent 友好的 API,用 Oracle AI Database Free 作为后端,并测量会发生什么变化。
核心洞察:负载形态不同,而这种不同恰恰是有状态设计难以吸收的。
四个特性将 Agent 客户端与浏览器区分开来:
对话是长且有状态的,但请求不是。 一个 40 轮的 Agent 循环会产生 40 个独立的 HTTP 请求。协议中没有任何东西将它们绑定到同一台服务器。每个工具调用在 HTTP 层都是无状态的:端点随时间接收单个请求和响应,因此应用程序需要确定一个请求属于哪个对话及其状态存储在哪里。
工具调用不可预测地扇出。 一个聊天请求可能触发零个下游调用,也可能触发六个,其中一个命中向量索引并花费 400 毫秒。因为模型输出和工具调用路径可以变化,即使相同的输入也可能触发不同的调用顺序和数量。
Agent 会积极重试。 AI Agent 通常被包装在一个具有自身控制循环、错误处理和重试策略的 Agent 工具中。当发生超时或错误时,系统可能会收到来自同一工作负载的快速连续重试序列。这对弹性很有用,但也可能放大已经处于困境的依赖项的压力。
负载是突发性的且由机器节奏驱动。 轮次之间几乎没有思考时间。当 AI Agent 运行时,它可以生成连续的工作突发,主要受其周围的硬件和并发限制约束。
第 1 点是人们通常理解的:浏览器会话由于粘性和人类思考时间而存活在一台服务器上。Agent 可以快速连续发出许多请求,如果没有持久的共享状态,分布在各个副本上的请求可能会丢失它们所需上下文,从而给用户带来摩擦。
这里是一个端点的全部失败:
SESSIONS: dict[str, list] = {}
SLOTS = asyncio.Semaphore(int(os.environ.get("CONCURRENCY", "32")))  # one pool

@app.post("/v1/chat/completions")
async def chat(req: Request):
    body = await req.json()
    sid = req.headers.get("x-session-id") or body.get("user")
    async with SLOTS:                                 # everything shares it
        history = SESSIONS.setdefault(sid, [])
        history.append({"role": "user", "content": body["messages"][-1]["content"]})
        if body.get("tools"):
            await TOOLS[body["tools"][0]["function"]["name"]]()   # inline, in-path
        ...
这是一个正确、可工作、最简化的 OpenAI 兼容 API。装饰器确定当端点被调用时 following function 以异步方式运行。
这个最小化端点通过了所有测试,但有一个根本性缺陷。你能发现它吗?
在我们的 POC 基准测试中,我们驱动了 200 个对话,每个对话四轮,将每一轮轮流发送到下一个可用副本——当你没有正确配置粘性参数时,可以看到这种分配方式:
| 部署方式 | 轮次 | 上下文丢失 | 损失率 |
|---|---|---|---|
| Monolithic, 1 machine | 800 | 0 | 0.0% |
| Monolithic, 3 machines | 800 | 600 | 75.0% |
| Decomposed, 1 machine | 800 | 0 | 0.0% |
| Decomposed, 3 machines | 800 | 0 | 0.0% |
看看单机与三机的单体部署。设计没有坏掉,它是有条件正确的。条件是每一轮都到达同一台机器,而这正是你在扩展时放弃的条件。
"失败是静默的。模型仍然会回答,但它可能在没有正确上下文的情况下回答,因为请求落在了另一台没有先前聊天历史的机器上。"
失败是静默的。模型仍然会回答,但它可能在没有正确上下文的情况下回答,因为请求落在了另一台没有先前聊天历史的机器上。可观测性可能仍然显示 HTTP 200 响应,但从用户角度来看系统行为并不正确。这就是我们在为 AI 应用程序设计 API 时需要考虑的区别。
核心洞察:修复中没有任何新东西。它是 Lewis 和 Fowler 的微服务特征(2014 年)和 Michael Nygard 在《Release It!》中提出的 bulkhead 模式,只是应用于在这些原则写成时并不存在的请求形态。
有三个原则发挥了重要作用:
无状态: 对话状态从进程移出,进入共享存储。任何副本都可以服务任何对话的任何轮次。这一单一更改使之前的端点能够跨副本扩展,而不依赖进程本地的对话状态:如果 Agent 可以从集中式存储中检索所需内容,我们就不需要在每次请求时来回发送完整的聊天历史。
Bulkheads(也就是隔离): 这个想法是将系统的不同部分隔离,以防止级联故障。在这个案例中,我们是按依赖项隔离,而不是全局隔离。
智能端点,哑管道: OpenAI chat-completions 协议是一个异常有用的传输层:相对较小、稳定,已被许多 Agent 框架支持,对 AI 开发者来说很熟悉。我们把智能——路由、预算、记忆工程、上下文工程、工具调用策略——放在它上面,而不是放在它内部。保持管道简单。
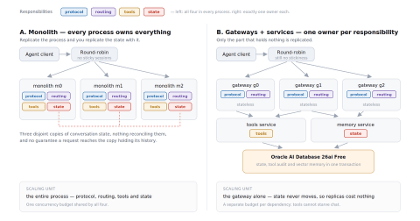
分解后的栈沿故障域边界拆分,而不是沿名词拆分:
如图所示,关键是尽可能多地隔离,同时保持每个组件专注于一项工作。这可以使组件更容易独立演进。这也给我们留出了空间为每个依赖项设置单独的并发预算、超时和其他配置参数。
你可以用信号量实现这一点:它们让我们控制对共享资源的访问,这正是我们需要的。
CHAT_SLOTS = asyncio.Semaphore(int(os.environ.get("CHAT_CONCURRENCY", "24")))
TOOL_SLOTS = asyncio.Semaphore(int(os.environ.get("GW_TOOL_CONCURRENCY", "8")))
而且由于协议没有改变,官方 SDK 可以与这个 OpenAI 兼容端点通信,无需对 SDK 本身进行任何更改:
from openai import OpenAI
c = OpenAI(base_url="http://127.0.0.1:8110/v1", api_key="")

c.models.list()          # ['agent-gateway/router-v1']
r1 = c.chat.completions.create(model="agent-gateway/router-v1",
        messages=[{"role": "user", "content": "hello"}], user="demo-1")
r2 = c.chat.completions.create(model="agent-gateway/router-v1",
        messages=[{"role": "user", "content": "and again"}], user="demo-1")
# r1 -> "turn 1"   r2 -> "turn 3"   (state survived, on a different replica)
由于网关独立地向 memory 组件写入——并且并发性由信号量控制——该设计避免了在副本之间依赖本地文件系统状态。
Bulkhead 隔离应用程序的不同组件,以防止故障在它们之间传播。例如,我们可以将工具调用路径与标准聊天完成路径分开。
想象我们有一个系统正确地对组件进行分区,并将工具调用请求与标准聊天完成分离,如下所示:
来自 POC 的 Bulkhead 比较
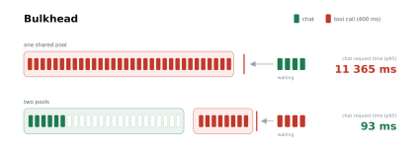
两个栈每个副本都有 32 个准入槽。单体方式从一个请求池中消耗它们。网关将它们分开:24 个用于普通聊天,8 个用于携带工具的请求。基准测试在 300 个并发调用者同时冲击一个 400 毫秒工具的同时,驱动 120 个聊天请求每秒。
"没有 bulkheads,进行标准聊天请求的用户可能会因为慢速工具调用而等待,因为每个请求都在竞争同一个池。"
没有 bulkheads,进行标准聊天请求的用户可能会因为慢速工具调用而等待,因为每个请求都在竞争同一个池。有了隔离,工具压力可以与标准聊天池隔离开来,有助于为标准聊天流量保留容量。
核心洞察:"每个服务一个数据库"是你可能不想在 AI 应用程序中统一应用的一条微服务原则。
2014 年盛行的建议是给每个服务自己的数据存储,因为共享模式耦合的成本超过了最终一致性的协调成本。
对于 Agent,这个计算可能会逆转,因为单个 Agent 轮次写入四个必须一致的东西:
如果你决定将这些拆分到不同的数据存储中——一个在 Postgres,一个在向量存储,另一个在 Redis——你会遇到应用程序现在必须管理的一致性问题。数据库几十年来一直在解决事务一致性,所以这个架构可以利用数据库事务能力来统一管理这些相关写入。
将它们保存在一个数据库中使其成为一次事务提交:
CREATE TABLE agent_sessions (
  session_id   VARCHAR2(64) PRIMARY KEY,
  messages     JSON NOT NULL,                 -- native JSON, not a CLOB you parse
  version      NUMBER DEFAULT 1 NOT NULL,     -- optimistic concurrency
  updated_at   TIMESTAMP WITH TIME ZONE DEFAULT SYSTIMESTAMP NOT NULL
);

CREATE TABLE agent_memory (
  memory_id    VARCHAR2(64) PRIMARY KEY,
  session_id   VARCHAR2(64),
  content      CLOB NOT NULL,
  embedding    VECTOR(1024, FLOAT32)          -- same row, same transaction
);

CREATE VECTOR INDEX ix_memory_vec ON agent_memory (embedding)
  ORGANIZATION NEIGHBOR PARTITIONS DISTANCE COSINE WITH TARGET ACCURACY 95;
关系型、JSON 和向量数据在一个引擎、一次事务、一次备份、一套凭证中。Oracle AI Database Hybrid Vector Search 让检索查询能够一次性获取所需内容,在一条语句中连接工具历史并按余弦距离排名——而不是在 Python 中跨三个系统进行连接,否则可能需要跨多个系统的应用程序级协调。
数据库为水平扩展 API 做的另一件事是帮助协调并发轮次。两台副本服务同一对话的轮次是正常的,而不是异常的。SELECT … FOR UPDATE 加上版本列可以序列化冲突更新并实现重试处理,而不是让竞争更新覆盖对话状态。
每个人都采用微服务来扩展 AI 应用程序,但统一应用这一原则会在 Agent 的记忆、审计日志和向量索引之间产生一致性挑战。
"有用的拆分是不对称的:分解计算,聚合数据。"
有用的拆分是不对称的:分解计算,聚合数据。
2014 年的原则仍然有效。我们只是需要将它们适应到 AI Agent 的新时代。
准备好尝试这个架构了吗?下载 Oracle AI Database Free,安装 Oracle AI Agent Memory Python 包,并按照本地快速入门为你的 Agent API 添加持久状态和持久记忆。更多示例,请访问 Oracle AI Developer Hub。