
8.0
热点
AI SCORE
工具产品2026-09-28 06:11
Laya: 3亿参数决策引擎替代LLM判断
dev.to · AI#开源#AI推理#分类模型
Editor brief · 编辑速览
一款非自回归的决策引擎,输入文本和结构化问题后单次前向传播即出答案,无token生成。相比LLM-as-a-judge更快、更确定、更低成本,适合路由/分类/评分等高频判断场景。
原文首次发表于 AI Frontier Post。
当你的收件箱里有一封客服邮件、一个内容审核队列,或者一个需要为自己的工作分流的 AI 智能体时,所需做出的决策其实简单得可笑——分到哪个部门、用户有多生气、是否需要升级处理——但标准实现方式却荒唐至极:把文本序列化进提示词,发给前沿模型,等待 token 一个一个吐出来,再用正则表达式从自然语言中抠出答案,然后祈祷 JSON 能正确解析。这种方式慢、每做一次决策都要花钱,而且同样的输入在不同日子可能产生不同输出。
Laya(NandhaKishorM/laya,Apache-2.0)走的是完全相反的路子:一个非自回归的决策引擎。你只需向它传入文本加一组类型化问题——choice(选择一个标签)、score(评一个强度分)、noul(是否,用概率表示)——一次前向传播就能同时回答所有问题。不生成任何 token;响应甚至会报告 output_tokens: 0。该项目将其称为"系统 1"思维,这个比喻恰如其分:快速、类型化、确定性的判断,而非深思熟虑的自然语言。
数字令人震惊。Laya 创建于 2026 年 9 月 18 日,当我 9 月 27 日查看 GitHub API 时,它已有 26,639 个 star 和 2,326 个 fork——一个才 9 天的项目每天约 3,000 个 star,且 commit 与我测试当天同步上线。这不正常。这种涨幅只出现在一个项目精准命中了所有人早已感受到的痛苦时。
而这种痛苦是真实的:"LLM-as-a-judge"模式已经成为生产级 AI 系统中开销最大的环节之一。每一次分类、每一次护栏检查、每一次路由决策,都在燃烧前沿模型的 token 并增加一秒以上的延迟。Laya 的卖点是:这些决策中 95% 根本不需要推理引擎——它们需要一个输出类型化、有置信度分数、且诚实地在不确定时弃权的快速分类器。该项目在 Hugging Face 上发布了三个检查点(convaiinnovations/laya):一个基于 ModernBERT-large 构建的 421M 参数英文模型、一个覆盖 100+ 语言的 322M 参数多语言模型,以及一个类型化决策变体。项目报告在 T4 GPU 上每个问题耗时 33ms,批处理时降至每个问题 7.2ms——我会在下面用 CPU 做一次真实性检验。
Python 3.10 或更高版本以及 pip(我在 Linux 上用了 3.12;macOS 和 Windows 同样可用)。
Python 3.10 或更高版本以及 pip(我在 Linux 上用了 3.12;macOS 和 Windows 同样可用)。
PyTorch——CPU 版本即可。我全程在一台纯 CPU 的 VM 上运行完整个教程;不需要 GPU。
PyTorch——CPU 版本即可。我全程在一台纯 CPU 的 VM 上运行完整个教程;不需要 GPU。
约 1.5 GB 可用磁盘空间存放检查点(多语言权重约 650 MB),推理时约需 1 GB 内存。
约 1.5 GB 可用磁盘空间存放检查点(多语言权重约 650 MB),推理时约需 1 GB 内存。
无需 API key、无需账号、无需 GPU、无需费用。所有操作均在本地运行。检查点在首次使用时从 Hugging Face 下载,之后被缓存。
无需 API key、无需账号、无需 GPU、无需费用。所有操作均在本地运行。检查点在首次使用时从 Hugging Face 下载,之后被缓存。
约 20 分钟,大部分是一次性下载检查点的时间。
约 20 分钟,大部分是一次性下载检查点的时间。
pip install torch --index-url https://download.pytorch.org/whl/cpu
pip install "laya==0.3.21"
python -c "import laya; print(laya.__version__)"   # 0.3.21
先从 CPU 索引安装 PyTorch,以免意外拉取数 GB 的 CUDA 版本——这是整个安装过程中唯一真正的坑。然后锁定 laya==0.3.21,即我验证以下所有内容的版本。导入后打印出 0.3.21 即可开始;除了包本身,此时还没有下载任何东西。
Laya 自带一个 CLI,是感受核心概念的最快方式。先不加任何 flag 运行——这只会做路由,不下载检查点:
laya "The CEO is furious and the board is about to vote on a merger"
你会看到类似这样的输出(来自我实际运行):
Model     : english
Reason    : English Latin text
Detected  : {"script": "latin", "script_profile": {"latin": 1.0}, "language": "en",
             "is_english": true, "language_undecided": false, ...}
路由器会检查你文本的书写体系和语言,选择一个检查点——英文文本走 421M 英文模型,其他走 322M 多语言模型。这个路由决策零成本,无需加载任何权重。现在用内置的 triage 预设问一个真正的问题(首次使用会下载检查点,约 650 MB,仅一次):
laya "My payment failed twice" --preset triage --model multilingual --device cpu
Model     : multilingual
Reason    : explicit model='multilingual'

intent      : technical_help (p=0.811)
is_urgent   : 0.002
frustration : 2.28
refund_requested: 0.004
churn_risk  : 0.001
仔细看这个输出,因为它就是整个产品的缩影。五个类型化决策——一个 choice(intent)、一个 score(frustration,0–3 量表)、三个 noul 是/否概率——一次前向传播全部回答,每个答案都附带了概率。triage 预设的五个问题定义一次,重复使用;可用的预设还有 email、guard、moderation、router 和 triage。没有逐 token 生成。没有花你一分钱。
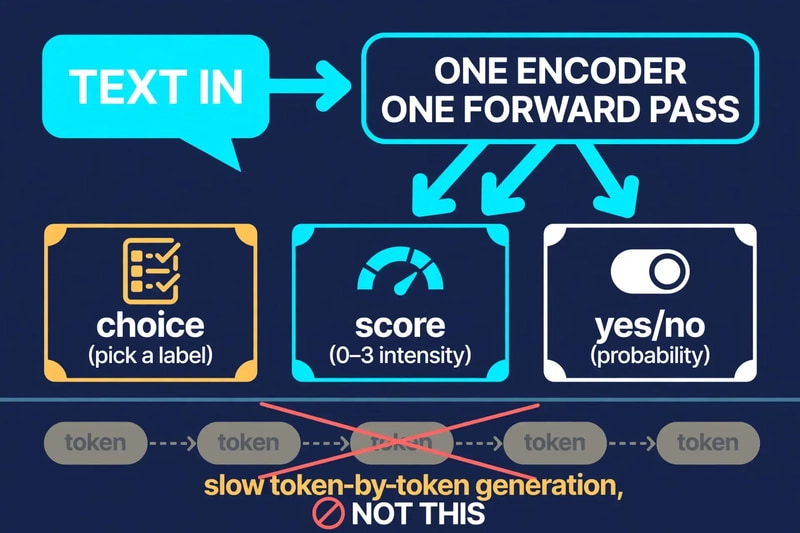
Laya 的核心思路:一次编码器、一次前向传播,所有问题头并行回答。没有自回归解码。
单张工单只是演示;真实用例是一个队列。把每张工单写一行到一个文件里,然后批量打分:
printf 'My payment failed twice, I want my money back\nBonjour, je ne parviens pas a me connecter a mon compte\nThis is just a feature request, no rush\n' > tickets.txt
laya --batch tickets.txt --preset triage --model multilingual --device cpu
我在 CPU 上的实际结果:
# My payment failed twice, I want my money back
intent      : refund (p=1.000)
is_urgent   : 0.004
frustration : 2.16
refund_requested: 0.995
churn_risk  : 0.006

# Bonjour, je ne parviens pas a me connecter a mon compte
intent      : technical_help (p=0.992)
is_urgent   : 0.000
frustration : 2.02
refund_requested: 0.000
churn_risk  : 0.002

# This is just a feature request, no rush
intent      : cancellation (p=0.703)
is_urgent   : 0.009
frustration : 2.30
refund_requested: 0.005
churn_risk  : 0.026
有两个值得注意的观察点。第一,法语工单——被路由到多语言检查点——以 0.992 的置信度被正确分类。没有翻译步骤、没有英文兜底;这说明 100+ 语言的承诺至少在其中一个上面是如实工作的。
第二,第三张工单是一次失误:"This is just a feature request, no rush" 被标记为 cancellation,置信度 p=0.703。我刻意展示给你看,因为这是理解决策模型最重要的一点:它们有时会出错,唯一诚实的设计是告诉你它可能在出错。注意看置信度——0.703,远低于正确答案的 0.99+。这个差距是承重结构。这就是第四步的基础。
关于耗时:我后来跑的 8 张工单批次在 CPU 上热启动耗时 27.5 秒——约每张工单 3.4 秒(5 个问题),即每个问题约 0.7 秒。项目中报告的 33ms/问题是基于 T4 GPU 的;在 CPU 上你应该按每张工单每个问题约 1 秒来估算(一次性模型加载约 85 秒,在我的 VM 上)。对于客服队列或夜间批处理任务,这个速度已经足够快了。如果需要按键级别的延迟,请用 GPU。
CLI 适合探索;生产代码用 Router。下面是完整的 triage 循环,我逐字运行过:
from laya import Router, triage_questions

router = Router(device="cpu")          # 首次使用时下载检查点
questions = triage_questions()        # 第二步中的 5 问题预设

tickets = [
    "My payment failed twice, I want my money back",
    "Bonjour, je ne parviens pas a me connecter a mon compte",
    "URGENT: production database is down, customers cannot check out",
]

out = router.predict(tickets, questions, model="multilingual", min_confidence=0.90)
返回值是一个普通字典,包含四个顶级键——model、answers、usage 和 routing。routing 块精确告诉你哪个检查点回答了以及原因("repo": "convaiinnovations/laya/multilingual", "reason": "explicit model='multilingual'"),usage 报告 input_tokens 且 output_tokens: 0——这是一个从不生成内容的模型的标志性特征。
每个回答都包含其类型、值和置信度。Choice 类型答案包含完整的概率分布;Score 类型答案包含数字到含义的图例以及每个级别的概率;Noul 类型答案包含原始概率。以下是支付工单的挫败感评分,返回格式完全一致:
{
  "score": 2.3211,
  "legend": {"0": "calm and neutral", "1": "concerned but civil",
             "2": "clearly annoyed", "3": "very angry or using strong language"},
  "probabilities": {"0": 0.0354, "1": 0.129, "2": 0.3148, "3": 0.5208},
  "confidence": 0.2166,
  "answer_confidence": 0.5208,
  "low_confidence": true
}
末尾的 "low_confidence": true 就是 min_confidence=0.90 参数在发挥作用。模型的回答置信度(0.52)低于我的阈值,所以 Laya 标记了这个字段,而不是让一个不确定的 2.32 分数悄然流入我的流程。这是可选择的弃权机制,也是 demo 与可上线系统之间的差别:低置信度字段会被标记返回(通过 schema 驱动的 decide() API 返回 None),你的代码可以将它们路由给人工或更大的模型。注意其中诚实的微妙之处——同一工单的其他字段(intent,p=1.000)和 refund_requested(0.9638)都通过了阈值,只有这个真正不确定的字段被标记了。弃权是按问题级别,而非按工单。
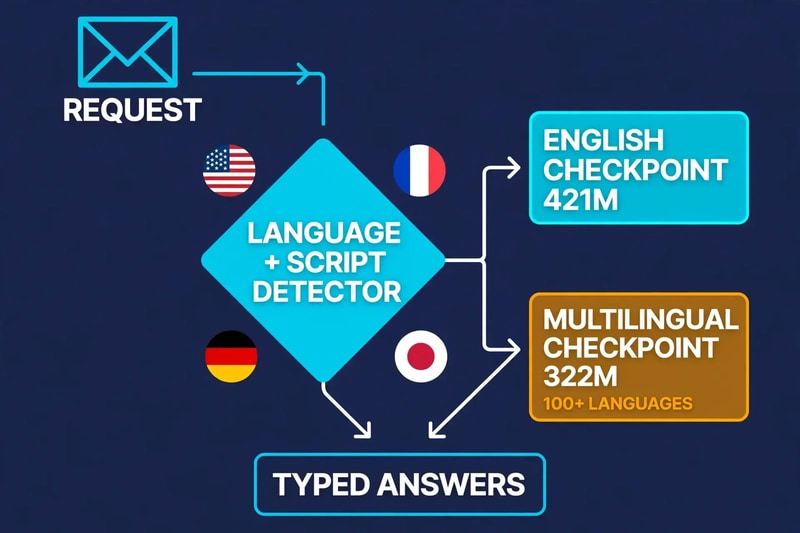
路由器:一个轻量级的语言/脚本检测器,为每个请求选择正确的检查点——英文文本走 421M 模型,其他所有语言走 322M 多语言模型。
步骤 5:端到端——置信度门控的升级流程
现在把各个组件组装成一个可以实际交付的东西:一个自动处理简单工单、紧急工单立即升级、任何不确定的内容发送到人工审核队列的分诊函数。
def triage(ticket: str) -> dict:
    out = router.predict(ticket, questions, model="multilingual",
                         min_confidence=0.90)
    a = out["answers"]
    # Abstain: any flagged field -> human review
    if any(v.get("low_confidence") for v in a.values()):
        return {"action": "human_review", "ticket": ticket}
    intent = a["intent"]["answer"]            # e.g. "refund"
    if a["is_urgent"]["noul"] > 0.8:          # yes/no probability
        return {"action": "escalate_now", "intent": intent}
    if intent == "refund" and a["refund_requested"]["noul"] > 0.9:
        return {"action": "auto_refund_flow", "intent": intent}
    if a["churn_risk"]["noul"] > 0.5:
        return {"action": "priority_support", "intent": intent}
    return {"action": "standard_queue", "intent": intent}
用这个函数跑一遍步骤 3 中的四个工单,就能得到你期望的行为:支付工单走自动退款流程,法语登录问题进入标准队列,服务中断工单立即升级,而那个模糊的"功能请求"——Laya 以 0.703 的置信度将其误标为取消的那个——因为置信度低于门控值而落入 human_review。模型的那一个错误变成了一个队列条目,而非一个错误操作。这就是整套理念:快速的类型化决策,加上经过校准的逃生舱口。
还有一个值得了解的 API:Agent.decide(state, schema=...)(签名已验证:decide(self, state, schema=None, *, questions=None, return_details=False, min_confidence=None, **predict_kwargs))允许你传入 JSON schema 或 Pydantic 模型并获得结构化对象返回,低置信度字段为 None——当决策结果要喂给下游函数签名时非常方便。如果你使用 MCP 协议,pip install "laya[mcp]" 可以把同一个引擎暴露为 MCP 服务器(laya-mcp-server),仓库里也附带了一个 LangChain 集成。
校准注意事项(上线前请阅读)
功劳归于应得之处:Laya 文档对系统最薄弱环节的坦诚程度非同寻常。两个发布的检查点都存在过度自信的问题——概率看起来比实际更尖锐——而且多语言检查点根本没有拟合温度参数。文档告诉你,在信任这些数字之前,需要在自己的保留数据上拟合温度,我上面使用的 min_confidence 阈值只有在与你自己的标签验证后才有意义。我的 0.90 门控在四个工单上有效,但那只是一个个案,不是校准研究。把概率当作开箱即用的有用排序来用,只有在完成温度拟合的功课后才能当作可信的概率来用。文档甚至指出,概率到阈值的映射是最可能在生产环境中让你出丑的部分。听他们的。
何时使用此方案 vs 替代方案
当你的决策是类型化且有界的——分类、评分、是/否——且你每天要做出数千次决策时,使用 Laya。工单分诊、审核队列、Agent 自我路由、RAG 相关性判断和评估测试平台是最佳场景。你获得的是确定性、零边际决策成本、离线能力和毫秒级 GPU 延迟。
当你的决策是类型化且有界的——分类、评分、是/否——且你每天要做出数千次决策时,使用 Laya。工单分诊、审核队列、Agent 自我路由、RAG 相关性判断和评估测试平台是最佳场景。你获得的是确定性、零边际决策成本、离线能力和毫秒级 GPU 延迟。
当判断需要推理、 nuance 或自由形式的解释时,使用 LLM-as-a-judge——"这个回答真的有帮助吗,为什么。"Laya 无法解释自己;它输出数字,不输出理由。
当判断需要推理、 nuance 或自由形式的解释时,使用 LLM-as-a-judge——"这个回答真的有帮助吗,为什么。"Laya 无法解释自己;它输出数字,不输出理由。
当你需要策略编排时——多步骤对话轨道、PII 脱敏流程、主题边界——使用护栏框架(NeMo Guardrails、Guardrails AI)。Laya 的护栏和审核预设回答"这是否不安全",但它们是分类器,不是策略引擎。
当你需要策略编排时——多步骤对话轨道、PII 脱敏流程、主题边界——使用护栏框架(NeMo Guardrails、Guardrails AI)。Laya 的护栏和审核预设回答"这是否不安全",但它们是分类器,不是策略引擎。
当你在一个狭窄领域有数千个标注样本且需要那里的最高准确率时,使用微调分类器。Laya 的零样本问题会在该专家的地盘上输给训练有素的专家——但那个专家明天无法回答新问题而不需要重新训练,而 Laya 可以。
当你在一个狭窄领域有数千个标注样本且需要那里的最高准确率时,使用微调分类器。Laya 的零样本问题会在该专家的地盘上输给训练有素的专家——但那个专家明天无法回答新问题而不需要重新训练,而 Laya 可以。
当你需要在微控制器或手机上使用工具调用或结构化提取时,使用设备端模型(如之前的教程中介绍的 Cactus Needle 3)。作为决策引擎 Laya 很小,但作为微控制器模型它并不小。
当你需要在微控制器或手机上使用工具调用或结构化提取时,使用设备端模型(如之前的教程中介绍的 Cactus Needle 3)。作为决策引擎 Laya 很小,但作为微控制器模型它并不小。
我们目前在前沿模型 tokens 上花费的大部分成本并非推理——而是固定 schema 的判断。Laya 的赌注是这两类工作负载值得不同的架构,在 CPU 上运行之后,我认为这个赌注方向是对的:一个 322M 参数的编码器在一次前向传播中回答五个类型化问题,法语和英语一样好,每个问题都有置信度和弃权标志,边际成本为零。九天内 26,000 颗星的飙升是市场在大声认同。
诚实的版本包括注意事项:我的四个测试工单中有一个被错误分类,发布的概率在拟合温度之前是过度自信的,CPU 延迟是秒级而非毫秒级。但架构对自身弱点的处理很优雅——那个错误是该批次中置信度最低的答案,弃权门控捕获了它。这就是它成为工具而非玩具的原因:它知道自己不知道什么,并且会告诉你。安装它,把它指向你最无聊的分类队列,停止付钱给前沿模型让它做分类器的工作。