
8.0
热点
AI SCORE
编程提效2026-09-28 13:37
AI Agent 生产级基础设施的五个核心层次
dev.to · AI#Agent#架构#基础设施
Editor brief · 编辑速览
文章提出 Agent 基础设施包含运行时编排、身份治理、数据记忆、可观测性评估、成本资源管理五层,Gartner 预测 2027 年前 40% 的 Agent 项目会被取消。
大多数 Agentic AI 项目的失败,不是因为模型不行,而是因为底层基础设施跟不上。
"Agent 基础设施"不是一个东西,而是五个层次:运行时/编排、身份与治理、数据/记忆、可观测性/评估、成本/资源管理。
没有任何厂商,包括 Unmeshed,能覆盖全部五个层次。谁要是声称自己做到了,那他只是在给自己的产品画圈。
Unmeshed 覆盖的是运行时/编排层和身份与治理层。数据/记忆和模型路由是缺口,直说了。
先修那个真正在出问题的层次。别去找一个声称通吃全栈的平台。
超过 40% 的 Agentic AI 项目将在 2027 年底前被取消。这不是博眼球的论断,而是 Gartner 自己的研究。
原因不是模型变差了。团队做出了在演示中运行良好的 Agent,然后眼看它们在真实流量、真实故障和真实审计需求出现的那一刻分崩离析。
模型从来不是问题。模型下面的基础设施还不存在。
搜索一下"AI Agent 基础设施",你会得到五个不同的答案,取决于你读的是谁的指南。一个框架说四层,另一个说五层,第三个说七层。
没有任何卖平台的厂商真正认同自己产品的边界在哪里,这本身就说明了一些问题。目前还没有确立的标准,只有少数公司在按自己已经搭建的东西来画地图。
所以真正有用的问题不是哪个平台覆盖了全部 Agent 基础设施。老实说,没有平台做到了。
真正有用的问题是:哪个具体的层次此刻正在真正出问题,怎么才能解决那个层次的问题。这正是本指南要讲的。
AI Agent 基础设施是那一层专门的运行时、身份、数据、可观测性和成本控制系统,它让自主 Agent 在离开演示环境、进入生产流量后仍能可靠运行。
说起来有点啰嗦,简化版是这样的:Agent 框架——LangChain、CrewAI、Mastra、或者你用来定义 Agent 如何推理和调用工具的任何东西——决定了 Agent 做什么。
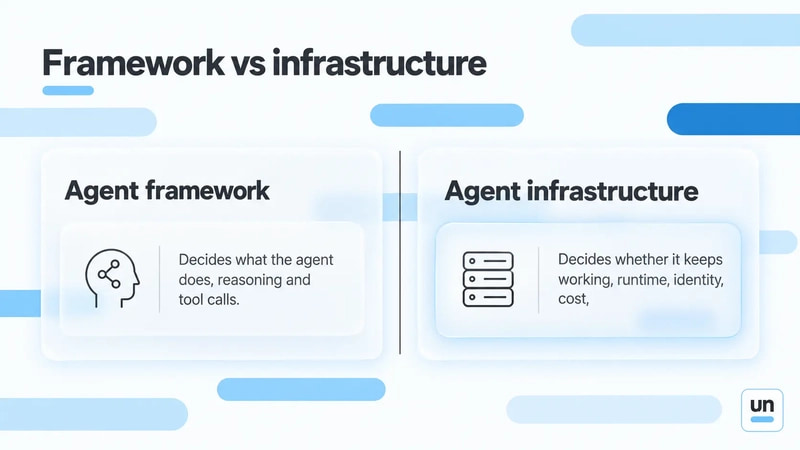
AI Agent 基础设施决定的是:当下游 API 超时、凌晨 2 点它还能不能继续稳定运行;事后有没有人能说清楚发生了什么;以及一个恶性循环的账单在来不及阻止之前会不会送上门来。
你可以换框架而不碰基础设施,也可以换基础设施而不碰框架。它们是真正独立的问题,这也是为什么团队往往在其中一个上投入过度而在另一个上投入不足。
这个区别值得在整个指南中铭记于心,因为大多数关于 AI Agent 基础设施的困惑都来自于把它重新混进框架的讨论里。
这也是为什么"完整的 Agent 基础设施平台"是个如此常见的推销说辞,而各个厂商说起来又如此不一致。每个版本的说辞都在不同地方画边界,取决于卖它的公司恰好已经建了什么。
找三份不同的指南来看,你会得到三种不同的层数统计:
Agentuity 的指南确定为四层:运行时、编排、可观测性和成本控制
MindStudio 的框架拆成五层:运行时编排、身份与授权、数据访问与记忆、支付与资源管理、可观测性与调试
其他指南还加上了第六或第七层,专门切给记忆或安全
这些分歧实际上与技术本身无关。它取决于每家公司卖的是什么产品,以及它的边界恰好落在哪里。
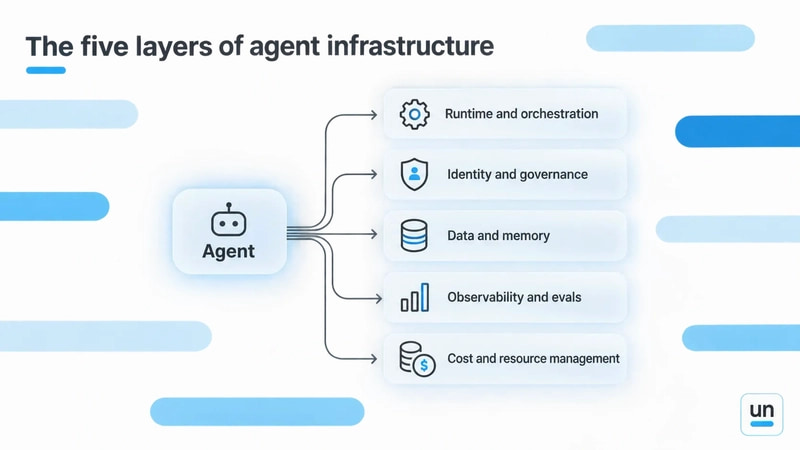
本指南中,五层覆盖了从头评估 Agent 基础设施技术栈时真正重要的全部范围:
无论你最终采用哪种层数统计,这样划分 AI Agent 基础设施的目的是:不再把它当作一个不分的整体,而是开始把它当作五个独立的购买、构建或修复决策来处理。
这是大多数团队最先碰到的层次,因为它坏起来动静最大。Agent 运行时管理的是:
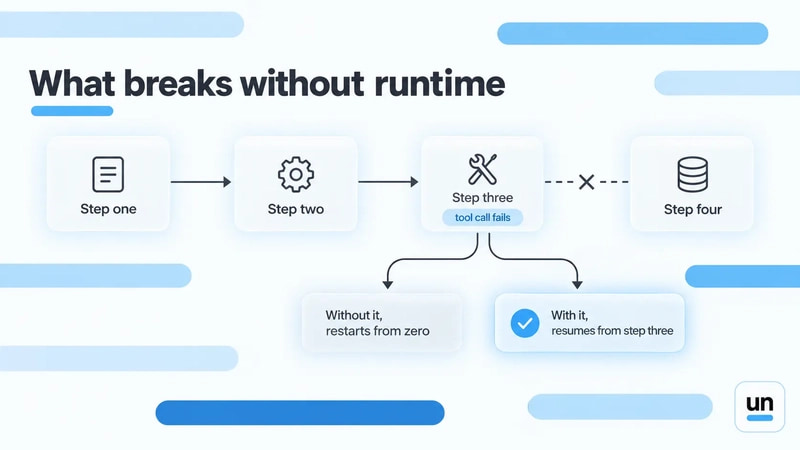
一个下游 API 超时后就只能从零重启的 Agent,还不是生产级软件。它是一个 uptime 不错但昂贵的演示。
这一层没做好,AI Agent 基础设施的其他所有部分都会继承不稳定性,因为下游没有任何东西可以信任一次运行真的按预期完成了。
我们曾在 what is durable execution 中写过持久化执行真正需要什么,以及它与普通 API 编排的区别——当工作流包含 AI 步骤而不仅仅是服务调用时。
Agent 现在是一个身份了,而不仅仅是一个脚本。它持有凭据、以他人名义调用工具,如果没人监督它的行为可能造成真实后果。
这一层要回答的是:
跳过这一层,你得到的是一个拥有比团队任何个人都更高的常设访问权限、却没有使用记录的 Agent。我们在 governed AI 中讲过为什么这对企业团队来说不再是可选项。
两个不同的问题藏在同一个标签下面。
数据访问是 Agent 如何在正确的时间获取正确的信息——通过向量存储、结构化工具调用,或者直接加载到 prompt 中的上下文。
记忆是 Agent 是否在会话之间记住任何东西,而不是每次都从零开始。
这是大多数编排优先的平台——包括 Unmeshed 在内——最不原生拥有的那一层。记忆和检索通常来自专门的向量数据库或记忆服务,与运行其他部分的工作流配对,而不是捆绑在一起。
这也是在 AI Agent 基础设施营销中被过度吹嘘最多的一层。薄薄的检索集成很容易演示,在真实负载之前也很难与真正的长期记忆区分开来。把它如实地指出来,而不是把一个功能拉伸到去掩盖一个真实存在的缺口。
普通 API 调用失败时,你查一条日志。当 Agent 在三十次工具调用和十几次模型调用之后失败,一条日志几乎什么都告诉不了你。
这一层需要的是:
最后那部分是评估(evals),它与可观测性不同,尽管两者经常被混为一谈。我们在 LLM monitoring vs observability 中明确划了这条线,并在 what are AI agent evals 中深入讲了评估这一侧,包括团队如何用 LLM as a judge 自动化质量评分,而不是让人去读每一条记录。
单次 LLM 调用只花几分钱。一个 Agent 在多个 Provider 之间发起上百次调用,在一个不知道何时该停的循环里,就可能花掉真金白银,而发票通常在损失已经造成之后才送到。
这一层需要的是:
多 Provider 计费本身就是个头疼问题,这正是 LLM 网关要解决的问题。如果跑冒滴漏的支出才是真正的痛点,那 LLM cost optimization 中的那些技术在这里收效最快。
管理不当的话,这一层会把一个有前景的试点变成一场没人想谈的预算会议。
这一点不绕弯子。Unmeshed 直接覆盖五个层次中的两个:
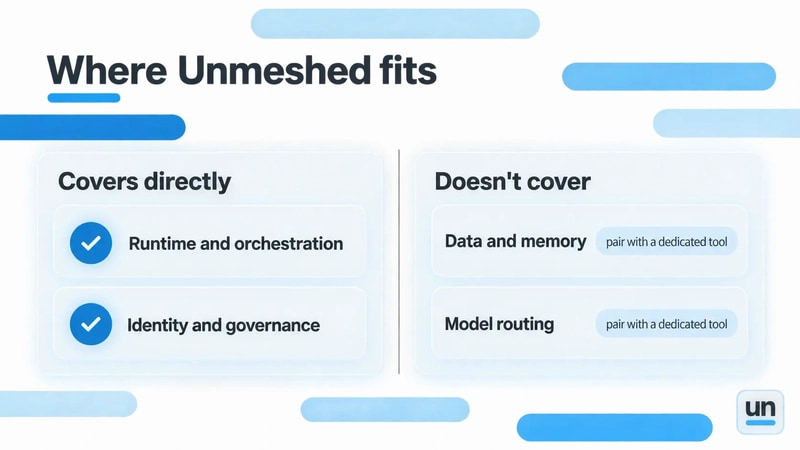
运行时与编排:持久化执行,失败步骤后能恢复而非重启,工作流级状态自动保留
身份与治理:人工介入审批、分支逻辑决策引擎,以及每一步的审计日志,让"Agent 实际上做了什么"有真正的答案
它不覆盖另外两个:
数据与记忆:没有内置的向量存储或长期记忆层,假装有的话就是在做本指南一直在反驳的那种过度承诺
模型路由:它不充当多 Provider 路由的 LLM 网关;那是另一个独立且互补的组件
如果你缺的恰好是这两层之一,那你就是在把一个专用工具和任何运行编排层的平台搭配使用。无论编排层是 Unmeshed 还是其他什么,都是如此。
市场上大多数 AI Agent 工具都是奔着把某一个层次做透去的,然后安静地暗示自己解决了其余层次。明确说出覆盖了哪两个,比拿出一份拉伸到覆盖缺口的特性列表有用得多。
覆盖五层中的两层,认真的
持久化执行和受治理、可审计的 Agent 步骤是内置的。先看看它实际长什么样,再决定要不要自己建。
没有任何单一 Agent 基础设施平台真正拥有全部五层。声称全部覆盖的那些指南只是在给自己的产品画宽松的边界。
大多数团队最终是从两到三个专用工具组装而来,而不是买一个什么都做的平台。这不是市场的失败,而是市场目前的真实状态。
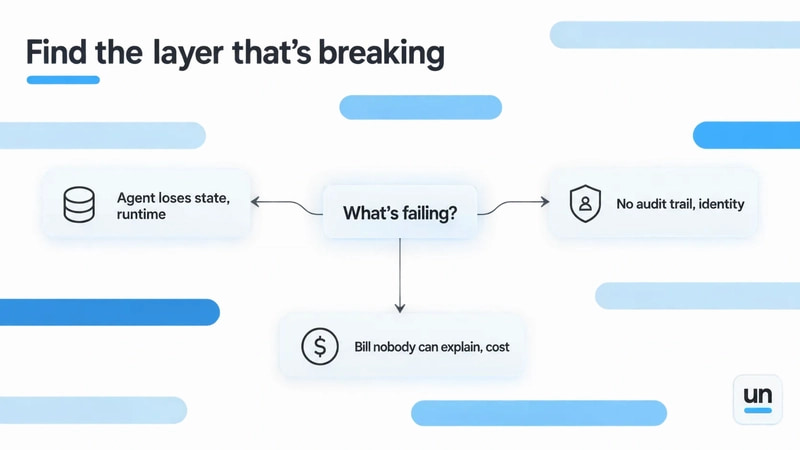
一个决定从哪开始的实用方法:找出哪个层次正在给你造成痛苦,而不是哪个在抽象意义上听起来最重要。
先解决那个真正在着火的一层。其余的 Agent 基础设施可以等到它成为问题的时候再处理。
这就是 AI Agent 基础设施今天的实际状况,无论销售演示暗示了什么样的全覆盖。
AI Agent 基础设施不是一个单一的产品类别,不管幻灯片怎么说的。
它是五个由不同厂商画出不同边界的层次。诚实的起点是知道哪一个真正在让你失败,而不是去找一个声称全部通吃的平台。
运行时与编排、身份与治理、数据与记忆、可观测性与评估、成本与资源管理。
说出正在坏的那一层,修那一个,然后从那里往外扩展,而不是试图在第一天就把五个全部解决。
还在评估 Agent 基础设施技术栈?联系我们,聊一聊你缺的是哪几层,以及 Unmeshed 是否覆盖了对你的用例最重要的那些层。