
9.0
重磅
AI SCORE
编程提效2026-10-09 20:43
AI agent写的代码,运行前必查的五个安全检查点
dev.to · AI#AI编程#安全#最佳实践
Editor brief · 编辑速览
总结了AI coding agent产出代码的安全审查要点:核查npm/conda包名真实性防止域名抢注攻击、检查shell脚本和编辑器任务配置、审查MCP服务端和API密钥暴露、防范模型输出注入exec/eval。
AI agent 生成的代码已经足够好用,很容易就直接接受 diff、运行 npm install、启动 dev server。大多数时候这样没问题。问题出在那些例外情况——因为 agent 拥有你的权限,能读取你从未见过的文本。
这些是我在运行 agent 生成的任何代码之前会检查的五个地方。
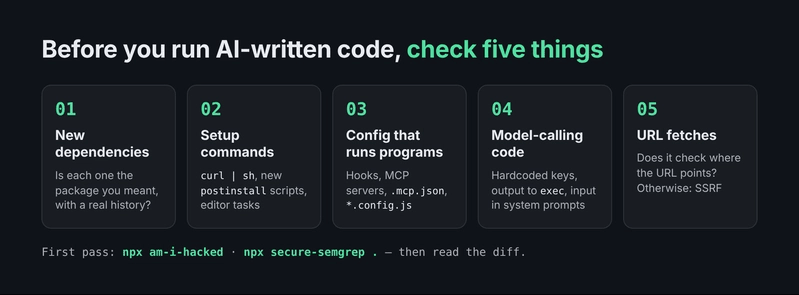
Assistant 有时会推荐不存在的包名,或者和真实包只差一个字母的包名。攻击者会注册这些名字。对于 package.json 或 requirements.txt 中的每个新条目,都要确认它是你想要的包,并且有真实的历史记录。
Advisory 扫描器(npm audit、OSV-Scanner)仍然值得运行,但它们只知道已报告的问题。全新的恶意包还没有任何 advisory。
curl ... | sh、新的 postinstall script、editor task。能够浏览网页的 agent 会重复不受信任页面告诉它运行的任何命令。阅读 agent 添加或修改的每个脚本条目。
Agent hooks、MCP server 定义、.claude/settings.json、.mcp.json、.vscode/tasks.json、*.config.js。所有这些都会启动进程,而且它们在 diff review 中都不像"代码"。
硬编码的 API key。Model 输出传给 exec 或 eval。用户输入拼接到 system prompt 中。没有 max_tokens。Agent 很容易写出这类代码,因为这些在它们的训练数据中到处都是。
如果 agent 写了链接预览、webhook 或"从 URL 导入"功能,检查它是否验证了 URL 指向的位置。否则有人可以把你的服务器指向 169.254.169.254 并读取你的云凭证。这就是 SSRF。
我为这件事维护两个开源工具。两者都用 npx 运行,不需要账号。
am-i-hacked 读取项目寻找恶意代码的迹象:自动运行的 editor task、下载或解码内容的安装脚本、混淆的有效载荷、伪装成资源文件的可执行文件、与渗出端点配对的捕获代码,以及项目自己的 AI 工具配置。
npx am-i-hacked
把它放在 dev server 前面,这样每次都会运行:
{ "scripts": { "dev": "am-i-hacked && next dev" }
}
secure-semgrep 用针对 AI-agent 代码的捆绑规则运行 Semgrep:硬编码的 provider key、model 输出到 exec、system prompt 中的用户输入、MCP 命令注入和工具投毒、危险的 agent hooks、SKILL.md 文件中的 prompt 注入。它还会添加 Semgrep 自己的安全规则包针对你的技术栈。需要安装 semgrep。
npx secure-semgrep -L ts -L node .
npx secure-semgrep -L ssrf .   # opt-in SSRF rules
两者在发现问题时会 exit 1,因此可以接入 CI。
两个工具都不知道你让 agent 做了什么。扫描能找到已知模式,但不能证明代码正确或安全。两者都不会扫描已安装的 node_modules。两者都不是杀毒软件。它们是第一轮检查,告诉你应该在哪里看,而阅读 diff 仍然是真正重要的检查。
完整指南(包括 AI 规则覆盖内容的表格)在这里:Is AI-generated code safe to run? How to check it first。
所有内容采用 MIT 许可:github.com/IsaacBell/secure-devtools。