
8.0
热点
AI SCORE
模型发布2026-10-02 21:19
GPT-6 Astra用Agent在魔兽世界完成首秀
Hacker News#GPT-6#Agent#游戏
Editor brief · 编辑速览
GPT-6 Astra通过agent-wow项目首次在魔兽世界中展现Agent能力,可观察多Agent协作的游戏场景执行效果。
最近,我一直对 LLM驱动的 Agent 来玩电子游戏这个概念着迷。它们不仅看起来出人意料地有趣,还能让我们深入了解这些前沿模型在被放入一个未经明确训练的模拟世界时,能表现出怎样的能力。
bots 在电子游戏(尤其是《魔兽世界》,简称 WoW)中运行,这个概念并不新鲜。与基于启发式的 bot 相比,LLM Agent 的不同之处(也是更有趣之处)在于,它从未被明确训练过这个游戏。它只是利用自身的推理能力来对环境做出反应,像真实玩家一样完成任务。
这个领域已经有一些有趣的开源项目,比如 Mindcraft 和 Factorio Learning Environment。我构建了 agent-wow 来扩展这个概念,看看前沿模型在玩《魔兽世界》时能做到什么程度。最终目标是让整个服务器充满 AI Agent,看看它们能否以英雄难度通关冰冠堡垒。即使失败了,看着它们能走多远也依然很有启发性(也很 fun)。
作为一个简单的起点,我给 Codex(使用 GPT-6 Astra xhigh)输入了以下 prompt:
create an orc character and complete all quests in the starting zone
我最初对此持怀疑态度。即使能完成,也需要数小时,中间还会遇到死胡同。但结果表明,它轻松地在 40 分钟内完成了任务,0 死亡,只有极少的小波折。完整的游戏录像也可以在这里查看。
除了它是我最喜欢的游戏之一(尤其是 Classic 到 WotLK 时代),它还有一些令人难以置信的机制,使其成为评估 AI 的理想模拟世界。随着游戏进程,游戏中有着长期战略和短期战术之间的良好平衡。
当你达到等级上限时,让角色为终局内容做好准备需要大量复杂的规划和执行:
这些要求中的每一项都可以分解为更复杂的任务。例如,某些最优装备部位可能需要制造,而这反过来又需要特定的资源和技能。角色可以刷副本获取,也可以用金币购买。两者导向相同结果,但方法截然不同。
如果你能够完成所有这些并进入团本 Boss,那么游戏还要求快速的协调和执行。你能在与 24 个其他玩家实时同步的同时,以最优技能循环施放来最大化每秒伤害,同时躲避地上的火焰技能吗?
这为我们提供了一个强大的环境来压力测试 Agent 的长期战略规划和短期战术执行能力。当多人游戏交互成为通关游戏某些部分的关键时,它就更加有趣了。
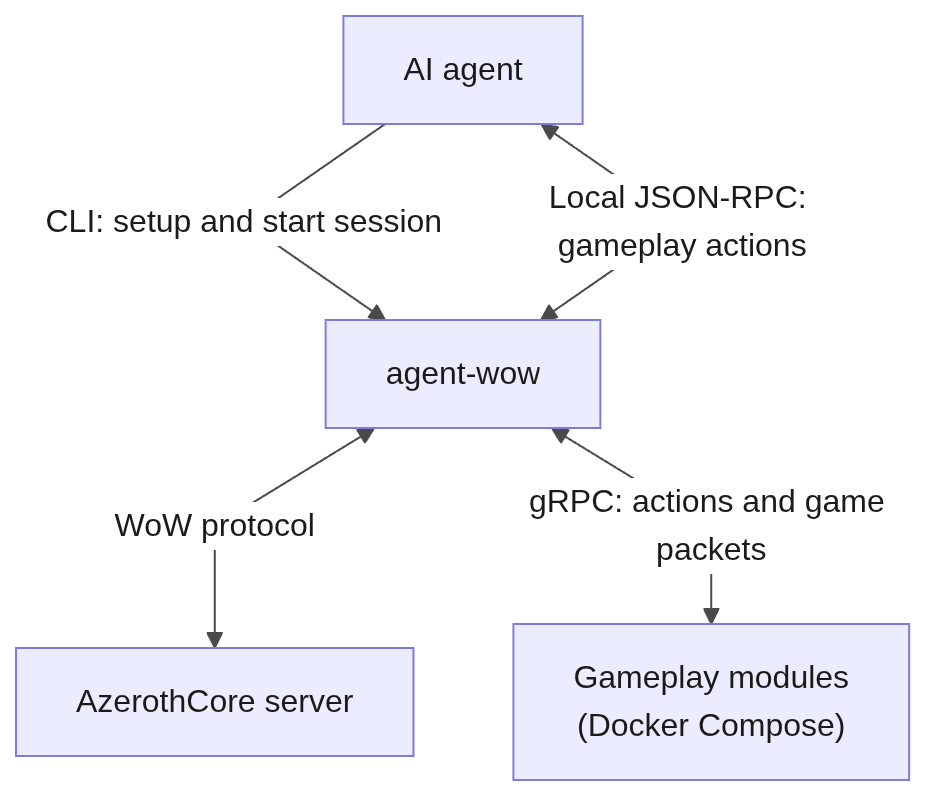
agent-wow 不依赖计算机视觉和直接的键盘鼠标控制,也不使用任何游戏黑客技术直接接管 WoW 客户端。相反,它为 Agent 提供了一个平台,使其能够使用 WoW 网络协议直接与游戏服务器交互。
更值得注意的是,agent-wow 没有定义任何游戏机制(如移动、战斗或游戏内交互)。相反,它只暴露了一个标准模块系统,让 Agent 能够构建完成任务的任何所需能力。
这个模块系统将 agent-wow 的复杂度降低了至少一个数量级。我最初计划创建一个完全无头的 WoW 客户端,并为 Agent 使用优化底层原语。然而,在写了 16K 行一个有问题的移动原语和一个粗糙的寻路实现后,我决定放弃,转而采用另一种方法。
在 Mindcraft 的实现中,当可用命令集不足以完成更复杂的行为时,Agent 被允许使用 Mineflayer API 生成自定义代码。我决定在 agent-wow 中遵循同样的方法,但在本例中也没有内置的游戏动作。这个系统还提供了一个很好的反馈循环,可以根据 Agent 在许多独立运行中选择的模块来弄清楚哪些原语对 Agent 真正重要。常用的模块可以随后在核心中实现。
同样值得注意的是,agent-wow 不连接到《魔兽世界》的正式服务器。所有实验都在私有本地服务器上运行,由开源 AzerothCore 项目提供支持,该项目支持 WoW 3.3.5a——巫妖王之怒的最终版本(也是 WoW 的巅峰)。
看看 Agent 如何完成这个简单的第一个任务是很有趣的。我强烈建议您浏览一下游戏录像(上面有链接),看看角色在实际运行中的表现以及 Agent 的推理过程。
关于游戏录像是如何录制的简要说明:AzerothCore 幸好有一些强大的 GM 命令可用。创建两个简单的宏来将我的视角绑定到 Agent 角色并解除绑定并不困难。
/run SendChatMessage(".gm on","SAY")
/run SendChatMessage(".gm visible off","SAY")
/run SendChatMessage(".bindsight","SAY")
/run SendChatMessage(".unbindsight","SAY")
这对于单个角色在短时间会话中效果很好,但无法扩展到更长时间范围内的多 Agent 运行。我可能需要为更好的可观测性构建一个 AzerothCore 模块和游戏内插件。
事后看来这并不令人惊讶,而且可能是最优策略。Agent 从 AzerothCore SQL 文件中提取了任务需求、任务给予者、任务交付 NPC 和生成坐标,为规划提供了具体的检查清单和位置。
利用这些数据,它还能够创建任务顺序和准备工作的最优策略。它完成前置任务链、出售垃圾物品、装备升级、在进入起始区域任务线最后洞穴段之前学习技能。它还优化为同时获取两个洞穴任务并一起完成。
这种通过数据挖掘支持将高级 prompt 翻译成具体步骤序列的策略可以说是可以接受的。这可以说类似于人类可能在 Wowhead 上花费数小时研究任务的方式。如果它能够获得正在运行的 AzerothCore 服务器和数据库的管理权限并更改其内部结构,那就是我划定底线的地方。由于这次运行不是在沙箱中完成的,它本可以做到这一点。
我最初的赌注是 Agent 会创建高级抽象,这样它就可以暴露 RPC 方法(如 moveTo 或 castSpell),以避免在低级数据包层工作。在实践中,它完全有能力在协议层工作。它制作的一个模块是发送和订阅它关心的特定数据包。
以下是它生成的 gRPC 接口和模块配置:
syntax = "proto3";
package example.module.v1;
option go_package = "github.com/agent-wow/go-module-template/src/api;modulev1";

import "api/module/v1/session.proto";
import "google/protobuf/empty.proto";

message PollRequest { uint64 after = 1; }
message Packet { uint64 seq = 1; uint32 opcode = 2; bytes payload = 3; }
message PollResponse { uint32 clock = 1; string guid = 2; repeated Packet packets = 3; }

service Module {
 rpc Send(agentwow.module.v1.SendPacketRequest) returns (google.protobuf.Empty);
 rpc Poll(PollRequest) returns (PollResponse);
 rpc OnPacket(agentwow.module.v1.WorldPacket) returns (google.protobuf.Empty);
}
api_version: 1
enabled: true
description: Gameplay protocol bridge for the Valley of Trials
compose:
  file: compose.yaml
  service: module
grpc:
  descriptor_set: module.pb
rpc:
  send: /example.module.v1.Module/Send
  poll: /example.module.v1.Module/Poll
packets:
  SMSG_LOGIN_VERIFY_WORLD: /example.module.v1.Module/OnPacket
  SMSG_UPDATE_OBJECT: /example.module.v1.Module/OnPacket
  SMSG_COMPRESSED_UPDATE_OBJECT: /example.module.v1.Module/OnPacket
  SMSG_DESTROY_OBJECT: /example.module.v1.Module/OnPacket
  SMSG_MONSTER_MOVE: /example.module.v1.Module/OnPacket
  SMSG_GOSSIP_MESSAGE: /example.module.v1.Module/OnPacket
  SMSG_QUESTGIVER_QUEST_LIST: /example.module.v1.Module/OnPacket
  SMSG_QUESTGIVER_QUEST_DETAILS: /example.module.v1.Module/OnPacket
  SMSG_QUESTGIVER_OFFER_REWARD: /example.module.v1.Module/OnPacket
  SMSG_QUESTGIVER_QUEST_COMPLETE: /example.module.v1.Module/OnPacket
  SMSG_QUESTUPDATE_ADD_KILL: /example.module.v1.Module/OnPacket
  SMSG_QUESTUPDATE_COMPLETE: /example.module.v1.Module/OnPacket
  SMSG_LOOT_RESPONSE: /example.module.v1.Module/OnPacket
  SMSG_CAST_FAILED: /example.module.v1.Module/OnPacket
  SMSG_INVENTORY_CHANGE_FAILURE: /example.module.v1.Module/OnPacket
  SMSG_QUESTGIVER_QUEST_INVALID: /example.module.v1.Module/OnPacket
  SMSG_ATTACKSWING_NOTINRANGE: /example.module.v1.Module/OnPacket
  SMSG_ATTACKSWING_BADFACING: /example.module.v1.Module/OnPacket
  SMSG_QUESTGIVER_QUEST_FAILED: /example.module.v1.Module/OnPacket
  SMSG_LEVELUP_INFO: /example.module.v1.Module/OnPacket
  SMSG_TRAINER_BUY_SUCCEEDED: /example.module.v1.Module/OnPacket
  SMSG_TRAINER_BUY_FAILED: /example.module.v1.Module/OnPacket
  SMSG_AURA_UPDATE: /example.module.v1.Module/OnPacket
  SMSG_AURA_UPDATE_ALL: /example.module.v1.Module/OnPacket
  SMSG_TRAINER_LIST: /example.module.v1.Module/OnPacket
  SMSG_INITIAL_SPELLS: /example.module.v1.Module/OnPacket
  SMSG_LEARNED_SPELL: /example.module.v1.Module/OnPacket
  SMSG_QUERY_QUESTS_COMPLETED_RESPONSE: /example.module.v1.Module/OnPacket
onPacket 订阅一组定义的服务器消息(SMSG_*)并将它们保存在内存中。然后该模块通过 agent-wow JSON-RPC 游戏服务器暴露 send 和 poll。Agent 使用 Python 脚本调用 poll 来获取自上一个处理检查点以来的所有传入数据包,并解码它们以更新其世界模型(生命值、附近生物、任务进度、战利品等)。然后使用 send 向 AzerothCore 发送客户端消息,以在游戏世界中产生动作。
看看这种方法是否能够随着越来越复杂的任务而扩展,或者 Agent 是否会被迫创建更高级的抽象,这将很有趣。如果协议层就是它所需要的,那么在核心中提供这个功能可能就足够了,甚至可以移除模块系统。
从我对着启发式机器人的研究来看,寻路始终是主要挑战之一。这篇文章提供了一些很好的见解。在这种情况下,Agent 能够用 C++ 创建一个寻路辅助程序来计算游戏中两个位置之间的可遍历路线。
接收六个数字:起始 x、y、z 和目标 x、y、z。加载 AzerothCore 的本地导航网格文件(mmaps)。使用 Detour 寻路库在连接的可遍历表面上找到路线。以坐标的 JSON 数组返回路线,或如果找不到完整路径则报告错误。Python 脚本调用编译好的可执行文件,读取生成的航点,并发送移动数据包以遵循该路线。
这是 Agent 生成的实际 C++ 辅助程序(为可读性格式化):
#include "DetourNavMesh.h"

#include "DetourNavMeshQuery.h"

#include "DetourAlloc.h"

#include <cstdio>

#include <cstdlib>

#include <algorithm>

int main(int argc, char ** argv) {
  if (argc != 7) return 1;
  const char * dir = "/azerothcore/env/dist/bin/mmaps";
  char fn[512];
  sprintf(fn, "%s/001.mmap", dir);
  FILE * f = fopen(fn, "rb");
  if (!f) return 2;
  dtNavMeshParams params;
  fread( & params, sizeof(params), 1, f);
  fclose(f);
  auto mesh = dtAllocNavMesh();
  if (dtStatusFailed(mesh -> init( & params))) return 3;
  float a[3] = {
    float(atof(argv[2])),
    float(atof(argv[3])),
    float(atof(argv[1]))
  };
  float b[3] = {
    float(atof(argv[5])),
    float(atof(argv[6])),
    float(atof(argv[4]))
  };
  int ax = int(32 - a[2] / 533.333333), ay = int(32 - a[0] / 533.333333), bx = int(32 - b[2] / 533.333333), by = int(32 - b[0] / 533.333333);
  for (int x = std::min(ax, bx) - 1; x <= std::max(ax, bx) + 1; x++)
    for (int y = std::min(ay, by) - 1; y <= std::max(ay, by) + 1; y++) {
      sprintf(fn, "%s/001%02d%02d.mmtile", dir, x, y);
      f = fopen(fn, "rb");
      if (!f) continue;
      unsigned int h[14];
      fread(h, 56, 1, f);
      auto data = (unsigned char * ) dtAlloc(h[3], DT_ALLOC_PERM);
      fread(data, h[3], 1, f);
      fclose(f);
      if (dtStatusFailed(mesh -> addTile(data, h[3], DT_TILE_FREE_DATA, 0, nullptr))) dtFree(data);
    }
  auto q = dtAllocNavMeshQuery();
  q -> init(mesh, 10000);
  dtQueryFilter filter;
  filter.setIncludeFlags(1 | 2);
  filter.setExcludeFlags(0);
  float ext[3] = {
    5,
    12,
    5
  };
  dtPolyRef ra = 0, rb = 0;
  float pa[3], pb[3];
  q -> findNearestPoly(a, ext, & filter, & ra, pa);
  q -> findNearestPoly(b, ext, & filter, & rb, pb);
  if (!ra || !rb) {
    fprintf(stderr, "No nav polygon at endpoint %llu %llu\n", (unsigned long long) ra, (unsigned long long) rb);
    return 4;
  }
  dtPolyRef polys[4096];
  int n = 0;
  q -> findPath(ra, rb, pa, pb, & filter, polys, & n, 4096);
  if (!n || polys[n - 1] != rb) {
    fprintf(stderr, "Incomplete path %d\n", n);
    return 5;
  }
  float pts[4096 * 3];
  unsigned char flags[4096];
  dtPolyRef refs[4096];
  int count;
  q -> findStraightPath(pa, pb, polys, n, pts, flags, refs, & count, 4096, DT_STRAIGHTPATH_ALL_CROSSINGS);
  printf("[");
  for (int i = 0; i < count; i++) printf("%s[%.5f,%.5f,%.5f]", i ? "," : "", pts[i * 3 + 2], pts[i * 3], pts[i * 3 + 1]);
  printf("]\n");
  dtFreeNavMeshQuery(q);
  dtFreeNavMesh(mesh);
}
这种方法的另一个有趣结果(可以在游戏录像中看到)是 Agent 还能通过可能缺少碰撞属性的墙壁进行相位穿墙。
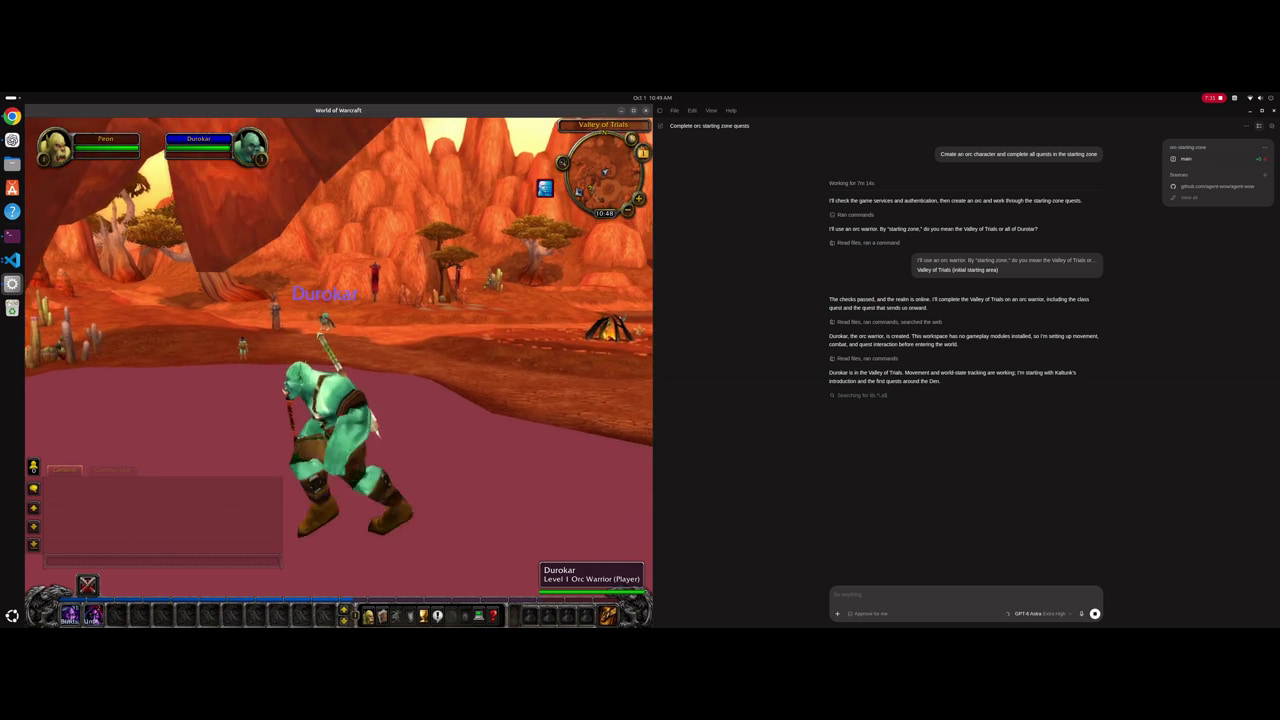
总的来说,这是使用 agent-wow 测试 LLM Agent 玩《魔兽世界》能力的一次非常令人满意的首次尝试。它超出了我的预期,让我想知道我们还能将这些模型推进多远。
对于接下来的几次运行,我特别有兴趣回答以下问题:
作为附带工作,我还将: