
8.0
热点
AI SCORE
开源项目2026-10-02 23:19
Asta 快速报告生成模型 AstaBrief 开源
Hugging Face Blog#开源#LLM#报告生成
Editor brief · 编辑速览
Hugging Face 宣布开源 Asta 中的高速报告生成模型 AstaBrief,提供模型权重与推理代码。
语言模型已经可以帮助研究人员检索文献、综合证据并处理复杂问题。但科学工作对这些模型有特殊要求——答案需要以证据为基础,模型需要保留证据实际支持的内容而不是悄悄扩大研究的结论,研究人员需要能够验证最终输出。
我们在科学家如何使用 Asta 中看到了这一点,Asta 是我们开发的科学工作智能体平台。用户通常不是简单的关键词搜索,而是带来大量背景和许多约束条件——例如,要求 Asta 在考虑特定方法、人群或环境的情况下比较一组文献中的方法。很多人还会回头使用生成的报告,将其作为工作的研究工件,而不是一次性的答案。
我们希望帮助科学家更快地生成带引用的报告,并提供一个可以下载和自行运行的模型。为此,我们测试了一个专门为科学报告生成训练的小型开放模型,看它是否能匹配我们使用的专有模型的报告质量,同时降低生成时间和 serving 成本。
我们构建了 AstaBrief 8B,这是一个将研究问题与检索到的文献摘录转化为带引用报告的模型。AstaBrief 目前已在 Asta 的 Generate a report 功能中以 Fast 模式提供,与 Claude 驱动的 Thinking 模式并列,我们也将开源它及其训练数据,以便其他人可以研究、复现和构建我们的方法。
开发 AstaBrief 需要数万个真实研究查询、聚焦引用的过滤、偏好数据,以及重新设计的报告生成管道——它一次生成完整报告,而不是逐节生成。结果是,与我们追踪的专有模型相比,报告生成时间减少了近一个数量级——在整个 Asta 管道中,Fast 模式平均每份报告 51.1 秒,而 Thinking 模式为 178.5 秒,快约 3.5 倍。
综合来看,这些效率提升使 AstaBrief 成为更广泛目标的一个有用测试案例:构建能够适应科学工作特定需求的开放语言模型。
开放权重还允许机构在自己的基础设施上运行 AstaBrief,这在研究问题涉及敏感或未发表的工作时是必要的。除了模型权重,我们还发布了一个示例工作流程,研究人员可以改编它用自己的 PDF 创建报告,为本地报告生成提供一个起点。
这篇文章涵盖了我们如何训练 AstaBrief、在科学证据中扎根方面学到了什么,以及我们认为哪些方法可以延续到未来的科学模型。大多数所述的训练和评估在 2025 年完成,因此用于生成训练数据并作为比较点的专有模型反映了当时的前沿。我们没有针对当今前沿模型重新运行完整评估;下面的结果最好理解为关于我们测试的特定训练和系统设计选择的证据。
我们开发 AstaBrief 的目标是构建一个具有对长篇科学综合最重要的所有品质的开放权重模型:答案质量、相关性、结构 和引用扎根。我们从 Qwen3-8B 起步,并将大部分精力集中在后训练数据、评估和周围报告生成脚手架上。
调整通用模型以适应科学工作——以及从头训练新的科学模型——是我们在 Ai2 广泛探索的方向。通过 NSF OMAI,这是由 Ai2 领导的美国国家倡议,旨在为科学发现构建完全开放的 AI 基础设施和模型,我们的研究人员正在直接与科学界合作,了解他们对未来开放模型的需求是什么,以及当今通用模型在哪些方面存在不足。这包括研究不同科学领域和工作流程中需求的差异,更多研究成果将在未来分享。
最近的工作,包括我们的 DR Tulu,已经表明基于强化学习的方法可以改善开放权重模型的长篇报告生成,尤其是当 judge 模型参与训练循环时。我们为 AstaBrief 考虑了这条路径,但最终专注于围绕监督微调和直接偏好优化构建的更简单方案。
基于强化学习的训练可能不稳定且昂贵。我们想看看在更便宜、更易于操作的设置下,报告生成质量能推进到什么程度——这种设置也更容易调试和迭代。
这使得训练数据的质量尤为重要。我们没有依赖更复杂的优化方法来补偿噪声样本,而是在项目的大部分时间里弄清楚如何生成、选择和过滤实际上展示了我们想要的报告撰写行为的示例。
我们还希望 AstaBrief 更快,这样用户可以快速获得初步报告,然后在后续轮次中迭代改进。为了提升速度,我们决定训练 AstaBrief 给定用户查询和相关检索片段后直接一次生成最终报告,绕过我们基于 Claude 的 Thinking 模式使用的昂贵片段摘要和聚类阶段,也不逐节写出答案。有趣的是,我们发现这样做而不牺牲性能是可能的。
收集 SFT 训练数据
训练管道从通过我们论文"Synthesizing scientific literature with retrieval-augmented LMs"和 ScholarQA 描述的系统提交的真实用户查询开始,ScholarQA 是现在支撑 Asta 的 Generate a report 功能的框架。我们不想只在合成提示或基准风格任务上训练,而是希望 AstaBrief 从真实科学家的真实查询中学习。
我们的研究表明,科学家通常对语言模型的需求与用户对通用聊天机器人或传统搜索工具的需求不同。在我们对数十万个 Asta 查询的分析中 expert 研究人员经常提供大量背景、多个约束条件以及概念之间的关系,而不是依赖简短的关键词式提示。
更最近的 Asta 用户研究也揭示了研究人员希望 AI 如何参与他们工作的差异——有些人对使用模型进行构思或实验感到自在,而另一些人则更喜欢 AI 在综合、文献监控或模式发现中扮演更窄的角色。在这些差异中,参与者希望更清晰的来源可追溯性、更清楚地了解模型正在做什么,以及对其使用的上下文有更大的控制权。
我们对我们收集的用户日志进行了质量、相关性和隐私过滤,剥离了 beta 测试者和 bot 流量,删除了太短而没有意义的查询,并使用基于 LLM 的过滤来捕获非英语查询、非科学请求和包含个人信息的提示。留下了 90K 个以研究为中心的查询池。
对于 SFT,我们使用 Asta 报告生成背后的多步 ScholarQA 管道从过滤后的查询生成了完整报告目标输出。该管道检索相关文献,将材料组织成章节,并使用支持报告生成的模型将证据综合成带引用的报告。我们依赖混合专有系统:Claude 3.5 Sonnet、Claude 3.7 Sonnet、o3、o4-mini 和 GPT-4.1。经过质量过滤后,这产生了 47K 个可用的训练示例。
DPO 需要不同类型的训练数据。我们不需要每个查询对应一个目标报告,而是需要一对报告,其中一个优于另一个。
我们从 SFT 数据生成中未使用的单独查询子集构建这些配对。每个查询的一个报告来自现有 ScholarQA 管道,通常由 Claude 3.5 Sonnet 或 3.7 Sonnet 支持。竞争报告通过将 ScholarQA 的检索文献片段提供给不同的模型生成:根据示例不同,使用 o3、o4-mini、DeepSeek-V3 或 DeepSeek-R1。
两个评判模型——GPT-4.1 和 DeepSeek-R1——对每对样本进行比较并选出优胜者。我们确保 LLM 评判与人类偏好对齐(95% 一致率),只保留两个评判都一致的样本对,这给我们提供了一个更干净的偏好数据集,削减了大量在大规模生成偏好数据时通常会出现的噪声。
经过质量筛选后,最终的 DPO 数据集约有 6K 条样本。
使用多个生成器并要求两个评判达成一致,这为我们提供了一种相对简单的方法来构建偏好数据,而不将任何单一模型的输出或判断视为标准答案。
我们的主要评估目标是 SQABench-CS2,这是一个包含 200 个用户编写的计算机科学研究问题的测试集。在 AstaBrief 的整个开发过程中,我们追踪了四个指标:
Rubric 分数,衡量报告覆盖了多少必要内容。
答案精确度,衡量每个段落是否与问题相关。
引用精确度,衡量每条引用是否支持其附加的主张。
引用召回率,衡量报告的主张是否得到所提供的引用的完全支持。
对于最终模型,我们还进行了辅助评估:DeepScholarBench,一个包含 63 个查询的长篇研究合成基准测试,来源于最近的 ArXiv 论文;以及两个独立的成对评估——与 Asta 中由 Claude 驱动的报告生成流程生成的报告进行对比——一个是在 SQABench-CS2 上的 LLM 评判比较,另一个是小规模人类研究。
一份报告可能听起来很完善且完整,同时却偏离了问题本身,或者将引用附加到了其底层证据并不支持的主张上。对于科学合成,我们需要分别衡量这些行为。但引用支持只是科学忠实度的一部分——模型可能引用了正确的研究,但仍可能做出比该研究所能支持的更强的主张。这可能以微妙的方式发生,例如,将关于特定样本的发现泛化为关于整个群体的普遍主张,将以过去时态报告的结果转换为听起来更普遍正确的现在时态陈述,或者将描述性发现转化为对临床医生、政策制定者或研究人员应该做什么的建议。
这些类型的泛化对于科学报告生成尤为重要,因为每一步都可能扩大证据的表面范围而不引入明显错误的陈述。因此,一个被引用的句子可能在技术上与其来源相关,但仍然夸大了研究人员实际确立的内容。我们的开发指标主要关注相关性、覆盖范围和引用基础;更丰富的科学报告评估器还应测试它们是否保留了其来源主张的范围和强度。
我们的首次 SFT 运行提升了整体内容质量,但在答案精确度和引用质量上仍落后于由 Claude 驱动的报告生成流程。换句话说,模型在报告撰写方面变得更好,但仍未如科学合成所需的那样始终如一地以证据为基础。
这促使我们在数据质量上投入更多时间。我们测试了四种基于统计的筛选器来识别较弱的合成训练样本:
输出与输入 token 比率。比率非常高的答案往往很嘈杂,因为它们从太少的证据中生成大量文本。
引用相关性。对于训练集中的每个合成报告,我们对其引用论文的检索相关性得分取平均值。低平均值表明该报告过度依赖排名较低的证据。
引用密度。我们衡量至少有的一条陈述的占比。低密度报告往往存在大段不支持的文本。
引用多样性。我们衡量答案中引用的论文占 Claude 驱动的报告检索流程返回集合的比例。低分表明该报告过度依赖少数几篇论文。
最显著的提升来自筛选掉引用密度低的合成报告;更激进的筛选、筛选组合和学习率扫描没有带来有意义的提升。
这是该项目最清晰的教训之一:更复杂的筛选不一定更好。一个相对简单的信号——合成报告是否始终如一地引用其主张——比我们尝试的几种更复杂的组合更有用。换句话说,科学专业化不一定是在预训练中添加更多科学文本的问题;后训练数据的组成和质量,以及它是否展示落地和归属等行为,可以实质性改变最终模型的性能。
对着陆、有用输出的关注也与我们在 Asta 用户研究中听到的相符。参与者指出,生成更多文本不一定更有帮助;他们需要简洁的合成和足够的来源可追溯性,以便审查和验证结果,而不必翻阅不必要的输出。
一旦我们有了更强的 SFT 检查点,就在它之上运行了 DPO 训练。这一阶段进一步推动了性能,使 AstaBrief 在报告生成方面达到了 Asta 中由 Claude 驱动的流程和 DR Tulu 的水平。
因为这个模型旨在作为我们代理式 Asta 报告生成框架的一部分工作(不一定作为独立模型),我们的主要问题是:AstaBrief 能否在实现显著更快、更便宜的报告生成流程的同时,保持我们关心的报告质量。换句话说,我们不只是问模型能否在单个基准测试上匹配更强的专有模型;我们想知道,用一个简单得多的系统,我们能保留多少这种质量。
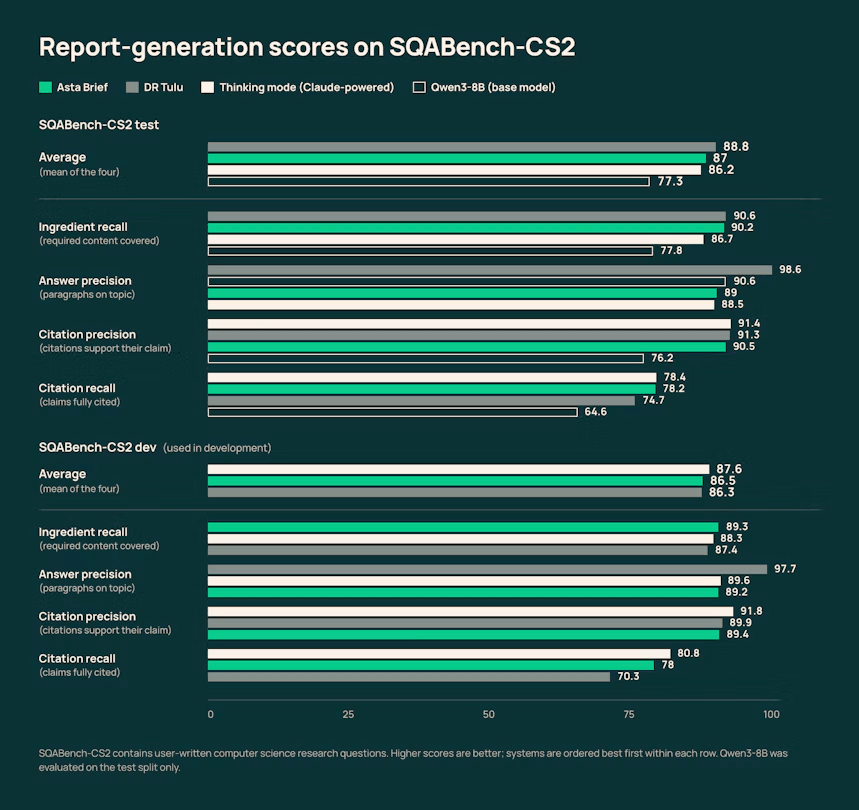
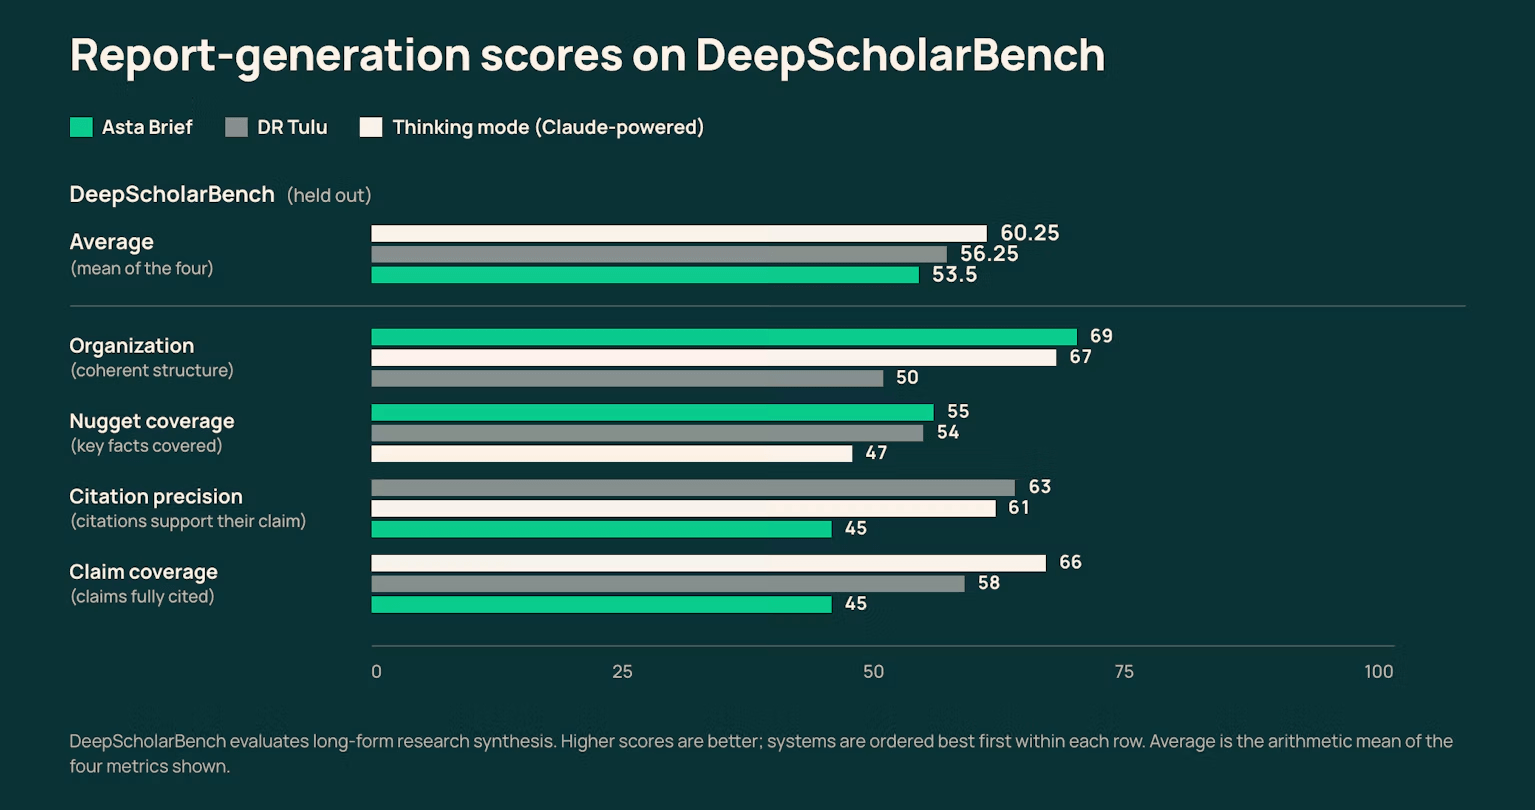
每行按最优排序;每个指标越高越好。Qwen3-8B 仅在 SQABench-CS2 测试集上评估。SQABench-CS2 是一组用户编写的计算机科学研究问题;DeepScholarBench 用自己的指标评估长篇研究合成,这些指标与 SQABench-CS2 的指标不可比。
在我们开发过程中使用的评估中,AstaBrief 在答案和引用质量的多个衡量维度上与 Claude 驱动的流程和 DR Tulu 持平。下图显示了 LLM 评判的比较——在另一项包含 14 个问题的独立人类研究中,三位科学研究人员各贡献了 4-5 个问题,并对三个系统生成的报告进行了总体偏好、完整性、相关性、组织和引用准确性排名(允许平局)。在总体偏好上,DR-Tulu 获胜,但三位研究人员中有两位在引用准确性指标上更倾向于 AstaBrief 而非其他系统,证明了我们的 SFT 数据质量筛选器的实用性。
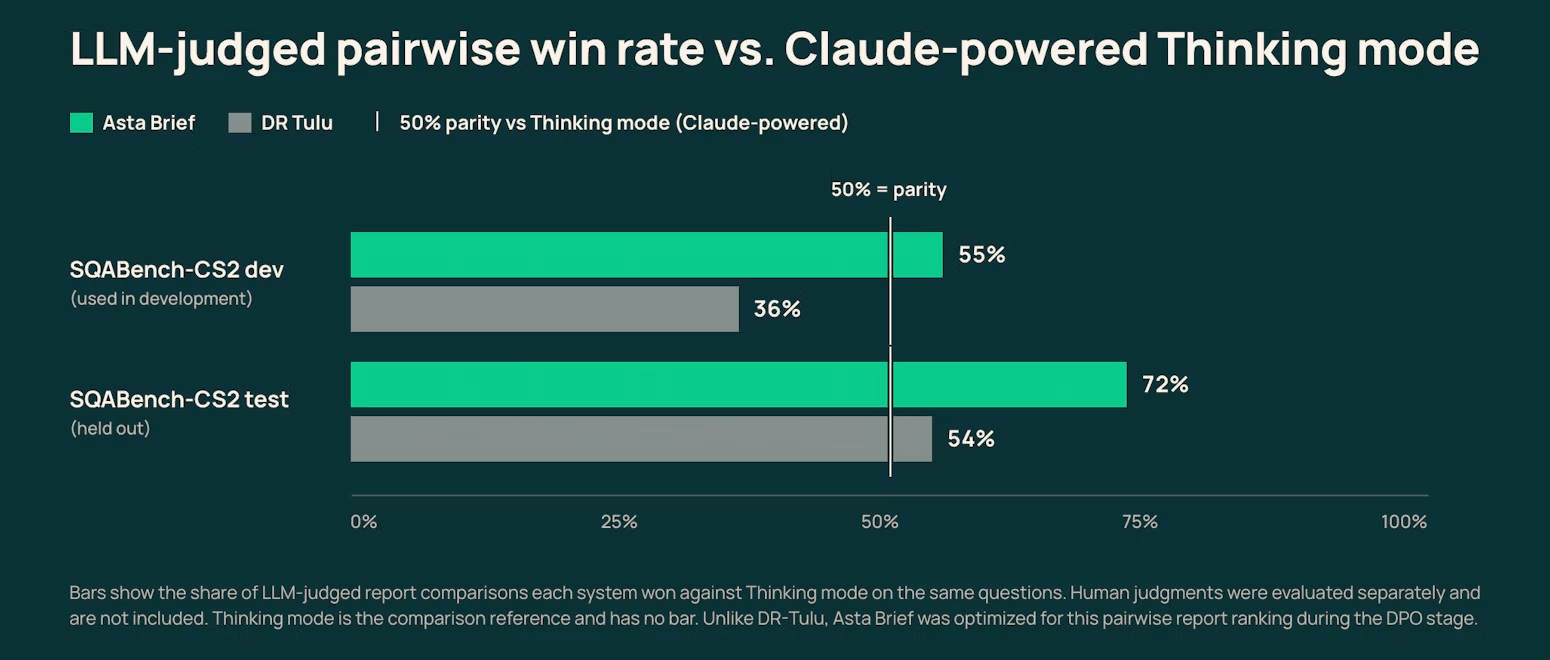
条形图显示了在同一问题上与 Thinking 模式相比,每个系统在 LLM 评判的报告比较中获胜的份额。人类判断单独评估,不包含在内。Thinking 模式是比较基准,没有条形。与 DR-Tulu 不同,AstaBrief 在 DPO 阶段针对这个成对报告排名进行了优化。
最好将这些数字读作对我们开发时工程方法的验证,而不是关于我们这个特定基础模型相对于当今前沿水平的声明。模型生态系统发展迅速——我们期望数据构建、归属筛选和服务经验这些部分能够泛化。
在 Asta 中验证 AstaBrief 的实用性,Fast 模式已显示出令人鼓舞的早期使用情况。在尝试过它的 374 名 Asta 用户中,29.1% 的用户使用了两天或以上,平均每个用户生成了 3.67 个报告线程。23% 的尝试过 Fast 模式的用户继续使用它,并在未来的线程中再也没有切换回 Thinking 模式。另外 18% 根据目标在 Fast 和 Thinking 模式之间切换,在大约 40% 的线程中使用 Fast 模式。
虽然反馈总体上过于稀疏,无法得出强有力的结论,但我们看到 Fast 模式以与 Thinking 模式相似的 rate 获得正面反馈(84.2% 对 85.2%)。
Asta 的报告生成是 AstaBrief 的第一个生产级应用,为研究人员提供了一个开放权重的 Fast 模式,与现有的 Thinking 模式并行。因为模型是开放权重的,机构可以部署在他们自己的硬件上,包括在他们自己的防火墙后面,而不依赖专有模型 API 进行报告生成。
在 Asta 中,这也意味着我们可以直接研究和改进报告生成流程的这一部分,同时保留 Thinking 模式作为更计算密集型任务的选项。
还有很多工作要做。我们正在探索更细粒度的偏好学习、更强的 RAG-plus-RL 方法、多轮对话与多工具能力、额外的科学数据源,以及查询分解。我们还对超越"某条论述是否有支持性引用"的评估感兴趣——即模型是否保留了证据范围,这既是为了更好地衡量报告作为研究产物的质量,也是为了探讨模型是否保留了其来源的证据范围。这包括简洁性和组织性等质量维度,以及模型是否将样本特定发现泛化为宽泛结论,或将描述性结果转化为建议。
AstaBrief 是我们在科学领域语言模型这条更长的研究线上的一个实验,从 ScholarQA 和 DR Tulu 到即将成形的未来版本 Olmo。此处的经验教训——尤其是围绕训练数据、过滤和评估方面的——可以为我们接下来的工作提供参考。
现在就在 Asta 中体验 Fast 模型,或从 Hugging Face 下载 AstaBrief。