
8.0
热点
AI SCORE
开源项目2026-10-02 20:50
Jev开源替代方案:五款自托管决策模型推荐
dev.to · AI#开源#决策模型#自托管
Editor brief · 编辑速览
Jev是一款结构化决策模型,发布后24小时内即出现多个开源复现,其中Laya获19k+ star、Apache协议,Kev 5.3k star,Kai为本地优先设计。
软件大多数情况下让模型做的决策都是小而重复的:把这张工单路由到哪个部门、标记这条消息、评定这个严重程度。这些调用从来不需要生成段落文字。让前沿模型生成一句话,然后立刻把它解析回 if 语句来使用,一直都是一种需求与工具不匹配的做法。
TypeSafe 于 2026 年 9 月 15 日发布了 Jev,专门做这件事而且只做这件事,然后一直保持闭源、托管化、且需要候补名单。第一个开源复现版本在约 24 小时后就出现了。AINews 在 9 月 19 日统计到两天内出现了六个克隆版本,awesome-jev 列表现在追踪着十几个。其中最大的有 19,301 个 GitHub stars,仅昨天一天就增加了 5,000 多个。
下面这五个值得你花时间了解,按 2026 年 9 月 23 日从 API 拉取的 GitHub stars 排序。其中两个我在写这篇文章时用 Apple M3 Pro 运行过。
开源阵营对 Jev 的接口复现得不错,但准确度的复现只有部分程度。
Laya(19,301 stars,Apache-2.0):基于 ModernBERT-large 的 421M 参数,T4 上每个问题 32.8–39.5 ms,一行 pip install laya 安装。基础 checkpoint 零样本得分接近随机水平,所以它是一个供微调的基础模型,不是开箱即用的替代品。
Kev(5,385 stars,Apache-2.0):Qwen3.5 的 LoRA 适配器,有 0.8B、4B 和 9B 三个规模,服务 TypeSafe 的 /v1/systemone 协议,官方 SDK 无需改动即可使用。它的新 MLX 后端在我的 Mac 上以 47 ms 响应。
SemIf(4,023 stars,MIT)不训练模型:它直接读取冻结的 Qwen3.5-4B 的 logits,在同一批 21 个决策上测量结果为 1.023 s,而生成 JSON 输出的方式需要 5.332 s。
NanoJev(2,086 stars,MIT)是一个用于实时控制循环的 0.6B 模型,在 ViZDoom Basic 上以 128/128 战胜了 Jev 的 56/128。不是通用分类器。
jevlike(1,255 stars,MIT)提供的是训练器而非模型:带上标注好的选项,在笔记本上训练一个 option-attention head。
注意事项:在独立的 49 任务分类器基准测试中,Jev 得分 0.966 宏准确率,而最佳开源参赛者只有 0.704。这些项目在延迟、价格和控制权上胜出,而不是开箱即用的准确率。
System One 模型是窄领域的,这正是它容易被复刻的原因。你给它一个状态块加上声明了答案类型的问题:一个最多 255 个选项的 Choice、有序刻度上的 Score、一个表示是/否概率的 Noul。它在一次并行传递中填满所有答案,而不是解码 token。不需要解析,不需要修复。
这个接口在 TypeSafe 的 API 文档中是公开的;模型和训练数据则不是。复现这个协议需要一个周末,因为从任何开源权重模型读取选项 logits 就能得到相同结构的答案。复现质量则是一个研究问题,一周时间远远不够。
Laya 以较大优势成为旗舰项目,也是这五个中唯一可以用一行 pip install laya 安装的。Convai Innovations 于 9 月 18 日以 Apache 2.0 发布,其 4.21 亿参数基于 ModernBERT-large 主干,顶层是一个决策头。一个 322M 的多语言 checkpoint 覆盖 100+ 语言,Router 在一毫秒内通过检测文字体系来选择语言。
公开的速度数据是 Tesla T4 上每个问题 39.5 ms,十个批量时 7.2 ms。我在 M3 Pro 上(无 GPU 加速)运行 README 的快速开始,测量 20 次运行的中位数为 66 ms,一次传递回答全部三个问题:
import laya

agent = laya.load("convaiinnovations/laya")

state = {
    "subject": "Duplicate charge on invoice #4411",
    "body": "We were billed twice for March. Please refund the duplicate today or we will cancel our plan.",
}

questions = {
    "department": {"type": "choice", "instructions": "Which department should handle this request?",
                   "criteria": {"billing": "invoices, payments, refunds",
                                "technical": "bugs, outages, system errors",
                                "sales": "pricing, new contracts"}},
    "urgency": {"type": "score", "instructions": "How urgent is this request?",
                "criteria": ["not urgent", "soon", "critical deadline or blocking issue"]},
    "churn_risk": {"type": "noul", "instructions": "Does the user threaten to cancel or leave?"},
}

res = agent.predict(state, questions)["answers"]
print(res["department"]["choice"], res["department"]["confidence"])  # billing 0.827
print(res["urgency"]["score"], res["churn_risk"]["noul"])             # 1.49 0.741
0.3.7 版本将 checkpoint 加载时间减少了约十倍,使 laya.load() 在这台机器上从 28 秒缩短到约 4 秒,并添加了 laya-serve,一个 FastAPI 服务器,使用与 Jev 相同的 POST /v1/systemone 协议。
现在是 star 数量背后隐藏的部分。Laya 的 README 异常坦诚:其基础 checkpoint 在 typed-decisions 基准上得分 0.362 和 0.342,而随机基线为 0.318、多数类基线为 0.461。头条数字 0.766(超过 Jev 公开的 0.727)来自 laya-typed-decisions——在该基准自己的训练分割上微调后得到的结果。把 Laya 看作一个你需要在自己的数据上专门微调的快速基础模型,而不是零样本替代品。它在大选项集上也较弱:在 Banking77 的 77 个标签上得 0.425,而 Jev 是 0.870,因为各选项共享一个固定的 192 到 256 token 预算,每个标签只能分到三到四个 token。
Kev 是一个系列,包括在 Qwen3.5 0.8B、4B 和 9B 基础模型上的一系列 rank-16 LoRA 适配器加一个小 pointer head,来自 Jared Palmer。它服务 TypeSafe 自己的 POST /v1/systemone 协议,所以官方 typesafe-sdk 只需改一下 base URL 就能对接。Hacker News 帖子获得了 438 分,其中很多讨论都在争论这些是否比微调过的 BERT 更好。部署和查询是这样的,在 M3 Pro 上运行:
git clone https://github.com/jaredpalmer/kev.git && cd kev
uv sync --extra serve
KEV_DTYPE=bf16 uv run --extra serve python -m kev.serve --run jaredpalmer/kev-0.8b --port 8009
curl -s localhost:8009/v1/systemone -H 'content-type: application/json' -d '{
  "state": "Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card.",
  "model": "kev-latest",
  "questions": {
    "department": {"type": "choice", "instructions": "Which team should handle this?",
                   "criteria": {"returns": "Exchanges, refunds, wrong or damaged items",
                                "shipping": "Delivery status, delays, lost packages",
                                "billing": "Charges, invoices, payment problems"}},
    "escalate":   {"type": "noul", "instructions": "Does this need urgent human attention?"},
    "frustration":{"type": "score", "instructions": "How frustrated is the customer?",
                   "criteria": ["Calm", "Frustrated", "Very angry"]}
  }}'
返回结果中 returns 概率 0.39,shipping 0.38,billing 0.24,对于一张提及全部三个主题的工单来说分布正确。Kev 于 9 月 22 日发布了 MLX 后端,在 Mac 上差别很大:同一请求从旧 PyTorch MPS 路径的 213 ms 降至全新状态的 77 ms,重复状态 47 ms(首次调用 3.2 s 之后)。
Kev 发布了这组中最认真的评估,包括它失败的地方。Kev-9B 在留出的新数据源上得 0.822,而 Jev 是 0.857;其确信错误率为 4.0%,Jev 是 3.7%;在 5% 错误预算下可自动化的决策比例为 0.45 到 0.57,而 Jev 是 0.70。知识问答是最大差距:MMLU 0.74 对比 0.90——这是基础模型的问题,不是适配器的。
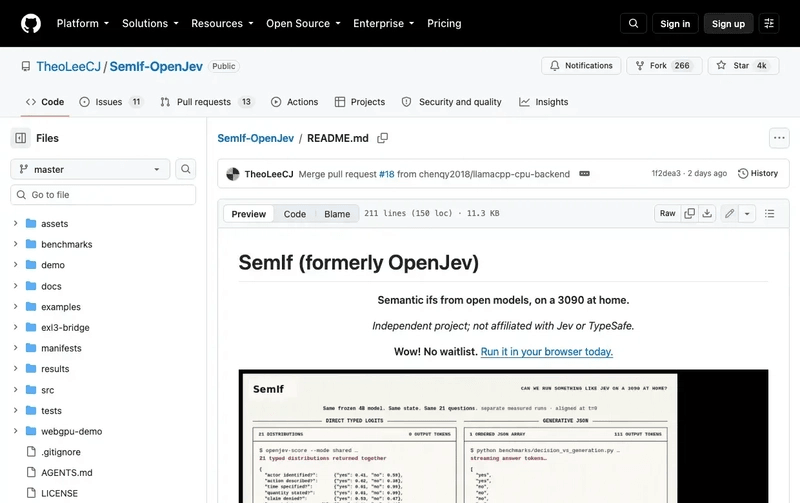
SemIf(原名 OpenJev)并不假装复现了 Jev 的模型。它复现的是这个模式:拿一个你已经在托管的冻结开源权重模型,声明你的选项,然后从 logits 中读取它们的概率,不需要采样任何一个答案 token。
它的案例建立在一张 RTX 3090、一个冻结的 Qwen3.5-4B、一个状态和 21 个二元标准上。直接读取类型 logits:1.023 s,零输出 token。同样的 21 个答案用自回归 JSON 数组:5.332 s 和 111 个输出 token,长 5.21 倍。在多个标准间复用同一个长状态可将吞吐量从每秒 2.33 个决策提升到 20.03。
质量方面,4B 基线在 102 行对齐子集上与 TypeSafe 发布的 Jev 0.883 结果达到 0.845 的众数一致,量化后的 Qwen3.8-27B bridge 在 144 个自编决策上达到 0.958 平衡准确率。Fixtures、prompt 哈希和原始计时都提交到了代码库。它需要一张能以 BF16 格式容纳 4B 模型的 GPU,但也有 llama.cpp CPU 后端、Apple Silicon 的 MLX 和 MPS,以及浏览器标签页中的 WebGPU 演示。
NanoJev 是异类,也是这里唯一明确在某件事上战胜 Jev 的项目。它是一个 Qwen3-0.6B 主干,加上在四个游戏环境中训练的决策头,目标是 TypeSafe 自己的 Doom 演示背后的控制循环场景。
在留出的测试集上,一个共享 checkpoint 在 ViZDoom Basic 上得分 128/128 成功,而 Jev 是 56/128;在更难的 Predict Position 任务上 27/128 对 11/128。它在 225 次尝试中解决了一个 50x50 的迷宫,而 Jev 需要 2,738 次。Jev 仍在迷宫测试集上以 7/10 战胜 4/10,Snake 上双方 8/8 平手。
正确理解这个结果:这是一个在四个游戏的 18,760 个决策问题上训练并在那四个游戏上评估的模型,权重和数据集在 Hugging Face 上以 unified-games-v1 标签托管。这有力证明了 0.6B 专用训练模型可以在紧凑循环中超越前沿决策 API,但没有证据表明它能分流你的工单。推理脚本需要 CUDA,所以目前没有 Apple Silicon 路径。
jevlike 不是模型,是一份配方。架构一句话就能说完:每个选项变成一个查询向量,该查询在上下文 token 上做注意力,共享点积对每个选项-上下文对评分,在选项上做 softmax 得到分布。默认编码器从零开始学习字节嵌入,或者你可以把头接到任何冻结的 Hugging Face 编码器上。
你的数据是每行一个 JSON 对象:{"context": "...", "options": [...], "label": 0},训练循环是 CPU、MPS 或 CUDA 上的四个命令。评估打印 top-1 准确率、校准误差,以及一个打乱上下文的对照组——将每个菜单与错误的上下文配对,这是大多数项目跳过的基线。
当选项是你自己的时,它是正确的选择:内部路由类别、产品分类、一组 playbook 动作。如果你是今天下午就需要一个能用的东西,它是错误的选择,而且作者坦言:发布的国际象棋 checkpoint 以 0/50 输给 level 0 的 Stockfish,默认字节编码器将上下文截断到 192 字节。
上述每个项目都在自己选择的基准上自称胜过 Jev,而且每个都在自己的基准上赢了。有用的数字来自别处。jabr 分类器基准运行 49 个任务和 869 个案例,涵盖合规、分流、法律、DevOps、语言学和安全:
在域外任务上有 26 分的差距,每个项目都记录了独特的失败模式:Von 在陌生领域崩溃为单一模式,GLiNER2 在关键词上过度触发,Laya 压缩了评分量表。注意 Von(546 stars,Apache-2.0,ModernBERT-Large)尽管在 stars 上远低于 Laya,却领先于开源阵营——提醒我们 stars 衡量的是关注度,不是准确率。在域内,经过在你自己的标签上微调后,开源模型是有竞争力的。域外且零样本,还差得远。
Kev、SemIf、Von 和现在的 Laya 都暴露了一个绑定到本机 IP 的 HTTP 端点,这在你自己用没问题,直到外部的东西需要调用它:一个 staging 应用、一个向分类器推送的 webhook、一个检查路由的队友、或一个将小决策发送到廉价模型的路由器。用 Pinggy 可以一条命令给它一个公开的 HTTPS URL:
ssh -p 443 -R0:localhost:8009 free.pinggy.io
这在迁移期间很重要,因为选择这些模型的正确方式是让真实流量同时镜像两边:将生产 webhook 的副本指向隧道,记录开源模型会怎么决定,然后与 Jev 的实际答案比较。一个注意事项:两个服务器默认都是开放的,所以在暴露之前设置 KEV_API_KEY 或 LAYA_API_KEY 要求 bearer token。
从托管的 Jev 调用到自托管的最短路径:用 Kev:wire API 匹配,你的代码不需要改。如果你已经在运行一个开源权重模型:用 SemIf,直接读你已有模型的 logits。如果想要一个小型的、CPU 友好、有多语言覆盖、且会微调的:用 Laya。如果你的决策在紧凑的控制循环内:NanoJev 是这里唯一有该延迟级别证据的项目。如果你的标签集异常到没有预训练 checkpoint 能帮上忙:jevlike 在笔记本上训练一个。
另外三个值得收藏:OpenJev 运行 DiffusionGemma 26B-A4B,是唯一一个能回答图像问题的;openjev-sglang 在 B200 级硬件上用 SGLang 提供 Qwen3.6-35B-A3B 服务;Von 在独立基准测试中领先。
开源生态大约用一天复现了 Jev 的接口,此后的整个星期都在努力复现其准确率。在延迟、价格和控制权上它已经全面胜出:在你自己的 CPU 上跑一个 421M 编码器调用成本为零,在我测试的笔记本上响应时间 66 ms。在零样本、域外质量上还不行,而且当有人称这些为开箱即用的替代品时,0.966 对 0.704 是需要记住的数字。
所以选择部署场景与你相符的那个,在几百个你自己的标注样本上微调它,调整置信度温度,然后拿它和你现在运行的对比。这些项目才刚满一周,变化快到数字一天就会过时,所以把每个公开数字——包括供应商的——当作假设而非结果,这和自托管模型的一般性谨慎态度相同。