
9.0
重磅
AI SCORE
编程提效2026-10-02 14:26
2026 Agent上下文工程四原则
dev.to · AI#Agent#上下文工程#Anthropic
Editor brief · 编辑速览
基于Anthropic官方指引和2026年论文,总结出指针优于载荷、渐进披露、宁少勿多、时效性至上四条原则。
四个原则在 2026 年各独立来源中反复出现:
指针,而非载荷。 在窗口中保留引用,需要时再加载重型内容。
渐进披露。 按任务深度逐步揭示细节,而非一次性全部展示。
少而精。 超过某个阈值后,更多上下文反而降低准确率,不仅仅是增加成本。
新鲜度是一种特性。 过时的上下文不会安静地待着,它会主动误导智能体。
模型窗口扩展到了 200K-1M token,条件反射是把它填满。这个条件反射本身就是 bug。
我们不只有一个仓库。我们有多个服务,每个服务都有自己的 CLAUDE.md。在生产环境中,这同时给我们带来了两种失败模式:
膨胀。 一个根目录 CLAUDE.md 大约 238 行,每次请求都完整加载。你修复了某个子系统中的一个测试,智能体仍然会拉取三个相邻子系统的 schema、配置和迁移笔记——而它根本不会接触这些。
腐化。 有些工程师忘记更新上下文文件。有些根本从不更新。文件与代码渐行渐远,开始对智能体撒谎。
下面这张图是我们希望在第一天就有的。
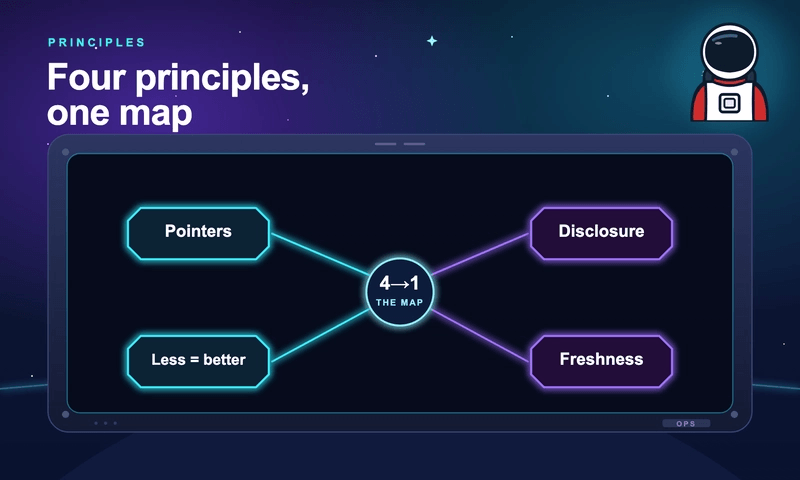
这里把整个领域收进一张表。每个原则都来自独立来源:厂商指导、学术基准测试、以及得出相同结论的生产工具。
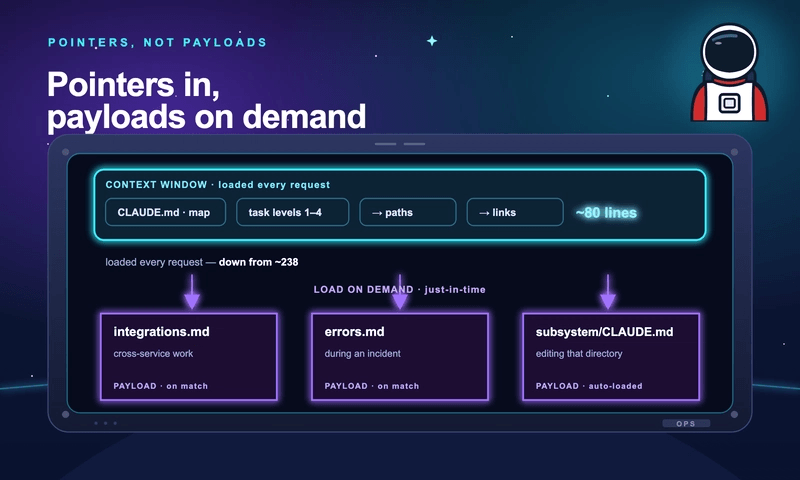
四个原则不是四个技巧。它们是从四个角度看同一个理念:窗口应该持有引用并路由到细节,而不是吞下整个仓库。
你可能见过标题党版本:苏黎世联邦理工学院的研究"证明上下文文件不起作用"。读一下实际论文(arXiv:2602.11988),会发现它说的是更尖锐的东西,而且它并不与上述共识矛盾。它恰好符合这个框架。
对成功率的影响在两个方向上都不显著。LLM 生成的文件将解决率移动了 -0.5%(SWE-bench)和 -2%(CTXbench),两者 p 值都很高(0.87、0.37)。开发者提交的文件平均提高了 +2.4%,比生成的文件更好(p=0.038),但仍然不是显著的绝对增益(p=0.21)。唯一一个效果确凿的是:上下文文件使推理成本增加了 20-23%(p<0.001)。
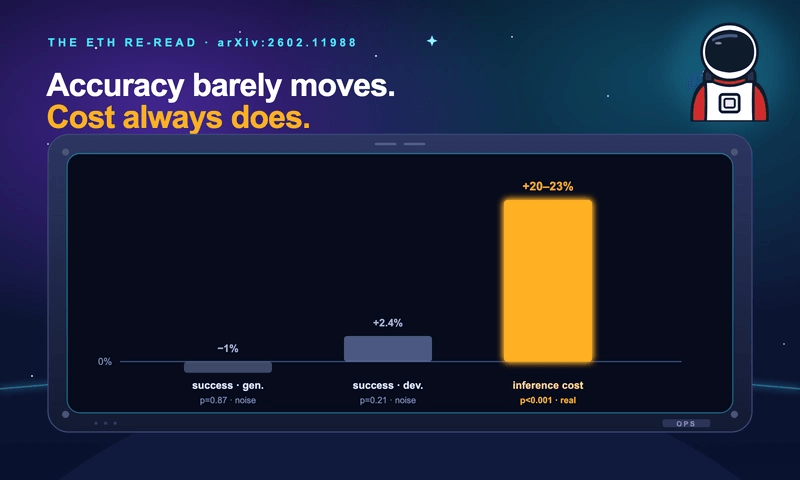
所以诚实的结论不是"文件有害"。而是:
上下文文件很少让智能体更聪明。它可靠地让智能体多花 20%+ 的成本。解决办法不是"写一个更好的文件"。而是"停止为加载不需要的载荷而付费"。
这是怀疑论者重述的原则 #1。如果额外上下文不能换来准确率,就保持窗口精简,按需加载。筛选优于生成,但廉价优于两者。
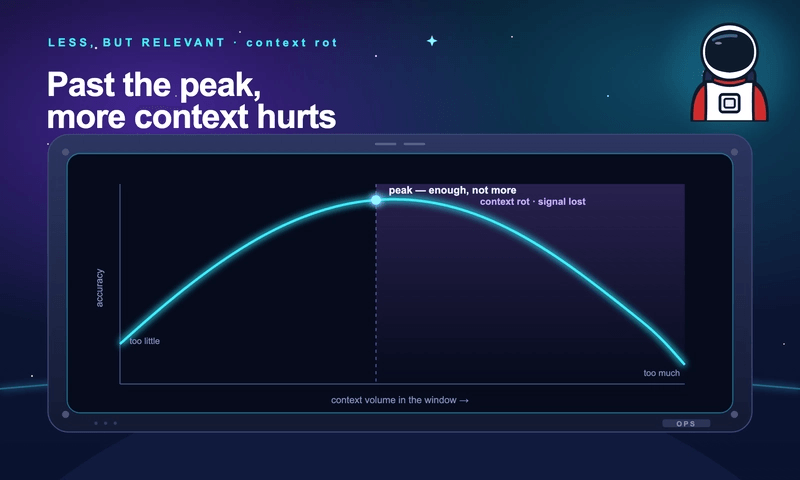
曲线不是平的。准确率爬升、达峰、然后随着窗口持续增长而下降。上下文越长,模型退化越严重(它甚至提前放弃搜索)。这就是上下文腐化(arXiv:2606.29718),它是"少而精"背后的机制。
地图只有在你知道站在哪里时才有用了。以下是共识在真实仓库布局中的样子:指针在上,按需加载载荷。
# Root context = a map, not a manual (loaded every request, keep it thin)
# Expected effect: the agent reads ~80 lines of pointers, not ~238 of payload

<service>/
├── CLAUDE.md            # navigation map + task complexity levels  (POINTERS)
├── docs/context/
│   ├── integrations.md  # loaded only for cross-service work       (PAYLOAD)
│   ├── errors.md        # loaded only during an incident           (PAYLOAD)
│   └── systemPatterns.md# loaded only when adding a component       (PAYLOAD)
└── internal/<subsystem>/
    └── CLAUDE.md        # auto-loaded when editing this directory  (PAYLOAD)
映射回四个原则:
💡 上下文经济学:prompt 缓存 vs 即时加载。 指针节省 token,但 prompt 缓存只奖励稳定前缀(通常高达 90% 的缓存 prompt token 折扣)。把窗口分成两个区域:
热区头(缓存核心): 系统 prompt、规则,以及每个指针或技能的紧凑索引位于窗口最开头,保持缓存状态。
冷区尾(动态): 重型载荷在运行时加载,位于窗口末尾,针对特定请求。
你在基础上下文上保持完整折扣,而不使其膨胀。
这不是免费的:
得有人手工写地图。ETH 发现筛选过的文件优于生成的文件(p=0.038),而生成的内容转储只会增加成本。
渐进披露多了一步:某人(智能体或作者)得判断任务有多难。
精简地图只有在详情文件存在且没有腐化时才有效。所以新鲜度(原则 #4)不能靠良好意愿来保证。它需要自动化。
我们没有发明任何这些。我们读了四份独立来源,它们说了同样的事情,并据此构建了无聊但正确的布局。
唯一需要记住的事:这不是一堆互不关联的黑客技巧。独立来源得出了相同的东西。厂商指导、学术基准测试和生产工具都达到了相同的四条规则:指针优于载荷、按深度披露、少而精、以及把新鲜度作为一等特性。
这改变了工作方式。你不是在猜测 CLAUDE.md 的行数。你是在应用一份有文献记录的共识,唯一真正的问题是:你自己的仓库里用得有多好。
本系列其余部分就是这项工作,一个原则接一个:已经存在的工具图景、编码指针和披露的文件结构、"少"对质量和对账单的影响、以及防止地图腐化的机制。
"它起作用了"的生产数据在系列后面。先看地图。
延伸阅读
Anthropic: effective context engineering / just-in-time context (Anthropic Engineering; "Equipping agents with Agent Skills")
Progressive disclosure: arXiv:2607.17598
Repo-map benchmarks: RepoGraph (arXiv:2410.14684); Repository Intelligence Graph (arXiv:2601.10112); Aider repo map
Less-but-relevant: "Less Context, Better Agents" (arXiv:2606.10209); "The Complexity Trap" (arXiv:2508.21433)
Context rot: arXiv:2606.29718; redis.io/blog/context-rot
Doc-drift: "Impressive, But Wrong"; SkillGuard (arXiv:2605.10990)
ETH Zurich: "Evaluating AGENTS.md" (arXiv:2602.11988)