
8.0
热点
AI SCORE
技术实践2026-10-02 12:01
AutoSynthData:企业Agent训练数据合成
Hugging Face Blog#数据生成#AI训练#HuggingFace
Editor brief · 编辑速览
Hugging Face发布的合成数据生成方案,帮助企业构建高质量Agent训练数据集。
企业需要在其自身环境中表现出色的 AI 智能体。他们要求这些智能体完成的工作由所使用的系统、遵循的规则及其数据的状态所塑造。一个模型可能具备广泛的能力,但仍会在特定环境中遇到困难:处理不佳的工作流程、误用的工具组合,或未能遵守的约束。这些正是企业需要改进的薄弱之处。
难点在于将这些薄弱之处转化为训练数据。一次单独的失败能告诉我们一些信息,但训练一个模型需要许多新的任务来在不同情况下练习相同的能力。这些任务还必须能够在该环境中完成、类似于用户实际会提出的请求,并有可靠的方法来检查智能体是否成功。
在 ServiceNow CoreAI,我们构建了 AutoSynthData 来将能力差距转化为训练数据。它利用目标模型的失败和更强教师的成功来决定模型下一步应该学习什么,然后生成并验证新的任务来练习这些能力。随着模型改进,课程重点转向它仍然感到困难的内容。我们用 EnterpriseOps Gym(Malay et al., 2026)来说明这条流水线,使用已发布的数据集。我们首先描述智能体所操作的环境以及什么使一个任务对训练有用。
什么是有用的智能体任务?
智能体环境定义了智能体所操作的世界:它可以观察和修改的状态、可以调用的工具和 API,以及其操作产生的状态转换。
任务在此环境中被实例化。我们使用以下抽象:
task = (system specification, user prompt, verifier)
系统规范定义了智能体操作的约束条件,包括系统指令、环境策略,以及适用的任务特定初始化,如种子数据库状态或一组知识文章。
规范必须与环境的工具、状态和支持的操作兼容。其指令应清晰,避免引入仅为制造难度而设置的人为约束。
用户提示指定用户希望智能体完成什么,以及任何用户级约束。生成的任务应满足三个属性。
可行性。在当前环境中应存在至少一条轨迹,在遵守系统规范的同时满足用户提示。这排除了依赖于不可用工具、不可访问知识、无法实现的状态转换或被策略禁止的操作的任务。
真实性。用户提示应类似于用户在目标环境中可能会提出的请求。可执行行为的搜索空间通常远大于现实工作流程的搜索空间。
难度。对于训练,任务应暴露当前智能体的薄弱之处。已经被可靠解决的任务几乎不提供新的训练信号。因此有用的区域是那些可行且真实,但尚未被一致解决的任务。
验证器判断结果轨迹是否成功完成了任务。它应满足三个属性。
一致性。它应与用户提示、系统规范和任务特定的环境状态保持一致。
可靠性。它应拒绝未能满足任务或违反相关约束的轨迹。
完整性。它应接受有效的解决方案,而不是编码某一条特定的参考轨迹。
这些属性在训练中直接发挥作用。宽松的验证器可能奖励错误行为,而过于严格的验证器可能惩罚有效解决方案。
给定一个环境和目标模型,AutoSynthData 生成由系统规范、用户提示和验证器组成的训练任务。生成的任务以环境为基础,并被选择来为当前模型提供有用的训练信号。
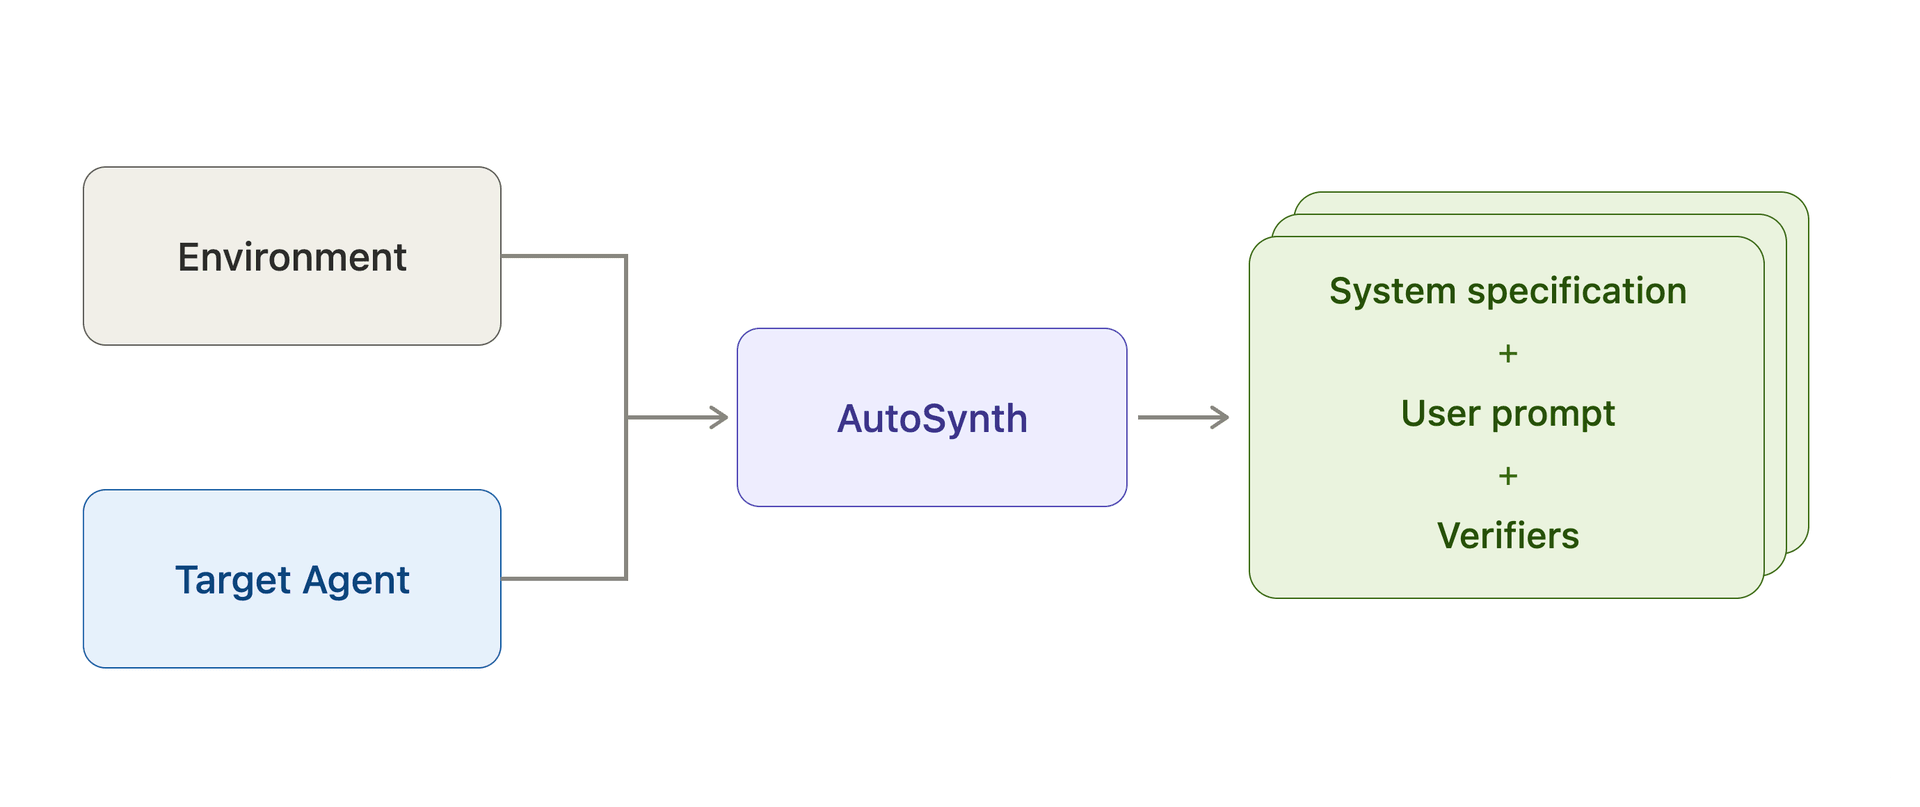
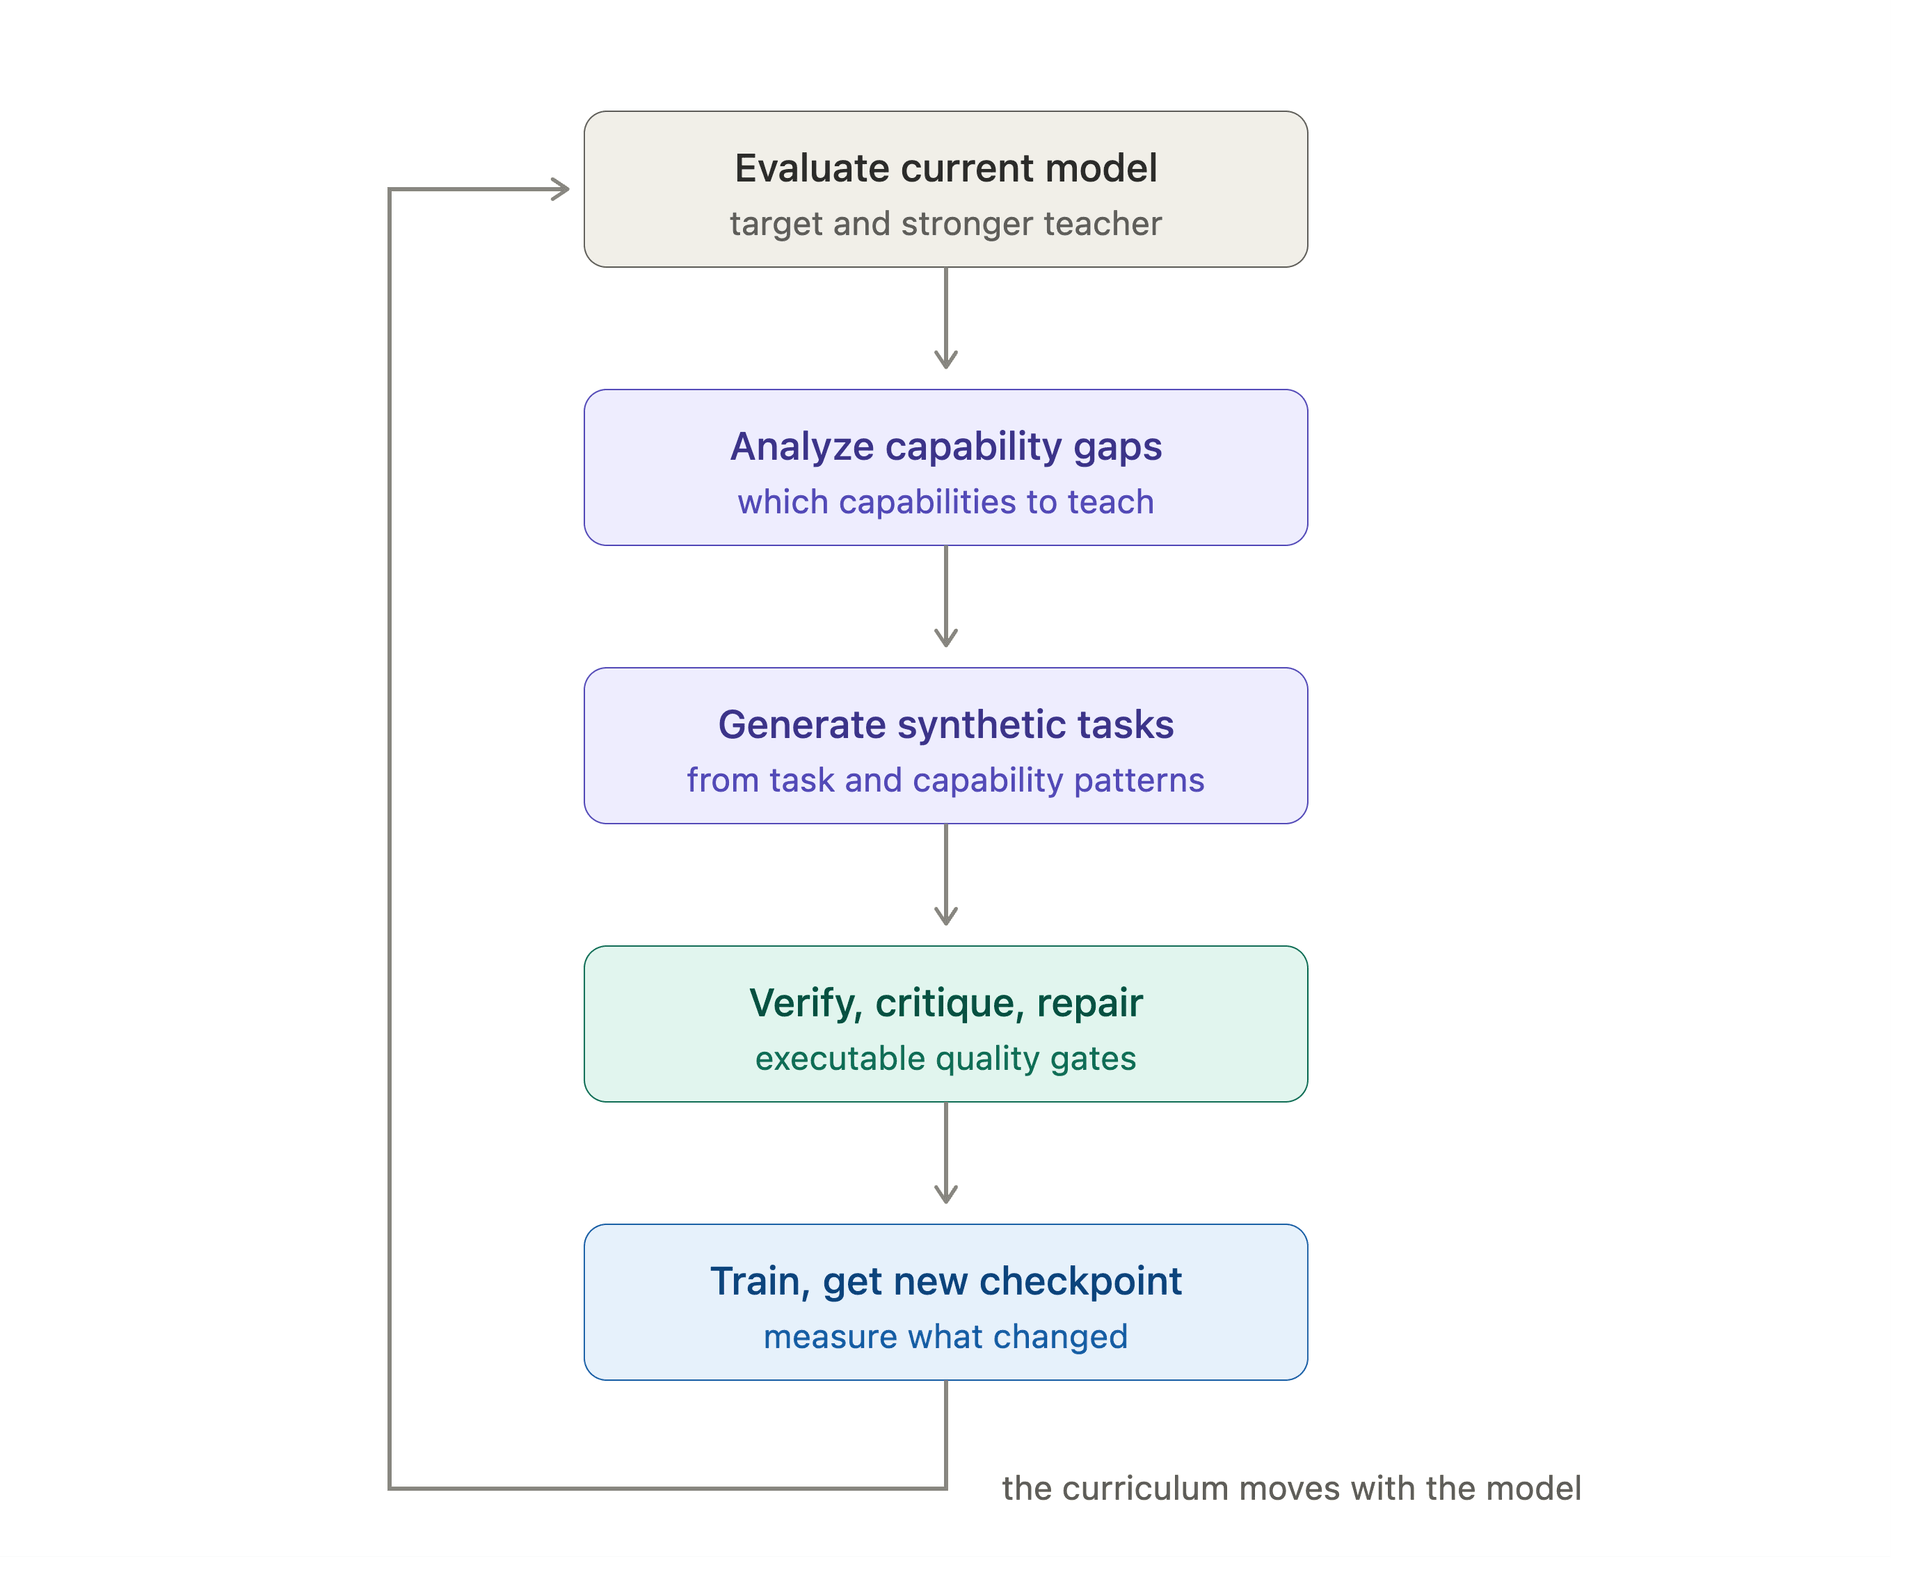
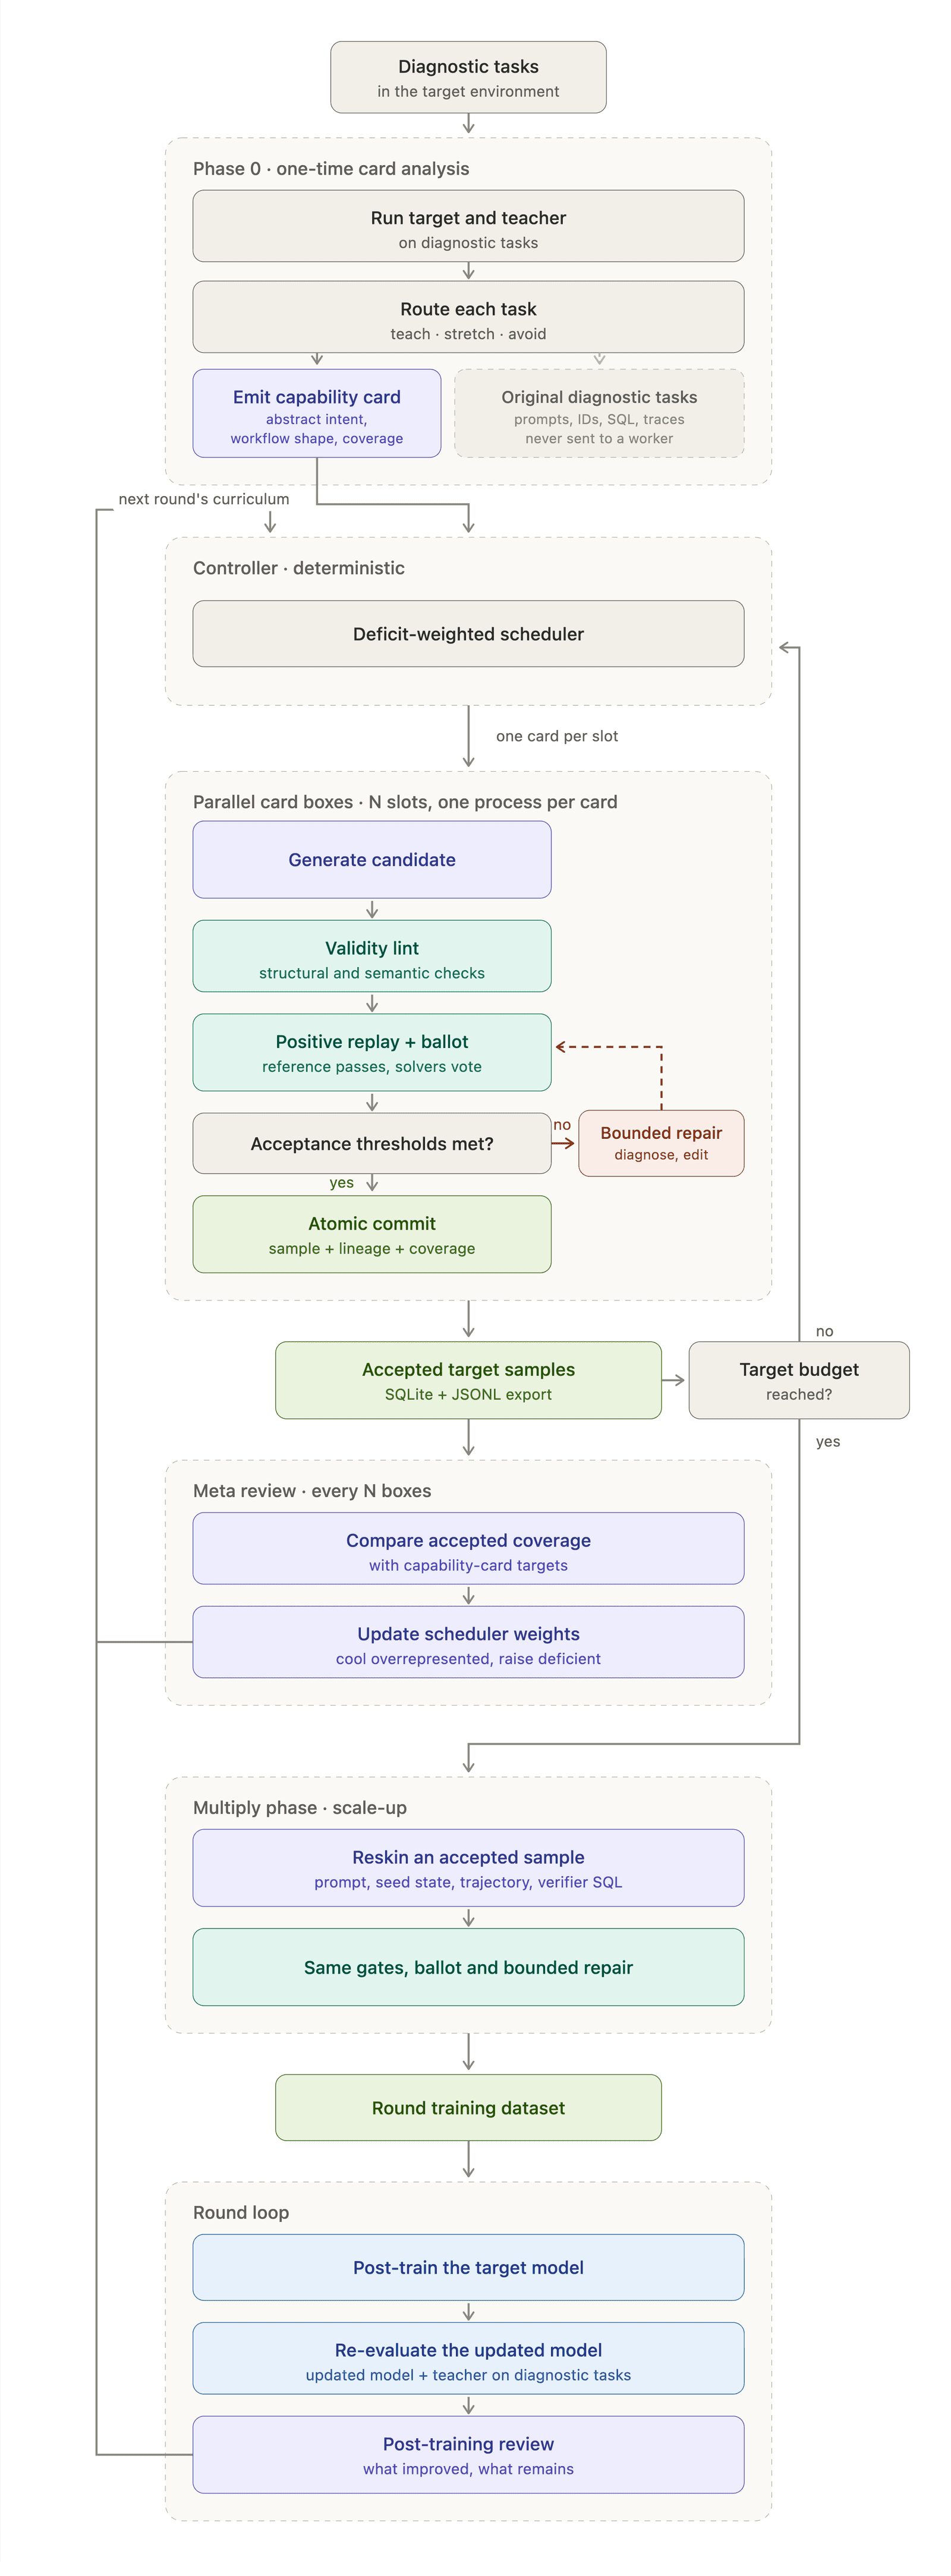
AutoSynthData 首先使用诊断任务在环境中评估目标模型,并识别它难以完成的任务模式。更强的教师帮助描述这些任务中哪些是可解决的,以及成功的表现是什么。AutoSynthData 将由此产生的能力差距转化为新的可执行任务,在环境中检查每个任务,并使用接受的样本进行训练后评估。评估更新后的模型可以揭示哪些差距仍然存在,并指导下一轮生成。
从模型失败到课程
AutoSynthData 使用目标环境中的评估运行来识别模型需要学习什么。在我们的 EnterpriseOps Gym 实验中,我们在评估任务上运行目标模型和更强的教师。我们检查这些运行以识别:
被测试的能力;
所涉及的工具和工作流程结构;
目标模型失败的地方以及教师如何成功;
正确最终状态必须满足的属性;
在保留被测试能力的同时可以变化的维度。
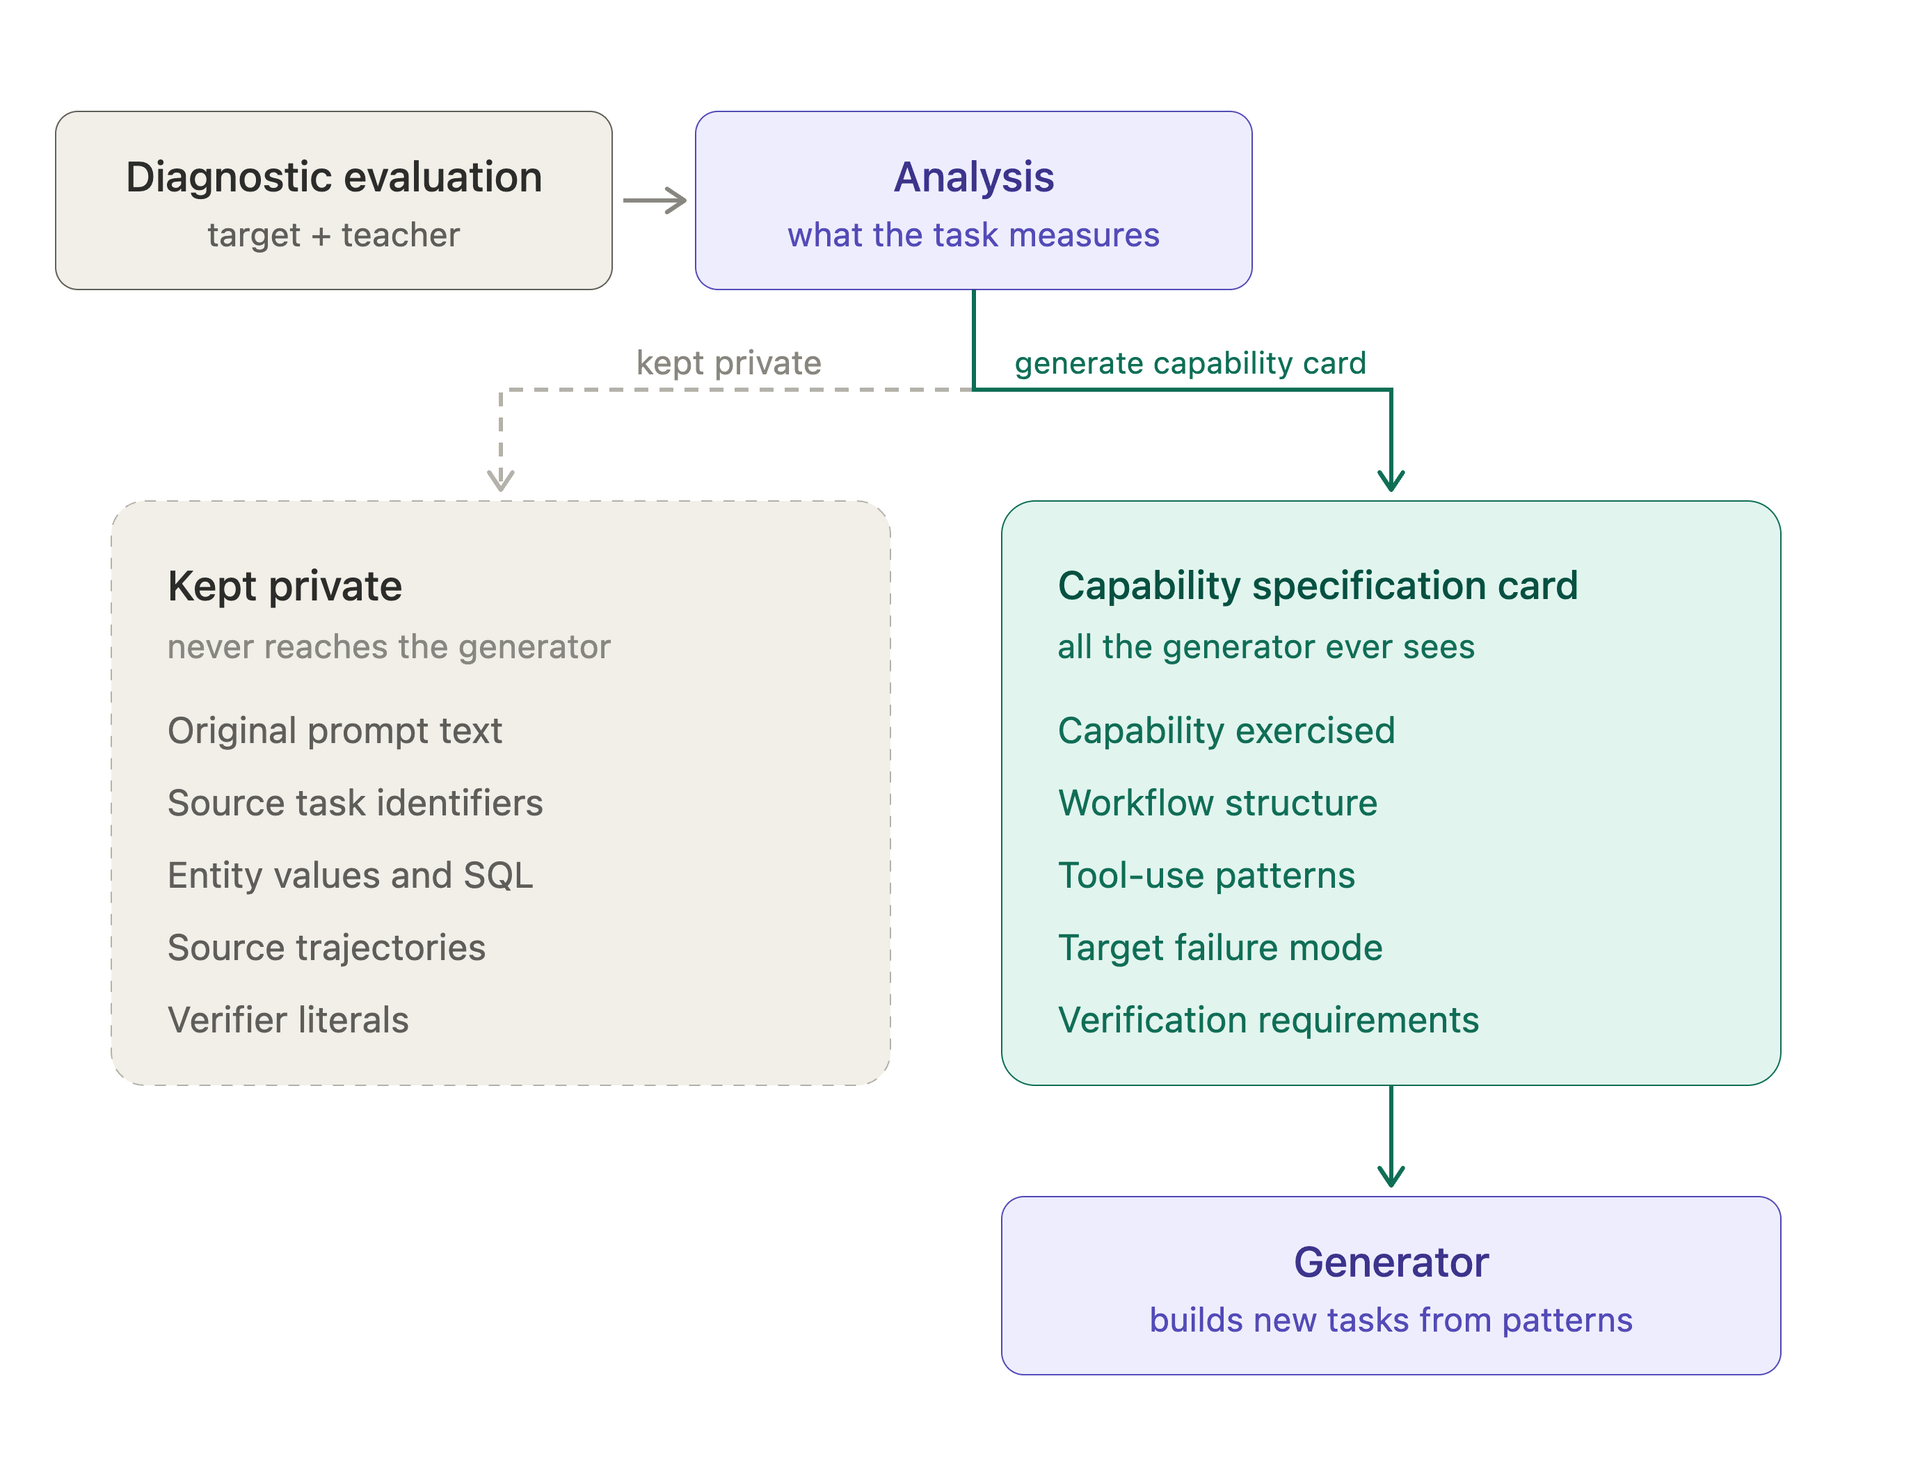
我们将这些发现提炼成经过清理的能力规范卡。评估任务指导模型应该学习什么,但生成器不会收到它们的原始提示、实体、轨迹或验证器细节。它接收这些卡片,并使用它们来创建具有不同提示、状态和解决路径的新任务。
生成和扩展任务
识别能力差距告诉我们应该教什么,但训练需要许多多样化的任务来练习它。AutoSynthData 使用规范卡来生成这些任务。
假设目标模型在需要以下工作流程的任务上遇到困难:
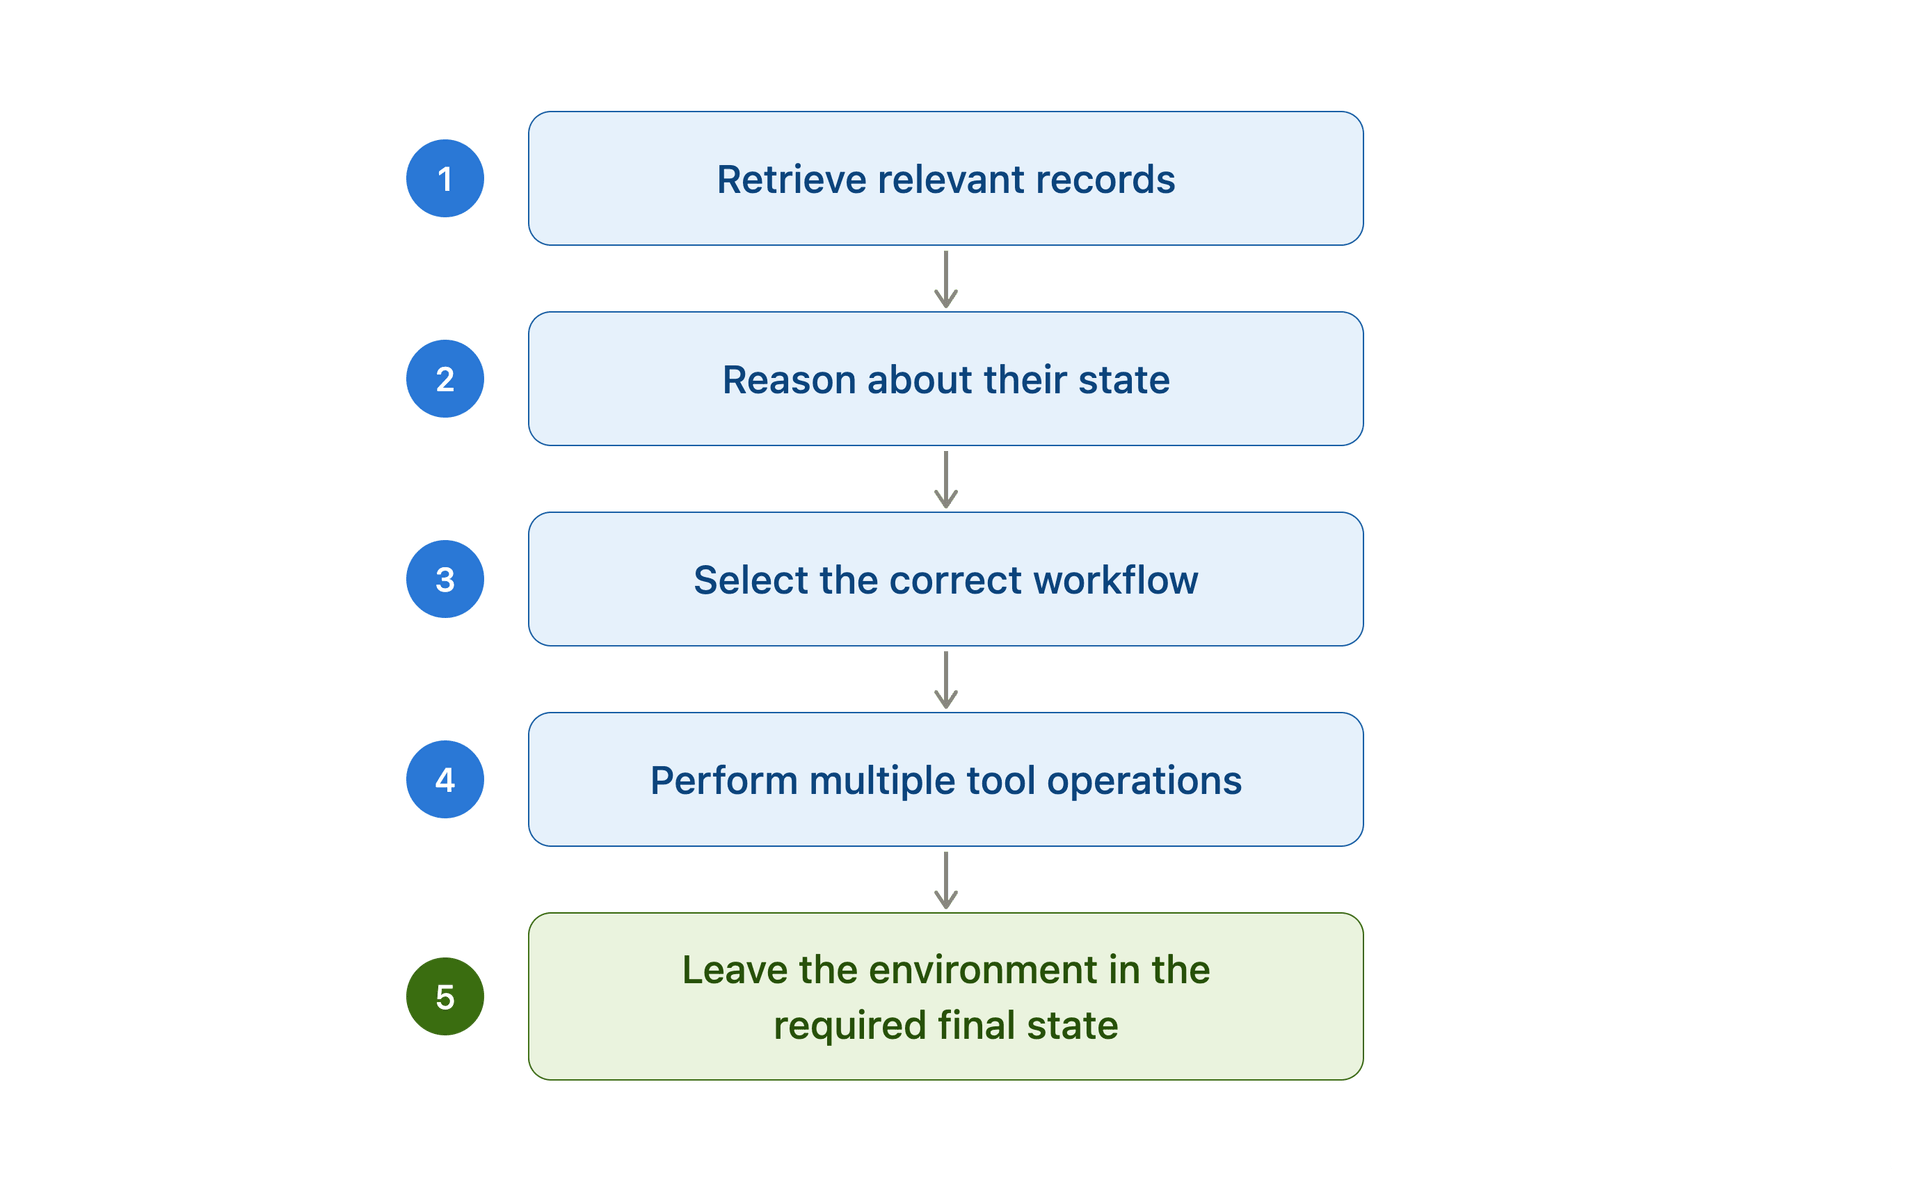
生成器创建练习此工作流程的新任务,改变实体、初始环境状态、工作流程组合、工具组合、措辞和难度。然后更强的教师为每个任务演示成功的轨迹。对于监督微调(SFT),这些示范教目标模型如何在新的情况下应用该能力。
AutoSynthData 分两个阶段构建数据集:首先生成并验证核心样本,然后将它们扩展为新颖的变体。
目标阶段从能力规范创建核心训练样本集。工作人员并行生成独立任务,完成后拾取新的目标。每个候选都要经过验证、执行、求解器评估和修复后才能被接受。结果是一批围绕目标模型需要学习的内容而审查过的示例。
倍增阶段通过创建已接受目标样本的新颖变体来扩展数据集。每个变体都有自己的用户请求、环境状态、实体配置、参考轨迹和验证器,并且必须通过相同的验证和执行检查。倍增样本不能成为另一个倍增样本的种子。这将扩展锚定在经过审查的目标集上,并限制跨代漂移。
实现细节
为支持这两个阶段,AutoSynthData 将生成控制与特定于环境的执行分离。共享控制器协调生成、质量控制、覆盖率和数据集构建,而适配器处理环境执行、任务和状态管理、参考回放、确定性验证、求解器执行和任务分析。
Together, parallel target generation and multiplication provide a path to training-scale datasets. Their usefulness depends on the checks applied to every candidate: the task must be executable, the solution must work, and the verifier must distinguish success from failure.
高质量合成数据不仅仅是生成
生成一个看似合理的请求不足以产生有用的训练数据。任务可能在目标环境中无法实现,其参考解决方案在执行时可能失败,或其验证器可能奖励错误的最终状态。AutoSynthData 在接受任务进行训练之前检查这些属性。
AutoSynthData 在两个级别审查质量:单个候选必须通过验证,批次必须提供有用的覆盖率和多样性。
样本级验证和修复
每个候选样本在进入训练数据集前必须通过质量控制环。我们从求解器评估开始,衡量任务难度。在此处使用的配置中,我们倾向于目标模型在三次尝试中最多解决一次、而更强的求解器在三次尝试中至少解决两次的任务。候选样本还需经过正向验证、负向验证和有限次数的修复流程。
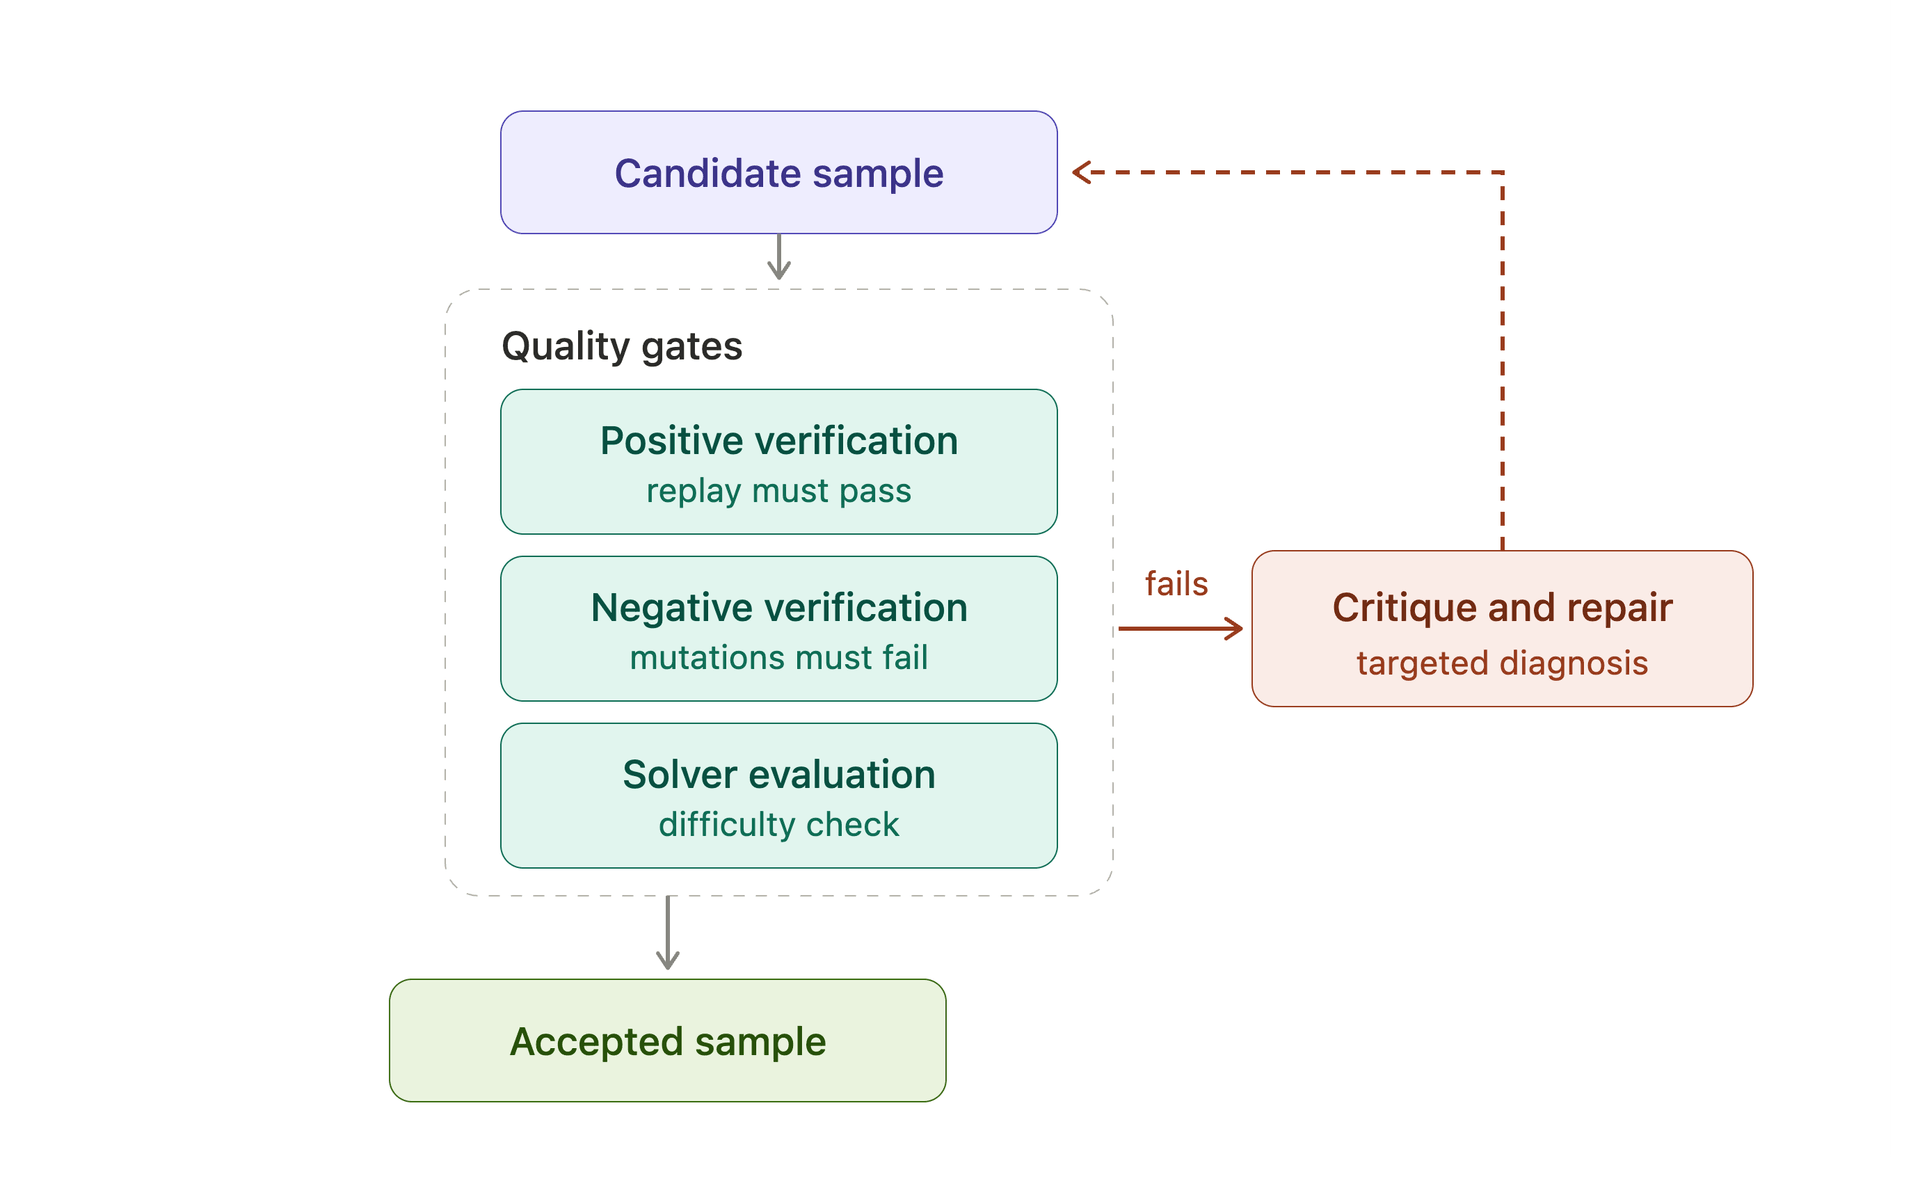
正向门槛问的是:预期解决方案是否解决了生成的任务?
流程在目标环境中执行参考轨迹,并用候选验证器检查结果状态。这揭示了提示词、初始状态、解决方案和成功标准之间的不一致。
负向门槛问的是:相关错误结果是否会失败?
例如,它可以变异预期结果的部分内容,并确认这些状态不再通过验证。这能捕捉到那些即使未要求预期行为也给予成功的弱验证器。
失败的候选样本在被丢弃前会经过评审器检查。评审器审查样本及其失败原因,寻找不一致的状态、不可能的工作流、错误的任务构建、有问题的参考轨迹、弱的验证器逻辑,或与预期能力的不匹配。评审器的发现指导修复工作,并有固定的迭代次数上限:
候选样本
↓
失败
↓
评审 / 诊断
↓
针对性修复
↓
再次运行各个门槛
↓
接受或重试
修复后的任务必须再次通过相关检查。诊断结果指导对现有候选样本的修复,而非从头开始生成。
通过这些检查的样本才有资格用于训练,但个别有效的样本仍可能形成重复或不平衡的数据集。因此 AutoSynthData 也在批次层面审查生成结果。
一个批次可能过度代表少数简单任务家族,可能遗漏某些能力,或者反映在低产出模式上花费了过多生成精力。
元评审审查每个批次中已接受的样本、被拒绝的样本和生成行为。它问:
哪些任务家族被过度代表,哪些能力维度缺失?
同样的例子是否反复出现?
特定目标是否持续生成失败?
评审中是否出现系统性问题?
下一批次应做哪些调整?
控制器追踪已接受数据集中的覆盖率,减少过度代表区域的生成,并将更多工作引向缺口区域。当某个区域反复产生差的候选样本时,评审和元评审指导生成策略的调整。这些调整在可用生成预算和数据集规模要求内,平衡有用的学习信号、任务质量、覆盖率、多样性和低冗余。
这些反馈循环共同改进单个任务及其形成的数据集:样本级检查指导候选修复,而批次级审查指导未来生成。
有用的训练分布会随着模型改进而变化。AutoSynthData 将合成数据生成视为在目标模型能力边界附近搜索任务:难度足以暴露弱点,但可解决性足以让教师提供可靠的演示。
后训练后,我们在相同环境中评估更新后的模型。它现在能可靠解决的任务对下一轮训练用处不大;持续失败则指向仍需关注的能力。这些结果可以指导下一轮生成。
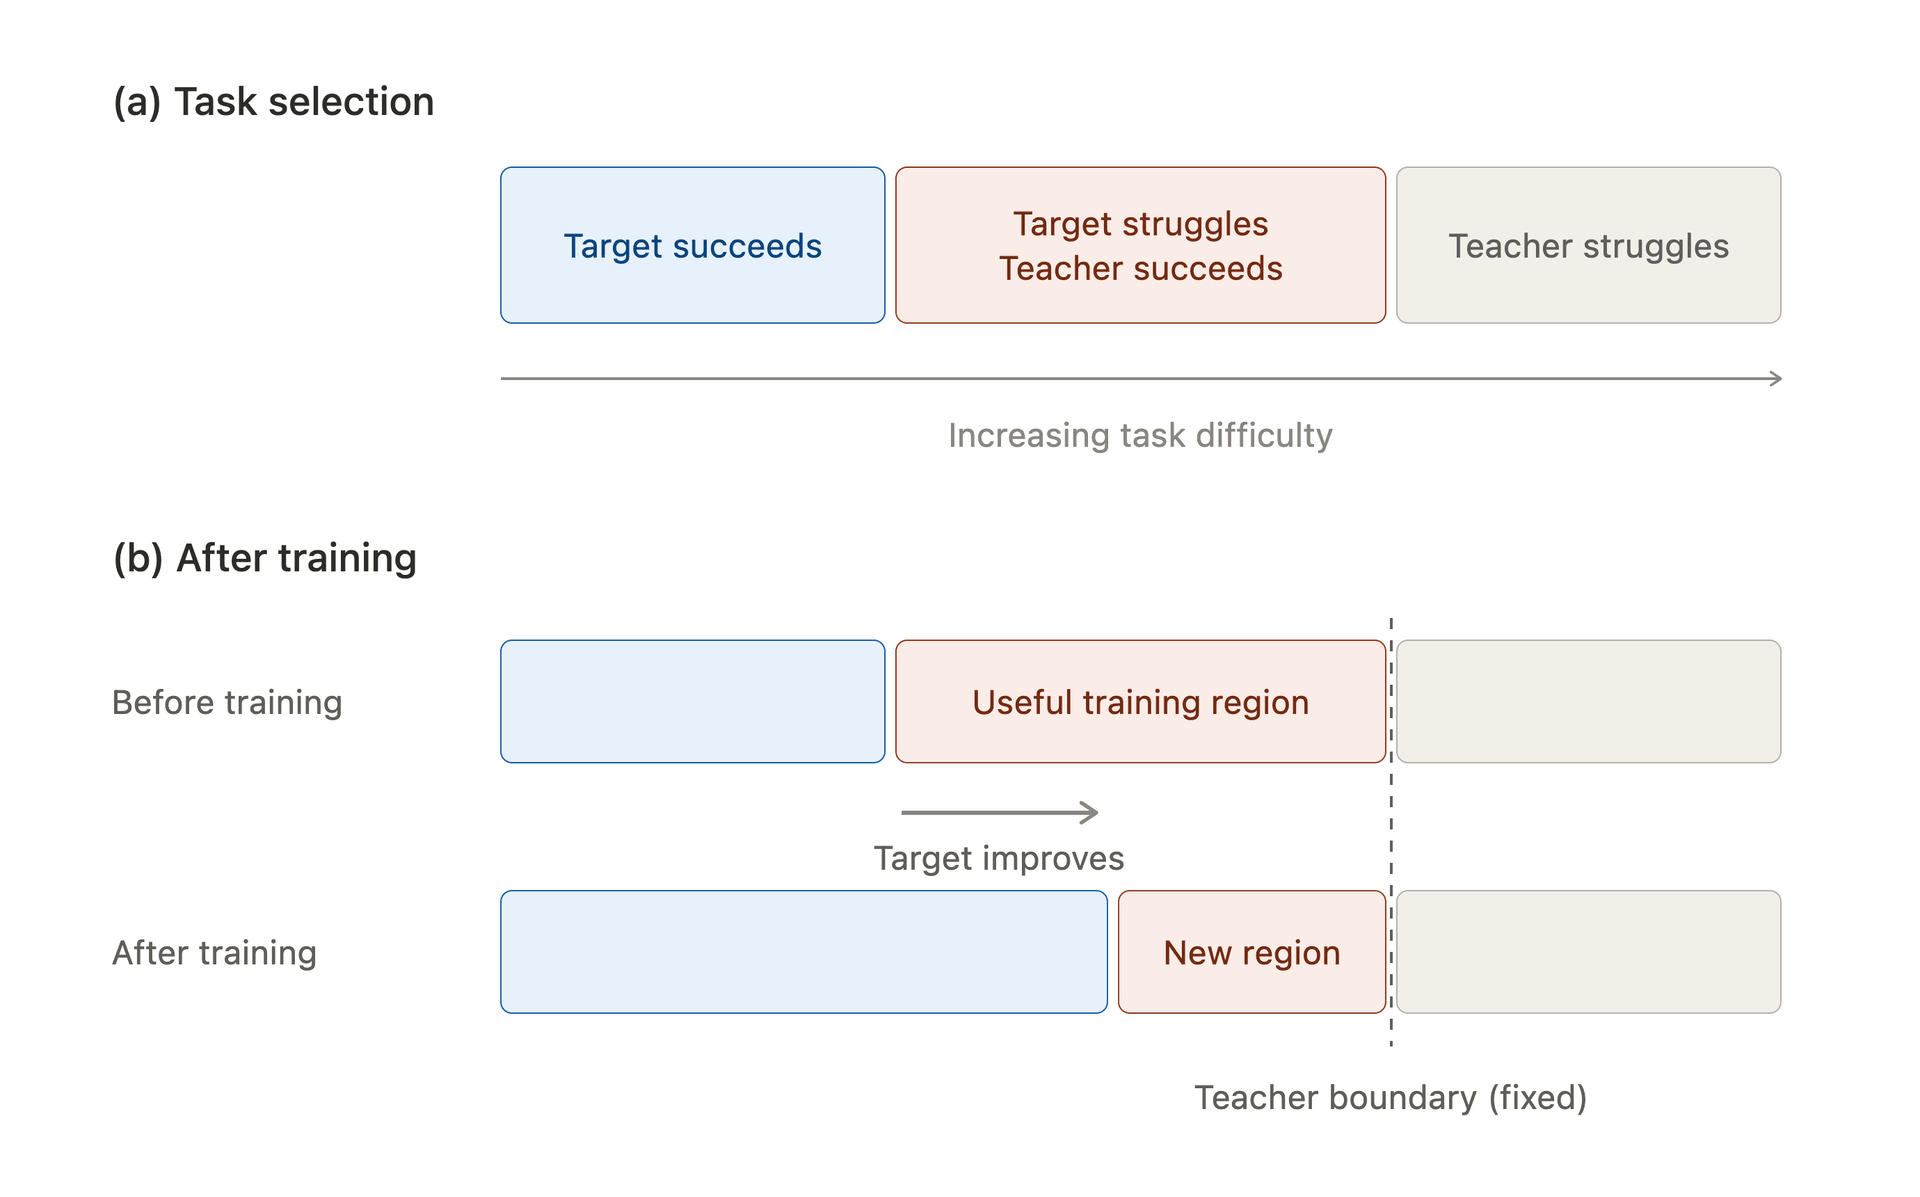
我们的实验聚焦于 SFT,但相同机制也可以支持强化学习(RL):生成挑战当前策略的任务并提供可靠的学习信号,训练,然后用更新后的策略移动生成目标。我们计划在 SFT 之外测试这种移动的难度校准前沿。
我们使用 EnterpriseOps Gym 测试这种方法是否能在有状态的企业环境中改进模型在任务上的表现。我们在 Gym 的 Hybrid 和 ITSM 环境中生成训练任务,在接受的样本上微调目标模型,并评估产生的检查点。
我们使用 Gemma-4-26B-A4B-it 作为目标模型、Qwen3.8-27B 作为教师,在 EnterpriseOps Gym 的 Hybrid 领域测试了流程。AutoSynthData 在约 18 小时内生成了 2000 个合成训练样本。我们在由此数据集上对 Gemma 进行了微调,并在基准测试上评估产生的检查点。最佳检查点是第 5 个 epoch。
合成 SFT 检查点将平均 Pass@1 提高了 7.2 个百分点,相对改进达 35%,并将验证器成功率从 63.01% 提升至 68.55%。它弥补了 Gemma 与参考模型之间原始 Pass@1 差距的 59%。
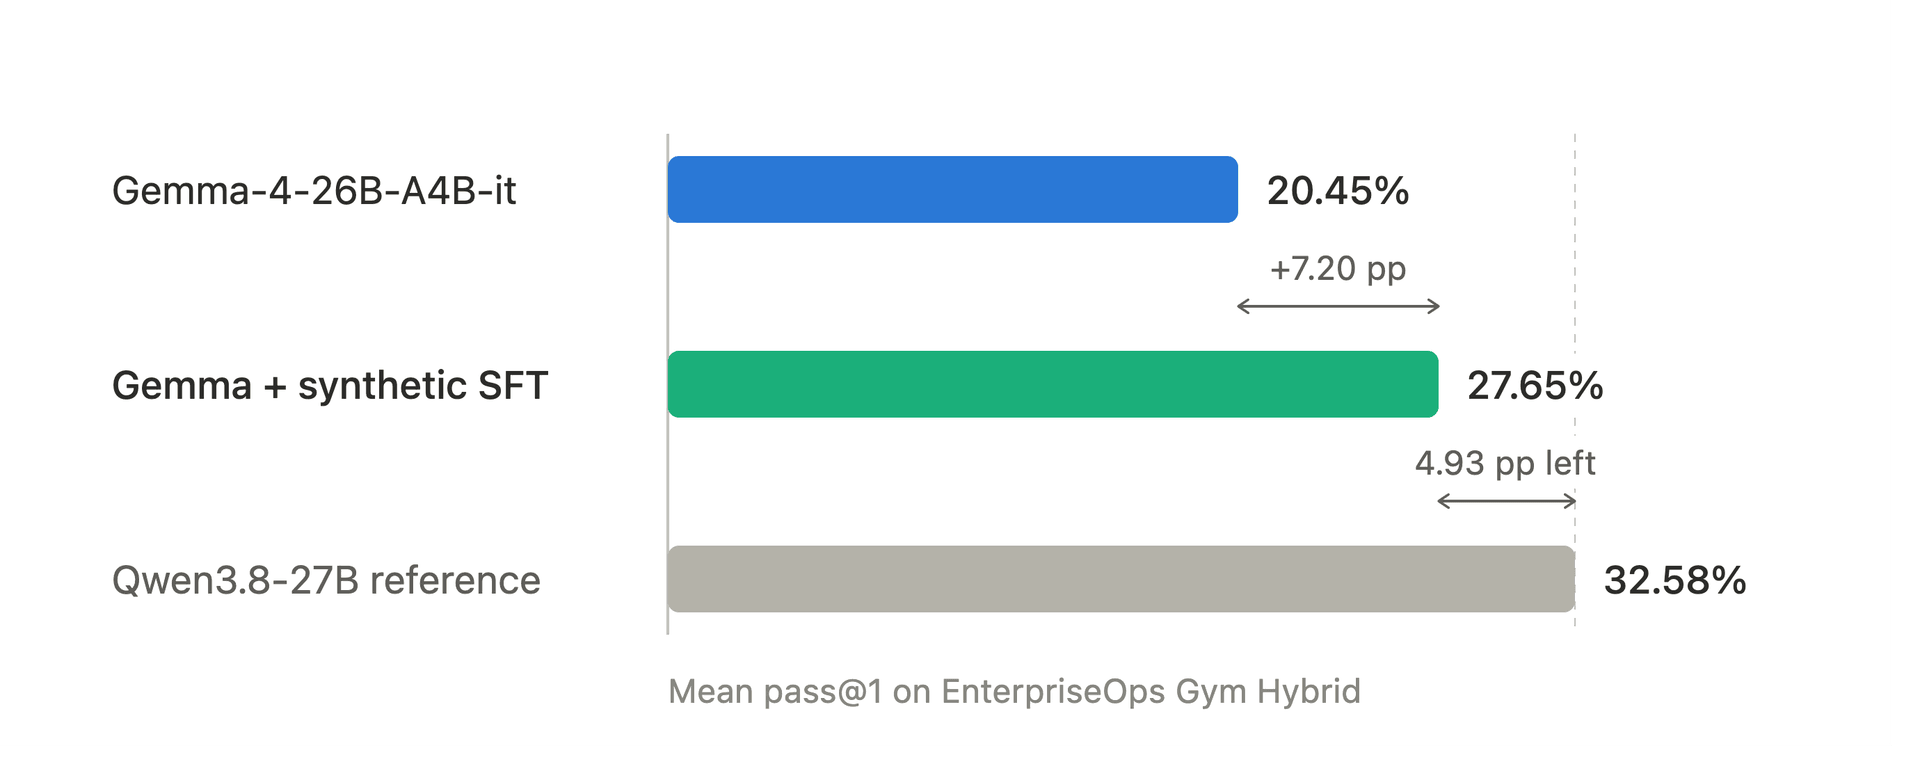
训练任务是从能力规格新生成的;生成器未收到原始评估任务。结果展示了在 EnterpriseOps Gym Hybrid——即本实验使用的环境中的改进。
我们还将 AutoSynthData 应用于 EnterpriseOps Gym 的 ITSM 领域,使用 Gemma-4-26B-A4B-it 作为目标模型、DeepSeek-V4.1-Flash 作为教师。AutoSynthData 在 66 小时内生成了 1994 个合成训练样本。生成时间比上述后续 Hybrid 运行描述的时间更长,主要是因为 ITSM 运行使用了更大的教师模型,且发生在提高吞吐量的流程优化之前。
在 ITSM 上,合成 SFT 将平均 Pass@1 从 18.77% 提升至 27.18%,表明该方法在第二个领域中也提升了性能。

对训练最有用的任务取决于环境和工作于其中的模型。AutoSynthData 使用模型的失败来选择生成内容,根据环境验证新任务,并使这些任务可用于后训练。我们的 EnterpriseOps Gym 结果在受控环境中展示了这种方法的价值。随着模型变化,相同的过程可以聚焦于剩余的差距。